❌

Vue lecture

Fedora Linux 45 est enfin disponible !

En ce mardi 3 novembre, les utilisateurs du Projet Fedora seront ravis d’apprendre la disponibilité de la version Fedora Linux 45.

Fedora Linux est une distribution communautaire développée par le projet Fedora et sponsorisée par Red Hat, qui lui fournit des développeurs ainsi que des moyens financiers et logistiques. Fedora Linux peut être vue comme une sorte de vitrine technologique pour le monde du logiciel libre, c’est pourquoi elle est prompte à inclure des nouveautés.
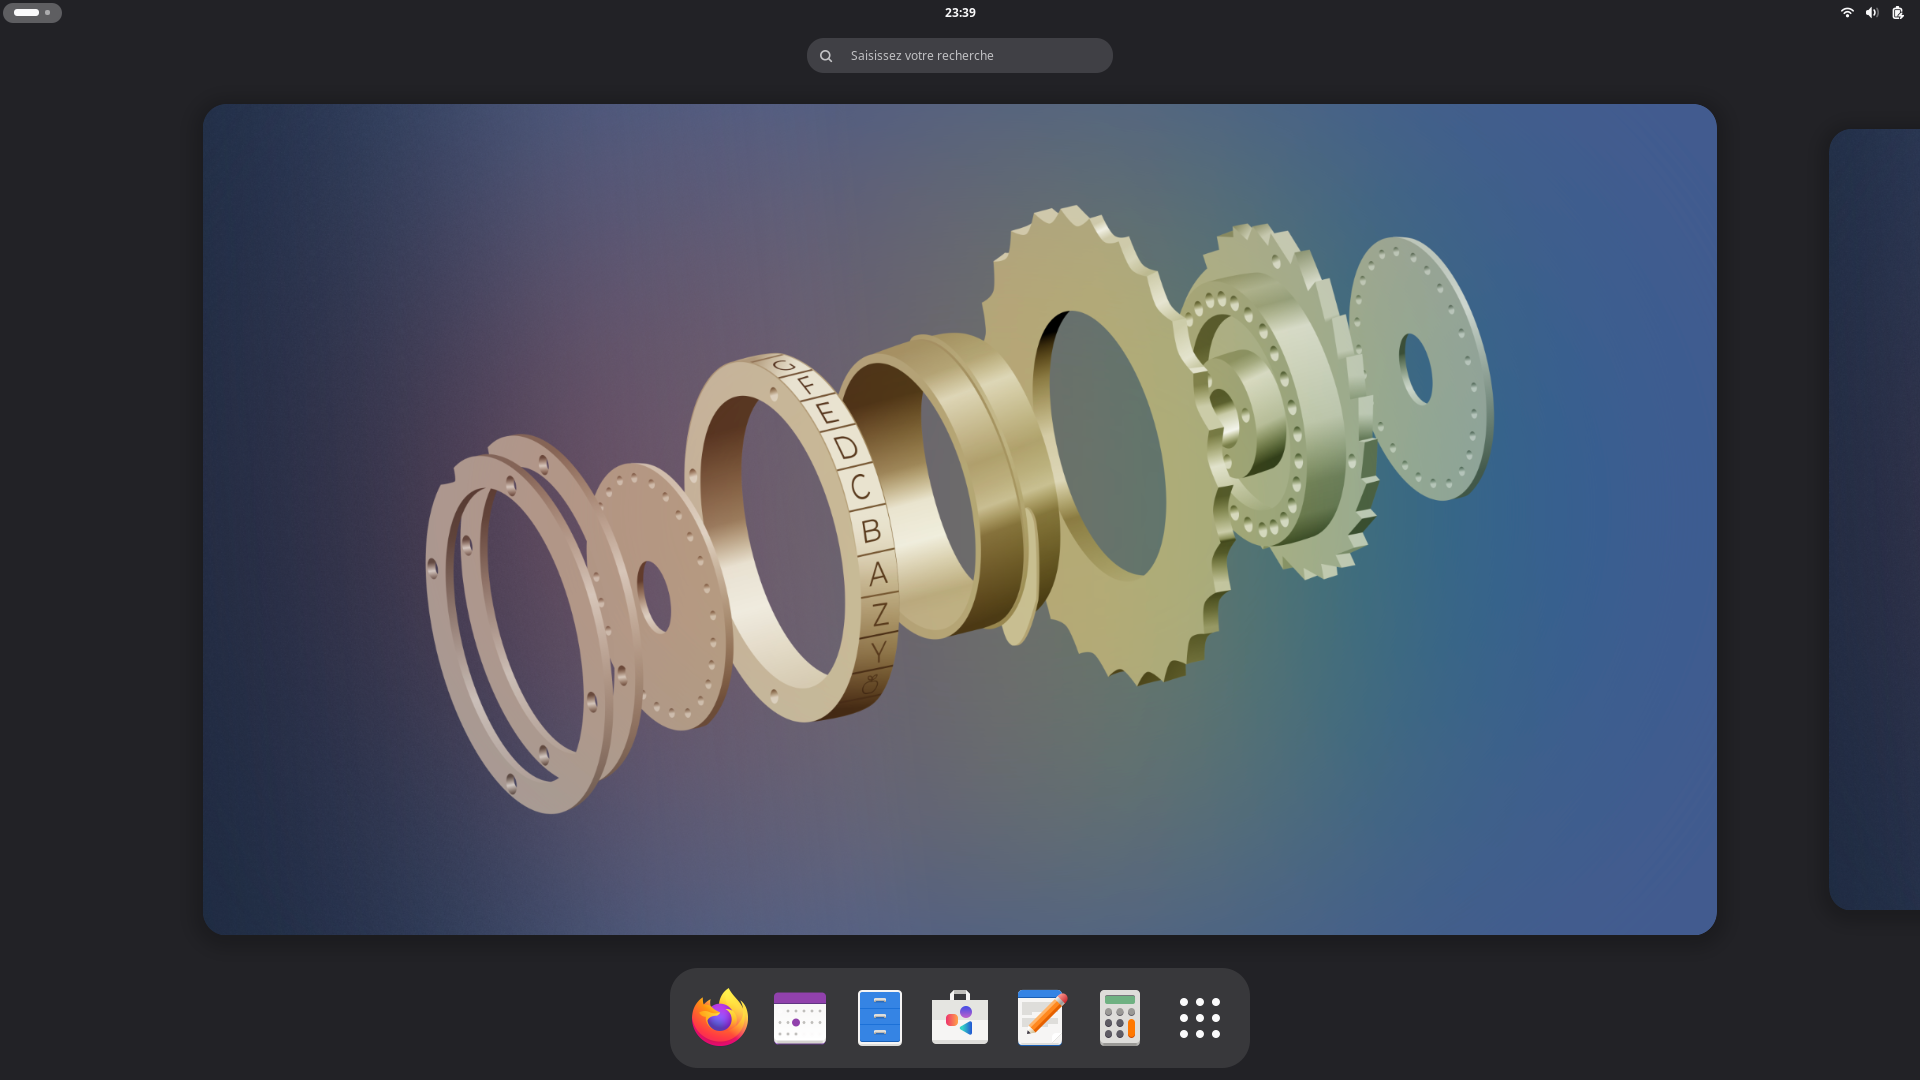
Bureau GNOME

Sommaire

Expérience utilisateur

L’environnement de bureau GNOME est proposé dans sa version 51.

Comme souvent lors des précédentes versions, l’amélioration des performances et de l’affichage sont à l’honneur. La capture d’écran est notamment plus rapide en évitant des opérations redondantes ou de copie de l’image, Mutter a retravaillé son ordonnancement de l’affichage qui permet aux animations d’être fluides même en cas d’usage intensif de la machine. Les anciens pilotes propriétaires de Nvidia ne sont plus pris en charge : outre la simplification du code, cela rend le sous-système plus robuste et efficace pour les autres pilotes. Cela ne concerne que les pilotes propriétaires nommés version 470 et inférieurs, le pilote libre nouveau peut être utilisé à la place dans ce contexte. Enfin le curseur de souris peut être rendu au format vectoriel plutôt qu’une image bitmap pour s’assurer de la qualité du rendu.

De même, les préférences bénéficient de nombreux changements. GNOME peut enfin tirer parti d’un éventuel accéléromètre pour effectuer une rotation automatique de l’affichage. Il est possible de bloquer cette rotation dans un sens particulier. Dans la même veine, il est possible de désactiver automatiquement le touchpad de l’ordinateur quand une souris externe est connectée. Côté sécurité, l’antique protocole de sécurité Wi-fi WEP n’est plus pris en charge tandis que les connexions distantes permettent d’utiliser un socket serveur SSH. L’interface pour l’enregistrement des empreintes digitales a été revue.

Le magasin d’applications Logiciels démarre plus rapidement en exploitant le cache des usages précédents et avec un rendu des icônes amélioré pour rendre l’opération plus rapide. La liste des permissions requises par une application est maintenant entièrement visible avant d’installer ladite application. Enfin si vous souhaitez installer une application qui ne reçoit plus de mises à jour, une alerte vous préviendra avant d’effectuer l’opération.

Le navigateur de fichiers n’est pas en reste, de nombreuses opérations longues comme une copie, un rafraichissement important, une recherche, etc. ne bloquent plus l’interface. Le rendu des gros dossiers ou des dossiers distants est également plus rapide. Les notifications de l’application sont également groupées.

Tandis que le navigateur Web propose une génération automatique de mots de passe aléatoires, sécurisés et longs en reposant sur la bibliothèque pwquality pour s’assurer de la qualité du résultat. Le gestionnaire de mots de passe est également plus fiable. La barre d’adresse a été retravaillée pour que la suggestion des moteurs de recherche lors d’une saisie ne pollue pas trop la liste des possibilités.

L’application Cartes permet enfin de télécharger les cartes d’une région pour effectuer un rendu hors ligne plus tard. Il affiche également beaucoup plus de données temps réel concernant les transports publics comme les départs ou arrivés à venir ou s’il y a du retard sur un trajet donné.

Alors que l’application Calendrier se focalise sur l’amélioration de ses performances, en particulier pour la vue mensuelle avec un calendrier chargé. La synchronisation des calendriers consommera moins de données. L’intégration avec Cartes a été renforcée pour lancer ce dernier si un événement a une localisation précise. Enfin l’édition des événements a été revue qui bénéficie d’une plus grande section de notes et une meilleure prise en charge des liens des réunions sur Microsoft Teams.

Le visionneur d’images Loupe affiche beaucoup plus de métadonnées de l’image, pendant que le prévisualiseur de documents a été porté sur GTK4 et libadwaita pour s’intégrer au reste de l’environnement tels que le mode sombre ou la prise en charge des affichages à haute densité de pixels. Enfin le visualiseur de documents Papers peut insérer des signatures effectuées avec la souris ou le touchpad.

Passage de l’utilitaire GNOME Keyring à oo7 pour l’accès et la gestion des données privées, comme les mots de passe. Ce changement introduit par le projet GNOME permet d’améliorer la gestion des permissions avec des applications qui n’ont accès qu’à certaines informations qu’il contient, mais aussi des secrets FIDO2. Les données enregistrées par GNOME Keyring sont automatiquement migrées vers oo7 ce qui rend cette transition transparente pour l’utilisateur.

Les versions atomiques bénéficient de l’interface web d’Anaconda pour l’installation du système. Cette nouvelle interface a été proposée dans Fedora Linux 42 pour l’édition Workstation. Ce changement permet d’avoir une procédure plus uniforme et de simplifier la maintenance de fait.

Ces mêmes versions peuvent bénéficier de l’installation distante via HTTPS à titre expérimental. Cela est possible grâce à l’apport du point précédent. Pour des raisons de sécurité cela n’est pas actif par défaut, il suffit de renseigner parmi les arguments du noyau au démarrage de l’image Live les options inst.webui.remote.password=PIN où PIN est un code PIN à renseigner par la machine qui effectuera l’installation. Le fait de se passer des protocoles d’affichage distants tels que VNC ou RDP permet d’utiliser plus de périphériques différents pour procéder à l’installation avec une meilleure intégration en général dans le système. De plus, sur le système cible il y a besoin de moins de ressources pour cette opération ce qui est particulièrement avantageux pour installer des Fedora sur des cartes ARM64 peu puissantes. Le chiffrement permet d’éviter les fuites du mot de passe durant la procédure, le chiffrement reposant sur des certificats auto-signés générés à la volée.
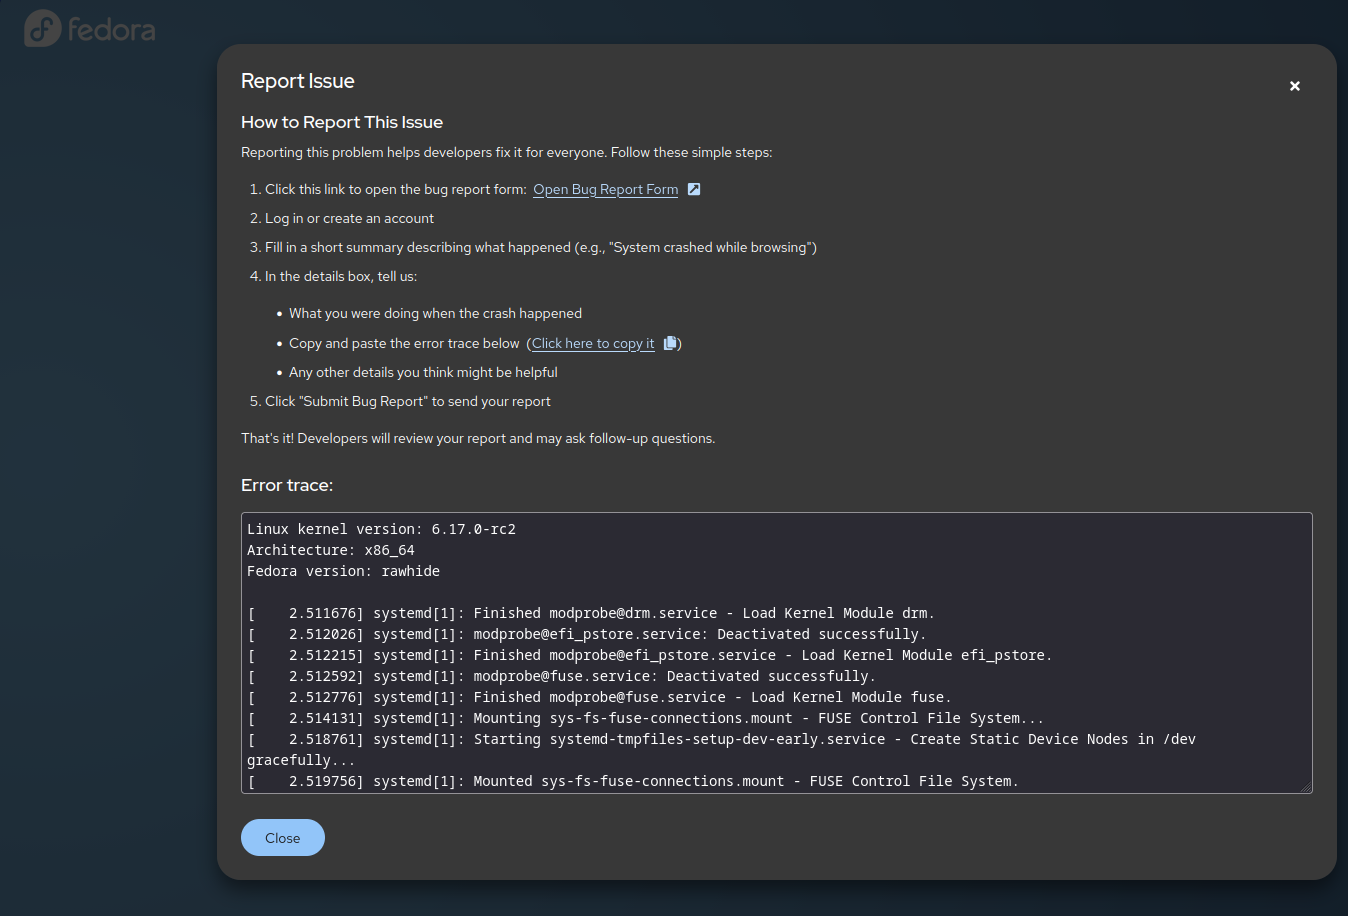
Rapport de bogue lié à l’affichage du noyau

En cas de certaines erreurs fatales du noyau, le QR code d’erreur généré redirige vers le site https://drm-panic.fedoraproject.org/ pour expliquer plus simplement l’erreur rencontrée. En effet les QR codes précédents introduits depuis Fedora Linux 42 ne sont pas facilement exploitables par l’utilisateur moyen. L’objectif est que cette information soit affichée de manière plus structurée et lisible pour l’utilisateur et faciliter la création d’un rapport de bogue s’il le souhaite. Pour des raisons de confidentialité, les informations sont traitées localement sur la machine de l’utilisateur avec une implémentation purement en JavaScript. Les données ne sont envoyées à un éventuel serveur que si un rapport de bogue est crée à partir de ces informations. Le projet Fedora espère que la simplification de cette étape permettra de recueillir plus de rapports de bogue et d’améliorer l’aide entre utilisateurs.

L’aide de LibreOffice repose maintenant sur des pages web ouvertes depuis un navigateur externe. C’est une option fournie par LibreOffice depuis quelque temps qui permet de s’affranchir de l’aide interne du logiciel. Ainsi ouvrir l’aide ouvrira le navigateur par défaut vers l’aide locale de LibreOffice. L’avantage pour Fedora Linux est de rendre les paquets de l’aide plus petits, mais aussi parce qu’ils ne dépendent plus du code même de LibreOffice, les paquets sont indépendants de l’architecture et n’ont pas besoin d’être dupliqués pour chaque plateforme ce qui fait gagner des ressources pour compiler et distribuer ces paquets en supprimant des redondances.

Les dictionnaires fournis par le projet LibreOffice peuvent être installés en lieu et place de ceux du projet hunspell dont ils dérivent. Le métapaquet libreoffice-dictionaries permet d’installer les différents sous paquets libreoffice-dict-<lang>. Bien que LibreOffice utilise hunspell, de nombreux ajouts sont disponibles dans la variante de LibreOffice dont quelques langues supplémentaires ou une meilleure prise en charge des variantes de l’anglais avec un dictionnaire dédié pour chacune d’entre elles. Il n’est pas possible d’installer les deux dictionnaires en parallèle pour une même langue.

Chaque édition atomique de Fedora Linux peut bénéficier de sa propre liste de Flatpak provenant de Flathub. Ce changement n’a pas encore un impact direct immédiat mais ouvre la porte à ce que chaque édition en fonction de ses besoins puisse arbitrer si un Flatpak provient par défaut de Fedora ou de Flathub. L’objectif est de trouver un équilibre pour avoir une logithèque Flatpak suffisamment fournie tout en utilisant les Flatpak de qualité voire officiels qui peuvent venir de Flathub ce qui est bénéfique pour l’utilisateur et le développeur de l’application. Le tout en permettant d’éviter les Flatpak de Flathub qui ne respectent pas les critères légaux du projet Fedora notamment vis à vis des brevets logiciels ou de licence par exemple.
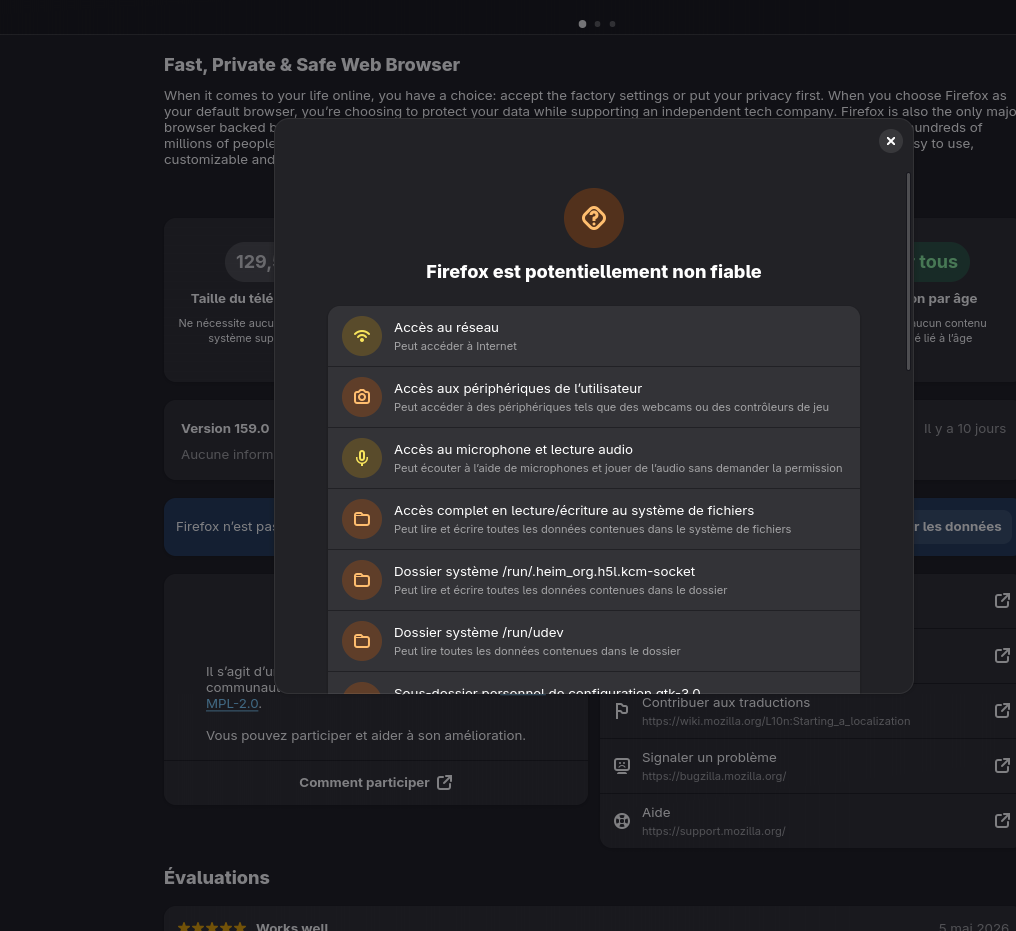
Liste des permissions dans GNOME Logiciels

Internationalisation

L’outil d’aide à la saisie IBus évolue à la version 1.5.35. Il prend en charge les états ISO des dispositions clavier XKB tels qu’utilisés par les environnements KDE Plasma, Sway, Hyprland ou COSMIC. Cela permet par exemple pour une disposition lituanienne en tapant `a d’obtenir ā au lieu de `a. Par ailleurs il gère également le forward key events du protocole Wayland input-method version 2 pour rediriger les événements clavier de la pop-up IBus vers le moteur IBus.

Mise à jour de fontconfig à la version 2.18. Le cache des polices passe à la version 11 qui précise quelle version de fontconfig a généré le dit fichier ce qui permet plus facilement d’être réutilisé sans devoir les régénérer ce qui est particulièrement utile en cas d’usage partagé tels que des environnements à base de conteneurs ou d’applications dans des bacs à sable. Un nouvel outil fc-genconf fait son apparition pour générer une configuration basique.

Administration système

NetworkManager prend en charge les réseaux IPv6-mostly. Derrière cette terminologie surprenante se cache la RFC 8925 déjà implémentée dans d’autres systèmes d’exploitation concurrents dont l’objectif est d’assurer une transition douce vers un réseau uniquement IPv6. Un réseau IPv6-mostly permet de partager au sein d’un même réseau des machines IPv6 uniquement, IPv4 uniquement et ceux ayant une double pile tout en partageant le même segment.

Côté NetworkManager cela consiste dans la prise en charge de deux protocoles : DHCPv4 option 108 (RFC 8925) et 464XLAT (RFC 6877). Le premier permet à l’administrateur du réseau de forcer le passage à l’IPv6 uniquement pour un périphérique donné qui peut ainsi couper l’IPv4 automatiquement.

Le second comporte deux parties, une côté client nommée Customer-side translator (CLAT) qui permet de traduire un paquet IPv4 généré par une application du système en un paquet IPv6 avant de l’envoyer sur le réseau. Cela permet donc à une application non conçue pour l’IPv6 de malgré tout envoyer des données à un service en ligne qui ne prend en charge que l’IPv6.

Côté réseau, en dehors de ce que NetworkManager doit gérer, il peut y avoir ajout de Provider-side translator (PLAT) qui utilise NAT64 pour convertir le paquet IPv6 en paquet IPv4 avant de l’envoyer sur un autre réseau dont Internet. Ainsi la combinaison des deux parties permet également à une application utilisant IPv4 d’atteindre un service IPv4 sur Internet tout en ayant un principalement un réseau local IPv6. Ou à un système utilisant uniquement IPv6 de malgré tout communiquer avec des services IPv4 sur Internet.

Par défaut et pour des raisons de sécurité, l’API noyau ptrace n’autorisera plus certains accès à moins d’installer certains logiciels comme un débogueur qui peuvent en avoir besoin. En effet cet API permet à un processus d’inspecter et de contrôler un autre processus lancé par le même utilisateur ce qui permet notamment d’investiguer dans sa mémoire ou de changer son flux d’exécution. Cependant cette capacité est intéressante dans le cadre du développement en particulier pour certains outils comme les débogueurs.

Linux a introduit par le passé un module nommé yama pour trouver un compromis. Ainsi cette inspection n’est possible que depuis le processus qui en a lancé un autre, ce que fait notamment un débogueur. C’est la politique par défaut de Linux et largement suivie parmi les distributions. Fedora Linux a fait le choix, comme Debian, de désactiver ce module yama dans certains contextes pour autoriser cet usage dans d’autres contextes de développement en liant cette désactivation au paquet elfutils-libs entre autres. Et par le jeu des dépendances, il était en fait en permanence désactivé dans tous les systèmes Fedora Linux depuis lors.

L’objectif ici est donc de changer cela pour que le paquet yama-ptrace-enable, qui active ptrace, ne soit installé que si l’un des paquets suivant est installé : elfutils, systemtap, gdb (mais pas gdb-headless ou gdb-minimal), lldb, delve, strace, ltrace, etc. ce qui n’est pas le cas par défaut et doit améliorer la sécurité de beaucoup de systèmes Fedora Linux.

Les utilitaires chpasswd et newusers utilisent dorénavant PAM pour valider les droits et si les mots de passe sont conformes à la politique de sécurité du système. Ainsi ces outils peuvent tenir compte si un nouveau mot de passe réutilise un mot de passe précédent, ne pas autoriser un mot de passe trop faible selon des critères définis, de notifier dans les logs si les mots de passes ont été changés, etc. Cela est conforme au fonctionnement des autres utilitaires qui passent par PAM pour ces tâches ce qui uniformise leur comportement dans le système.

Les consoles virtuelles passent de fbcon à kmscon. Ainsi la gestion de ces consoles virtuelles passe du noyau Linux à l’espace utilisateur. Le premier n’est plus trop maintenu car reposant sur l’ancienne interface frame buffer plutôt que d’utiliser l’interface drm. De fait, comme les pilotes graphiques actuels reposent majoritairement sur l’interface drm, l’usage de fbcon nécessite une couche d’émulation nommé fbdev et l’usage des utilitaires bash et getty pour avoir un fonctionnement basique. Et encore, le scroll à la souris restait désactivé pour des raisons de sécurité du fait du manque de maintenance.

kmscon remplace cela en utilisant les couches modernes du noyau ce qui améliore la sécurité et la fiabilité en tournant en espace utilisateur. Ainsi en cas de crash, le service est redémarré plutôt que de planter entièrement la machine avec un kernel panic. Le tout en offrant plus de fonctionnalités, ainsi il propose le scroll de la souris évoqué précédemment, la prise en charge de xkbcommon pour mieux gérer les dispositions claviers et permettre d’en changer à la volée, un rendu des caractères avec une meilleure compatibilité avec Unicode, la possibilité d’avoir une accélération graphique reposant sur OpenGL. Le copier/coller à la souris tout comme la rotation de l’écran sont aussi disponibles.

En cas de problèmes sur une machine, un retour en arrière automatique vers fbcon est proposé ou reste possible manuellement. Mais à terme l’objectif est d’abandonner entièrement ce dernier. Pour ceux qui sont intéressés de configurer kmscon, il est possible d’éditer le fichier /etc/kmscon/kmscon.conf.

Déplacement des fichiers des dépôts de la distribution du répertoire /etc/yum.repo.d vers le répertoire /usr/share/dnf5/repos.d. Les clés GPG sont aussi redirigées vers le fichier /usr/share/pki/rpm-gpg. Cette opération a été rendue possible par la suppression complète de DNF4 dans la version précédente de Fedora Linux ce qui a simplifié les choses. L’objectif est de tirer parti de la séparation entre configuration système et utilisateur de plus en plus adoptée avec une configuration en lecture seule fournie par la distribution dans /usr quand les changements sont effectués sur /etc/ pour mieux distinguer ce qui est fourni par la distribution et ce qui est changé.

Ainsi l’utilisateur qui souhaite ajouter des dépôts à la main peut continuer à utiliser /etc/yum.repo.d et s’il veut changer les paramètres d’un dépôt existant il peut le faire dans le dossier /etc/dnf/repos.override.d/.

Anaconda prend en charge le gestionnaire de stockage Stratis. Pour rappel il permet de fusionner la couche bloc et le système de fichiers XFS pour fournir des fonctionnalités supplémentaires clé en main telles que les snapshots ou le chiffrement le tout via une interface en ligne de commande et une interface DBus spécifique. La nouveauté comprend l’installation via un fichier kickstart tout comme le partitionnement manuel.

Stratis était certes proposé depuis Fedora 28 mais l’absence de disponibilité à l’installation par défaut a réduit son adoption potentielle car il était nécessaire de l’installer après coup par des moyens détournés ou l’utiliser pour d’autres partitions que celle du système. L’objectif ici est d’y remédier pour attirer de nouveaux utilisateurs intéressés par la solution.

Le logiciel Ignition gère le format de configuration de l’outil Butane. Ignition est le logiciel qui permet de configurer l’espace disque et les utilisateurs lors du premier démarrage de CoreOS à partir d’une configuration. Cependant son fichier de configuration au format JSON est jugé difficile à manipuler par un humain. D’où la création de Butane qui permet d’avoir une configuration plus simple à écrire au format YAML qu’il peut transpiler par la suite pour fournir le résultat obtenu à Ignition.

Cependant cette approche en deux temps où il faut au préalable installer butane pour écrire la configuration en YAML puis le transpiler avant de l’envoyer à Ignition complexifie le système et ajoute des barrières d’entrée à l’usage de CoreOS.

Ignition a absorbé le code de Butane mais l’utilitaire Butane reste toujours disponible dans son paquet dédié. Ignition va tenter de parser d’abord au format YAML avant de tenter de le parser comme une configuration JSON si cela avait échoué. Les configurations source: local / --files-dir ne sont pas gérées au lancement de CoreOS, car d’autres fichiers nécessitent d’être présents pour cela, cela nécessite de passer par l’utilitaire butane sur un autre système au préalable.
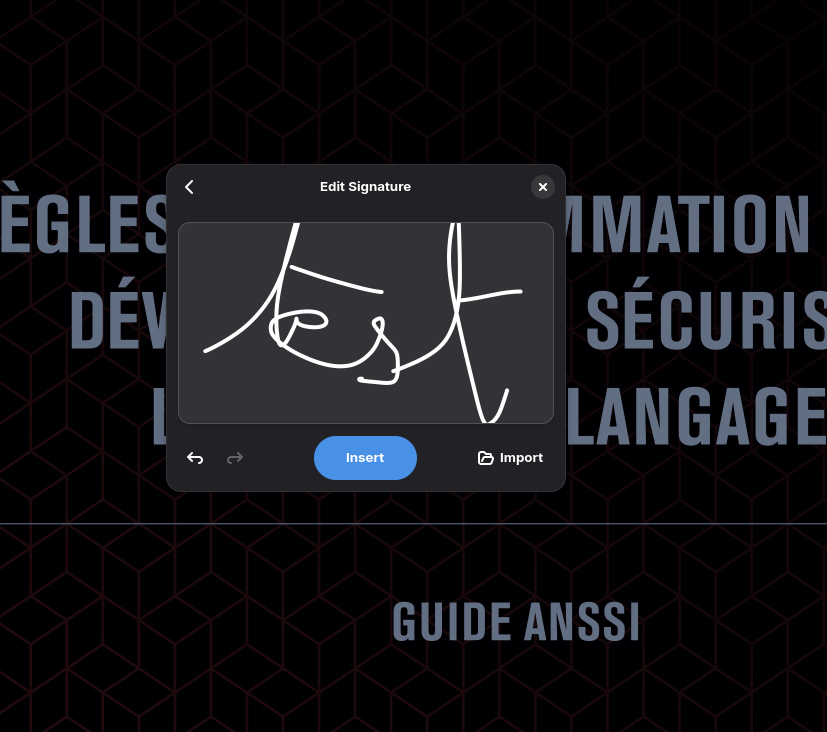
Signature manuscrite dans GNOME Documents

L’API noyau de cryptographie à destination de l’espace utilisateur est partiellement désactivée. Cette API est difficile à maintenir et pose de gros problèmes de sécurité. Le projet Linux lui-même entame le processus de s’en passer à terme. Le projet Fedora décide de prendre les devants, ainsi dès la version 7.2 du noyau proposée par Fedora Linux 45, les algorithmes disponibles via cette API sont restreints par défaut mais cette restriction peut être levée en changeant la valeur du fichier /proc/sys/crypto/af_alg_restrict. Cette restriction n’arrivant normalement qu’à partir de la version Linux 7.3. Le projet Fedora souhaite mettre un terme entièrement à cette API pour Fedora Linux 46 quoi que décide le projet Linux d’ici là.

L’usage de cette API est officiellement faible, peu de paquets de Fedora Linux s’en servent encore dont certains qui ne sont plus trop maintenus comme iwd avantageusement remplacé par wpa_supplicant. L’objectif est d’avertir ici les potentiels utilisateurs de solutions maisons de s’y préparer et d’engager la transition pour les quelques paquets qui s’en servent encore avant une suppression définitive.

L’outil d’authentification authselect ne propose plus la prise en charge les profils NIS par défaut. Il n’est plus possible de choisir NIS pour nsswitch.conf avec la commande authselect select nis mais l’option reste disponible via un profil personnel ou des opérations manuelles. L’objectif est de réduire l’usage de cette technologie dépassée au sein de Fedora Linux pour s’affranchir de sa maintenance à terme.

Mise à disposition de l’outil encapsule pour exécuter des outils venant d’Internet dans un conteneur léger dédié. Cet outil en ligne de commande est conçu pour exécuter les scripts ou utilitaires usuellement téléchargés à coup de curl <url> | sh, npm install <paquet> et autres dans un environnement plus isolé du système pour limiter les risques de sécurité ou tout simplement de pollution du répertoire utilisateur. Il repose sur Podman pour concevoir le conteneur qui l’exécute et a une configuration simple pour désactiver le réseau ou les droits super utilisateurs par exemple. Il n’est pas impossible à terme qu’il devienne un wrapper à OpenShell dans le futur pour apporter une isolation plus forte encore pour des raisons de sécurité.

Ajout de grub-cc comme chargeur de démarrage minimal pour démarrer sur des machines en UEFI uniquement pour lancer des images noyau unifiés (UKI). C’est une alternative à GRUB lui-même pour ce cas d’usage à destination des conteneurs comme ceux pour du Confidential Computing, d’où le nom, CoreOS ou les machines virtuelles. L’objectif est de réduire sa taille en ayant uniquement le strict nécessaire pour fonctionner dans ce contexte. Cela permet de réduire la surface d’attaque mais aussi le nombre de mises à jour potentielles, chacune nécessitant de le resigner sur la machine dans le cadre du Confidential Computing.

L’utilitaire des paquets rpm passe à la version 6.1. Pour les utilisateurs, il est possible d’effectuer des requêtes pour notamment connaître les paquets installés sur le système même si une transaction, comme l’installation d’un paquet, est en cours. Avant chaque transaction bloquait ce type de requêtes en lecture seule. La recherche des groupes et utilisateurs peut de nouveau passer par Name Service Switch ce qui est particulièrement utile en cas d’authentification centralisée comme dans les grandes entreprises. Le temps d’installation d’un paquet devrait être plus rapide. Les autres ajouts sont plutôt destinés aux créateurs de paquet comme les modificateurs de macros litéraux afin de ne pas interpréter les % d’une macro ou one shot pour résoudre une macro qu’une fois afin de réutiliser son résultat par la suite pour obtenir des gains de performances. La macro %define peut résoudre une macro immédiatement durant sa définition ou mettre la macro dans le contexte global indépendamment. La commande rpmbuild peut aller directement aux étapes %check avec l’argument --short-circuit pour gagner du temps durant le développement. Enfin le script d’environnement de construction est généré dans le fichier rpmbuild.env dans le répertoire %{builddir} afin de faciliter le débogage, son analyse ou pour reproduire les différentes étapes manuellement.

Ce dernier rend obligatoire par défaut la vérification des signatures des paquets avant leur installation. Si un paquet n’est pas signé ou que la signature n’est pas correcte, l’installation échouera. Ce mode était déjà présent depuis les débuts de Fedora dans YUM puis DNF, l’objectif est que l’outil sous-jacent RPM suive cette directive pour des raisons de sécurité qui sont plus prégnantes de nos jours qu’à l’époque. Il est possible de la désactiver avec l’option --nosignature.

Il a été nécessaire d’attendre depuis RPM 6.0, disponible depuis Fedora Linux 43, qui offrait déjà cette possibilité avec des aides pour générer des paquets auto signés par ailleurs, car l’équipe manquait de ressources pour les adaptations nécessaires. En effet il n’était dès lors plus possible pour DNF d’installer des paquets non signés à la demande dans ce cas, et il fallait vérifier la construction des paquets pour adapter les procédures afin que cela soit possible sans encombre et sans multiplier les désactivations manuelles ci et là.

La bibliothèque de sécurité OpenSSL est mise à jour vers la version 4.0. Comme souvent la version majeure de cette bibliothèque de référence est l’occasion de casser la compatibilité ascendante. C’est pourquoi la version 3 reste disponible via le paquet openssl3 pour les logiciels et ceux qui en ont encore besoin.

Ainsi, il propose une meilleure confidentialité avec la prise en charge de Encrypted Client Hello (ECH) pour chiffrer l’initialisation des échanges TLS et cacher le Server Name Indication durant le processus. Il améliore également la prise en charge de la cryptographique dite post-quantique notamment avec l’implémentation de la RFC 8998. Côté suppression, beaucoup de code d’anciens algorithmes de chiffrement sont retirés après une longue période de désactivation comme SSLv3.
Les engines tirent également leur révérence en faveur des providers comme interface pour ajouter des algorithmes de chiffrement supplémentaires externes. Enfin, le protocole SSLv2 Client Hello est également supprimé.

Le gestionnaire de conteneurs podman est proposé dans sa 6ᵉ version. Cette version majeure nécessite aussi certaines adaptations avec la suppression de slirp4netns qui est remplacé par pasta pour la réalisation de réseau sans droits superutilisateurs. La prise en charge des cgroups version 1 est également supprimée tout comme la base de données BoltDB qui était déjà remplacée par défaut par SQLite depuis la version 4.8. Pour assurer une bonne migration des données, il est conseillé de mettre à jour vers podman 5.8 qui est disponible dans les autres versions de Fedora Linux avant.

Du côté des fonctionnalités, les fichiers de configurations ont été revus pour retirer la confusion entre les paramètres pour les clients distants et ceux des serveurs avec le partage d’une logique similaire entre les fichiers containers.conf et storage.conf. Pour le réseau, la création de réseau va utiliser Netavark qui perd par ailleurs la prise en charge d'iptables au profit de nftables. L’ordre des interfaces réseau est maintenant aussi préservé au sein des conteneurs.

La version par défaut du gestionnaire de base de données MySQL pointe vers la version 9.7 au lieu de la version 8.4. Cette version apporte notamment le nouveau type pour les colonnes : VECTOR qui est un ensemble de flottants 4 d’octets. De par la nature de la colonne, elle ne peut pas être utilisée comme clé primaire de la table par exemple. Elle sert de base technique à la solution MySQL HeatWave qui sert dans un contexte d’IA pour notamment faire de la recherche au sein de documents. Certaines fonctions comme le calcul de distance entre deux vecteurs sont proposées à cette fin. De plus, l’optimiseur de requêtes Hypergraph fait son entrée pour proposer, en général, de meilleures performances. De même plusieurs modules de télémétries et de réplications pour effectuer de la haute disponibilité sont disponibles pour permettre notamment une meilleure compatibilité avec des solutions OpenTelemetry.

Pour des raisons de sécurité, le greffon mysql_native_password tire sa révérence pour l’authentification. Il est nécessaire de reconfigurer les authentifications pour employer caching_sha2_password à la place par exemple. La version 8.4 reste disponible avec le paquet mysql8.4 pour ceux qui en ont besoin.

De manière analogue, la version par défaut du gestionnaire de base de données MariaDB pointe vers la version 12.3 au lieu de la version 11.8. Cette version apporte de nombreuses fonctions pour améliorer la compatibilité avec la solution propriétaire Oracle dont la prise en charge native de SYS_REFCURSOR ou des triggers qui peuvent être exécutés individuellement sur plusieurs événements à la fois ce qui simplifie la maintenance par ailleurs. L’optimisateur de requêtes bénéficie aussi de nombreuses optimisations, et a ajouté la prise en charge de nombreuses indications d’optimisation proposées par MySQL pour améliorer la compatibilité entre les deux. Pour améliorer la compatibilité avec MySQL, il implémente aussi la fonction d’authentification caching_sha2_password évoquée plus haut.

Enfin les données géospatiales bénéficient d’une meilleure prise en charge avec des fonctions pour valider et vérifier la validité de ces données, pour simplifier les géométries complexes afin d’améliorer les performances ou encore les hasher pour effectuer des recherches de proximité performantes.

Les versions 10.11 et 11.8 restent disponibles via les paquets mariadb10.11 et mariadb11.8 pour ceux qui le souhaitent.

Développement

La chaine de compilation GNU progresse avec binutils 2.47 et glibc 2.44.

Les utilitaires binutils prennent en charge de nombreuses extensions du standard de l’architecture RISC-V. L’assembleur introduit une nouvelle commande --reloc-section-sym=[all|internal|none] pour spécifier si les relocalisations faisant référence à des symboles de liaison locale sont ajustés pour utiliser les sections des symboles. objdump et readelf peuvent préciser un répertoire où trouver des fichiers de débogage supplémentaires avec --debug-dir=[DIR]. Enfin l’éditeur de lien bfd peut fonctionner avec une optimisation faible avec l’argument -O 0 ce qui bloque la fusion du contenu des sections pour diminuer le temps de l’opération au détriment de la taille du binaire final.

La bibliothèque C glibc introduit le fichier /etc/tunables.conf pour stocker les réglages de manière plus permanente et simple que l’emploi de la variable d’environnement GLIBC_TUNABLES. La configuration consiste en un paramètre par ligne. De nombreuses optimisations et corrections des fonctions mathématiques ont également été importées du projet CORE-MATH.

La chaine de compilation LLVM version 23 est proposée. Cette version comme souvent apporte une prise en charge partielle de la prochaine norme C++2d et de la future norme C2Y tandis que les normes antérieures du C et C++ sont mieux gérées. Les diagnostiques pour ces langages bénéficient de nombreuses améliorations dont des alertes en lien avec la durée de vie des objets ou pointeurs manipulés par des fonctions. Il apporte notamment aux architectures ARM64 et x86_64 la fonction Lightweight Fault Isolation pour réaliser un bac à sable léger pour les applications C et C++ afin de réduire les risques de sécurité autour des problèmes mémoires de ces applications sans trop pénaliser les performances et sans demander beaucoup d’adaptations. Côté matériel il propose un début de la prise en charge du prochain processeur Nvidia nommé Rosa. Du côté d’AMD, c’est l’interface de programmation AMD HIP, proche de Nvidia CUDA pour l’exploitation des capacités de calcul sur GPU, qui utilise le nouveau pilote de LLVM pour s’y interfacer, rejoignant ainsi Nvidia CUDA et OpenMP qui en bénéficiaient déjà. Et comme la suite GNU évoquée plus haut, de nombreuses instructions RISC-V sont prises en charge par l’assembleur maison.
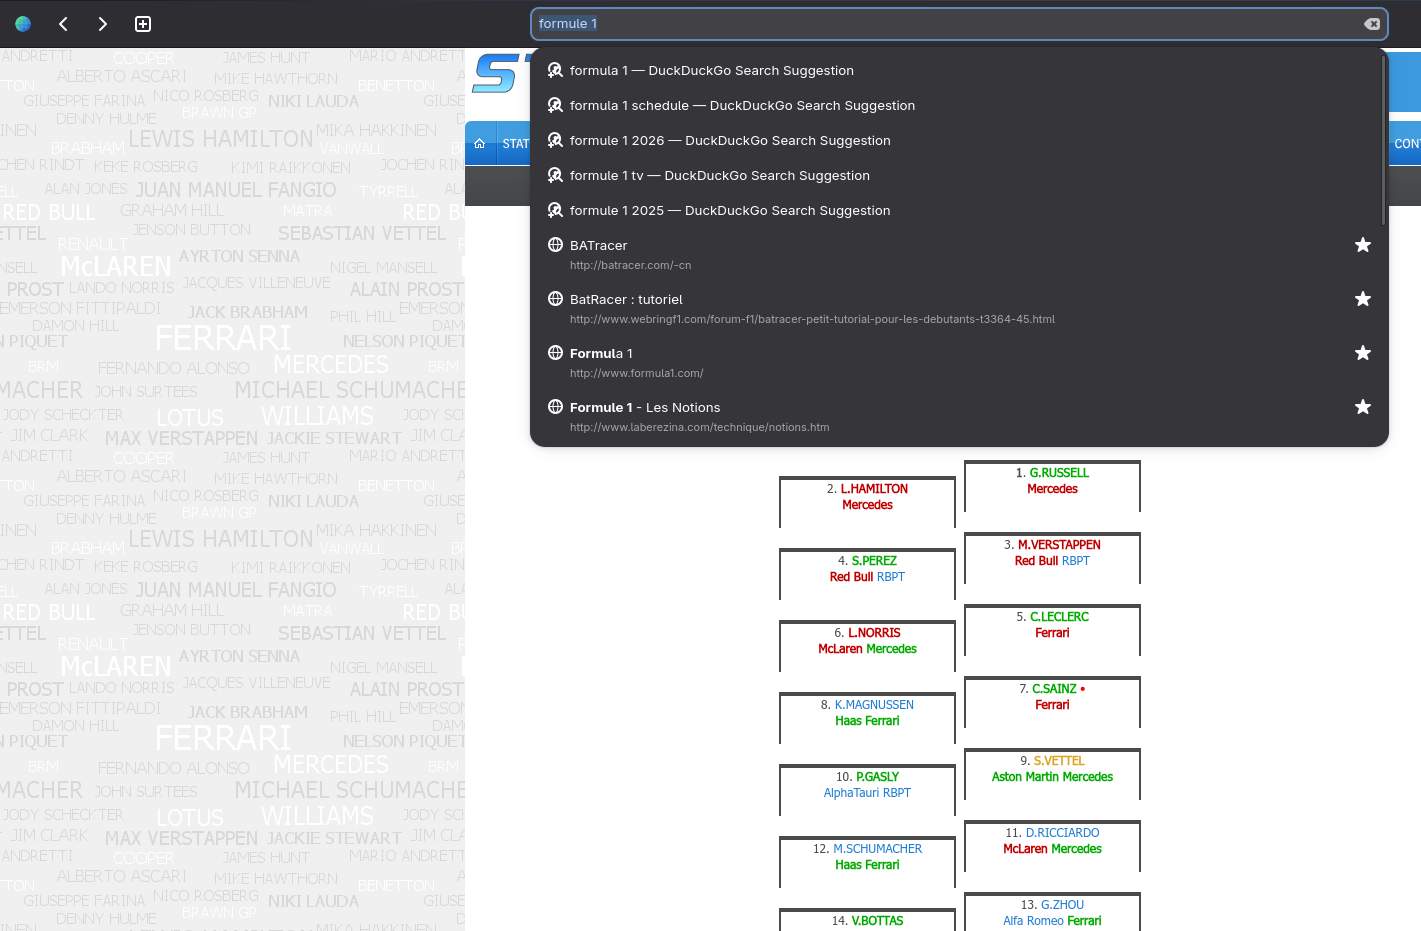
Nouvelle barre d’adresse de GNOME Web

Le langage Python rampe vers la version 3.15. Cette version apporte l’import paresseux des modules avec le mot clé lazy pour ne charger un gros module que s’il est réellement utilisé afin d’améliorer les performances quand le module n’est pas utilisé finalement. Des dictionnaires immuables frozendict étendent la liste des objets de base immuables pour apporter plus de garanties dans le code notamment dans un contexte d’exécution parallèle. Les outils de profilage de code sont rassemblés au sein du module profiling qui bénéficie d’un nouveau profiler Tachyon. Celui-ci effectue des mesures à intervalles réguliers pour diminuer le coût de son usage tout en ne nécessitant pas de changement dans le code. Mais cela au détriment de l’exactitude du résultat. Enfin, le compilateur JIT expérimental bénéficie de nombreuses améliorations de performance.

La bibliothèque python-dateutil est marquée comme dépréciée en vue d’une suppression future. Cette extension de la fonction datetime de Python n’est plus maintenue ce qui peut poser à terme des problèmes de sécurité alors que de nombreux projets en dépendent encore. L’objectif est d’évaluer la situation et de commencer la transition où elle est possible avant d’entamer sans suppression quand la transition sera terminée ou sa maintenance impossible.

L’utilitaire Python setuptools est proposé avec la version 82. Cette version n’est pas compatible avec la précédente notamment à cause de la suppression de pkg_resources qui a été remplacé par importlib.resources et importlib.metadata depuis déjà cinq ans. Fedora propose le paquet python3-pkg-resources pour fournir cette fonction manquante à part le temps d’effectuer la transition, près de 150 paquets de Fedora Linux en ont typiquement encore besoin.

Le langage Go saute vers sa version 1.27. Cette version du langage propose les méthodes génériques qui étaient l’étape logique après l’introduction des fonctions génériques dans les versions précédentes. Le compilateur peut rediriger vers des allocateurs spécifiques les allocations de petites tailles afin d’améliorer jusqu’à 30% les performances dans ce contexte. Le détecteur de blocages dans les goroutines abandonne son statut expérimental pour être pleinement exploitable.

Les paquets pour la prise en charge du encoding/json/v2 et encoding/json/jsontext sont introduits dans la bibliothèque standard. Le premier, afin notamment d’être plus strict concernant la validité d’un fichier JSON tout en améliorant les performances lors du parsage. Le second pour permettre une manipulation bas niveau et syntaxique du format.

Un paquet uuid a été introduit pour générer ou lire facilement des identifiants uniques suivant différents formats. Enfin, le paquet expérimental simd est proposé pour effectuer des opérations parallèles variées de manière portable et indépendante de la taille des vecteurs afin d’améliorer les performances pour les opérations qui s’y prêtent.

Le langage Perl brille dans sa version 5.44. Cette version propose une prise en charge d’Unicode 17.0, dont les règles ont été renforcées sur les identifiants et les noms de groupe des expressions régulières. D’ailleurs, les expressions régulières bénéficient d’une fonctionnalité expérimentale use feature « enhanced_xx" pour autoriser les classes de caractères entre crochets sous le modificateur /xx sur plusieurs lignes tout en pouvant contenir des commentaires. Le générateur interne de nombre aléatoires exploite l’appel système getentropy(), utilisant le fichier /dev/urandom ou un état interne si cela n’est pas possible. Les performances ont également été améliorées pour les opérations de base sur les entiers tout comme la génération d’un hash d’une liste de paires de clé / valeur.

L’interpréteur Lua est mis à jour vers la version 5.5. Parmi les changements, il propose la déclaration de variables globales avec le mot clé global, les vararg tables peuvent être nommés, les tableaux sont plus compacts pouvant être jusqu’à 60% plus petits en mémoire et de meilleures performances pour le ramasse-miettes. La variable utilisée pour itérer dans la boucle for est également en lecture seule maintenant.

La boîte à outils Ruby en Rails roule vers sa version 8.1. Il propose notamment la possibilité de reprendre des longues tâches en les découpant en étapes plus petites, permettant de reprendre à la dernière étape complètement effectuée plutôt que depuis le début si jamais la procédure a été interrompue. Une nouvelle interface Rails.event permet de structurer les événements pour être plus facilement analysés par des outils. Pour les développeurs il est possible de définir sa machine comme une instance pour lancer des tests d’intégration continue avec le binaire bin/ci. Enfin il permet de faire un rendu ou répondre à une requête directement depuis le format Markdown dans les différents contrôleurs.

Le générateur de protocoles protobuf passe à la version 6 et 5 pour respectivement le C++ et le C. Cette version introduit plus de modularité avec Bzlmod pour proposer un cœur plus réduit et plein de modules autour afin de simplifier la maintenance du projet. Cela peut simplifier l’import de modules externes par ailleurs. Ce changement pourrait simplifier la mise à niveau des adaptateurs pour les différents langages à l’avenir. Le paquet protobuf3 est toujours proposé à des fins de compatibilité, le format v3 du protocole ayant été supprimé dans ces nouvelles versions.

Le langage fonctionnel Erlang évolue vers la version 27. La syntaxe du langage autorise les commentaires multilignes et sans le besoin d’échappement grâce au délimiteur """ pour simplifier leur écriture. De manière analogue, il est possible de définir une chaine de caractères littérale sans caractères d’échappements avec le sigils ~B pour débuter la dite chaine de caractère qui est entre crochets. Le nouvel encodeur JSON est proposé afin d’améliorer les performances. Niveau performances, le client SSL peut aussi vérifier la signature du résultat de la réponse signée de l’OCSP d’un serveur pour vérifier si la clé a été révoquée ou non par le CA sans devoir effectuer des requêtes supplémentaires. Enfin à des fins de débogage ou de traçabilité il est possible de nommer les processus afin de savoir à quoi ils correspondent.

La bibliothèque d’analyse de données Pandas pousse à sa version 3. Cette version propose un nouveau type native pour les chaines de caractères plutôt que de reposer sur le type objet générique de Python qui n’est pas suffisamment spécifique ni performant pour cet usage. Le comportement du copy-on-write a changé, les opérateurs retournant un sous-ensemble ou une indexation d’une série de données fonctionnent comme une copie de l’objet original, nécessitant de manipuler directement l’objet original si on souhaite le modifier. Cela rend le comportement plus cohérent mais améliore aussi les performances. De nombreuses fonctions obsolètes ont été définitivement supprimées avec cette version, la rendant non rétrocompatible.

La bibliothèque xmlsec parse sa version 1.3. Cette version n’est pas non plus rétrocompatible avec la précédente. Elle propose un nouveau type KeyInfoReference pour permettre à plusieurs signatures de faire référence à la même chaine de validation au lieu d’avoir une copie entière pour chacune en mémoire. La recherche par clé est devenue plus stricte, uniquement les clés référencées dans KeyInfo sont considérées. La prise en charge du protocole FTP a été supprimée de même que la fonction de hashage md5 toutes deux pour des raisons de sécurité.

L’environnement de développement de Free Pascal nommé Lazarus dispose d’une interface graphique GTK3, Qt5 ou Qt6, en plus de GTK2 jusqu’alors proposée. Pour cela des sous-paquets ont été introduits tel que lazarus-ide-gtk3 qui ne sont pas installables en parallèle. Cela permet de proposer les différentes possibilités d’intégration de ce logiciel selon le goût de ses utilisateurs. Il permet aussi d’envisager le retrait à terme de la variante GTK2 quand cette bibliothèque obsolète sera entièrement retirée du système.

La configuration des pilotes ODBC, pour la création d’API pour les gestionnaires de base de données, a été scindée pour améliorer la modularité de ce fichier. Le fichier /etc/odbcinst.ini fait notamment le lien entre un module et la bibliothèque dans le système qui permettait de s’en servir et jusqu’ici tous les pilotes supportés étaient présents dans le fichier. Le fichier était proposé par le paquet unixODBC. Mais à cause du découplage entre le pilote et cette configuration, présent dans des projets et paquets différents, la configuration contenait souvent des informations fausses. Et ce n’était pas évident pour les empaqueteurs de ces bibliothèques de devoir intervenir sur ce fichier aussi s’ils changeaient quelque chose dans leur propre paquet. De plus, le fichier pouvait indiquer comment se servir d’un pilote qui n’est pas présent sur le système ce qui pouvait facilement mener à des erreurs. Maintenant les fichiers de configuration sont installés dans le dossier /usr/lib/odbc/odbcinst.d, avec un fichier par gestionnaire de base de données qui n’est installé que si le pilote correspondant est installé également. Chaque installation ou suppression permet de générer ainsi le fichier /etc/odbcinst.ini final avec les bonnes informations. Il est d’ailleurs possible pour les administrateurs systèmes d’adapter la configuration en créant des fichiers analogues dans /etc/odbc/odbcinst.d/ qui auront la priorité.

Nodejs a maintenant un métapaquet nodejs non versionné. Ce paquet non versionné sert à installer l’une des versions de Nodejs disponible dans Fedora Linux pour un utilisateur qui n’accorde pas trop d’importance à la version exacte. La version réellement installée est choisie par les mainteneurs et peut changer au gré des versions de Fedora Linux. Installer le paquet versionné tel que nodejs22 apporte la garantie qu’une mise à niveau de Fedora Linux n’aboutira pas à un changement de version de nodejs, à moins que le paquet ne soit évidemment supprimé et dans ce cas la transition est laissée à la charge à l’utilisateur.
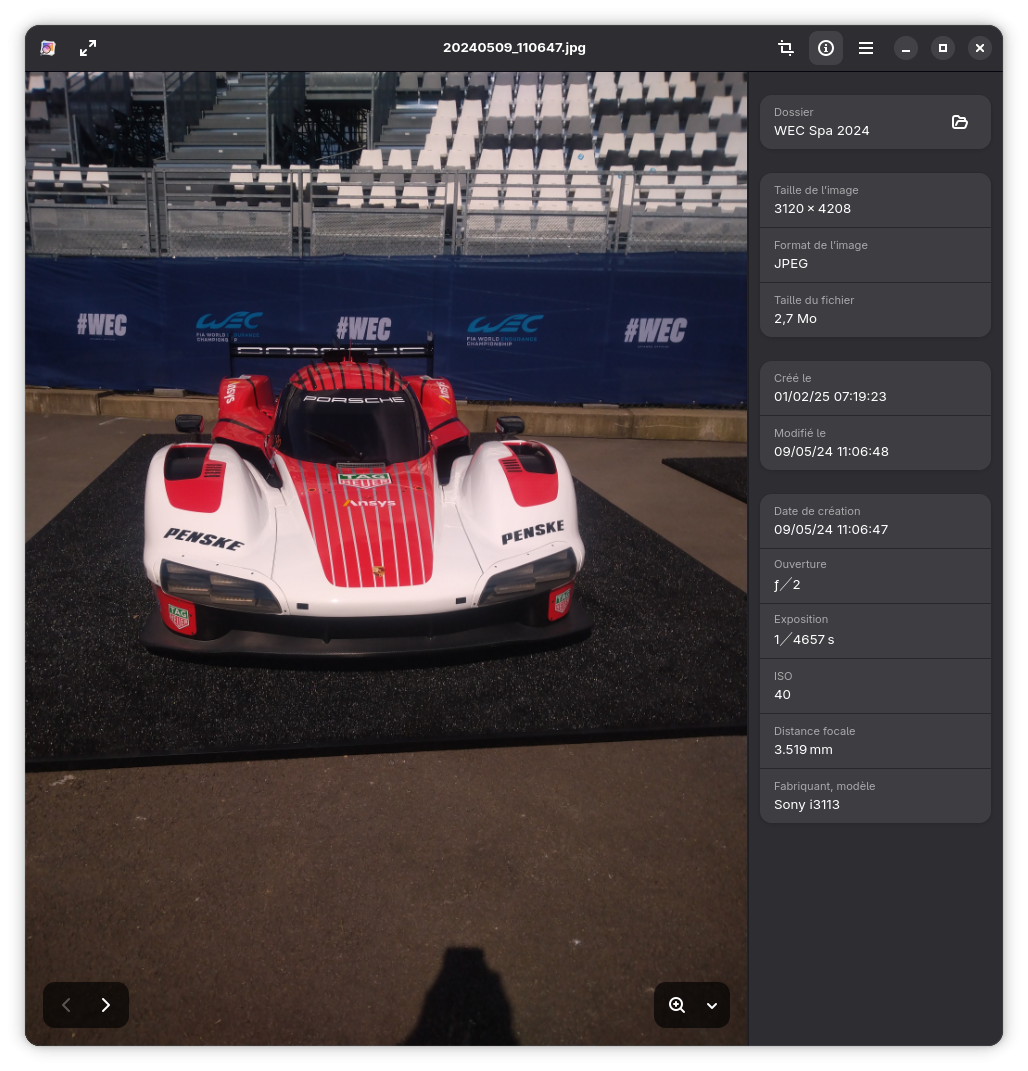
Plus de métadonnées dans GNOME Loupe

Projet Fedora

Les images atomiques à usage bureautique sont construites avec l’utilitaire image-builder. L’objectif est de se passer de lorax qui effectuait cette tâche jusqu’ici ce qui permettra à terme de s’en passer totalement pour simplifier l’infrastructure et les méthodes de production des différentes images. Ces images reposent en un fichier boot.iso au sein d’un commit ostree ce qui est très proche des images Fedora IoT qui utilisaient déjà image-builder, rendant l’opération possible.

Un autre bénéfice de cette migration est de permettre de générer des images au format qcow2 pour un usage pour machines virtuelles, ou une image raw pour l’architecture aarch64 afin de démarrer directement dessus avec l’outil arm-image-installer pour l’installer sur des petites cartes à architecture ARM.

Le paquet libgit2 bénéficiera de plusieurs paquets avec des versions distinctes pour pouvoir les installer en parallèle. Le paquet au nom générique disparaît pour faire place à libgit2_1.9. Ce composant utilisé par une trentaine de paquets n’a pas une ABI stable même pour des versions mineures. Cela peut rendre la gestion délicate au sein du projet Fedora pour ne pas avoir de conflits tout en ayant un résultat stable. En particulier par la présence de bibliothèques d’adaptation comme en Python qui évoluent à des rythmes différents langage par langage. Si pour l’instant une seule version de libgit2 est proposée, la voie est tracée pour en avoir plusieurs en parallèle.

Les variables non standards de CMake sont supprimées de la macro %cmake. Les variables *_INSTALL_DIR, SHARE_INSTALL_PREFIX et LIB_SUFFIX étaient passées par défaut par la macro %cmake alors que ces variables n’ont jamais été standards au sein de CMake. Chaque usage était donc spécifique à chaque logiciel avec parfois des confusions comme savoir si INCLUDE_INSTALL_DIR exigeait un chemin absolu ou relatif. Depuis CMake 3, les chemins d’installation standards sont définis dans GNUInstallDirs et son usage s’étend ce qui rend pertinent de pousser à migrer les paquets restants. Cela concernait tout de même environ 300 paquets sur les 2000 utilisant CMake.

Ajout de la macro %openpgpverify pour effectuer les vérifications de signatures d’artéfacts avec Sequoia en remplacement de %gpgverify qui utilise GnuGP. En effet depuis 2023, GnuGP suit un protocole incompatible avec OpenGPG nommé LibrePGP. L’objectif est d’utiliser une alternative compatible avec le standard OpenPGP ce qui est le cas de Sequoia déjà employé par RPM ou podman par ailleurs. Il permet également l’usage d’algorithmes post-quantique notamment par la prise en charge de la RFC 9980.

La communauté francophone

L’association
Logo de Borsalinux-fr

Borsalinux-fr est l’association qui gère la promotion de Fedora dans l’espace francophone. Nous constatons depuis quelques années une baisse progressive des membres à jour de cotisation et de volontaires pour prendre en main les activités dévolues à l’association.

Nous lançons donc un appel à nous rejoindre afin de nous aider.

L’association est en effet propriétaire du site officiel de la communauté francophone de Fedora, organise des évènements promotionnels comme les Rencontres Fedora régulièrement et participe à l’ensemble des évènements majeurs concernant le libre à travers la France principalement.

Si vous aimez Fedora, et que vous souhaitez que notre action perdure, vous pouvez :

  • Adhérer à l’association : les cotisations nous aident à produire des goodies, à nous déplacer pour les évènements, à payer le matériel ;
  • Participer sur le forum, les listes de diffusion, à la réfection de la documentation, représenter l’association sur différents évènements francophones ;
  • Concevoir des goodies ;
  • Organiser des évènements type Rencontres Fedora dans votre ville.

Nous serions ravis de vous accueillir et de vous aider dans vos démarches. Toute contribution, même minime, est appréciée.

Si vous souhaitez avoir un aperçu de notre activité, vous pouvez participer à nos réunions mensuelles chaque premier lundi soir du mois à 20h30 (heure de Paris). Pour plus de convivialité, nous l’avons mis en place en visioconférence sur Jitsi.

La documentation

Depuis juin 2017, un grand travail de nettoyage a été entrepris sur la documentation francophone de Fedora, pour rattraper les cinq années de retard accumulées sur le sujet.

Le moins que l’on puisse dire, c’est que le travail abattu est important : près de 90 articles corrigés et remis au goût du jour.
Un grand merci à Charles-Antoine Couret, Nicolas Berrehouc, Édouard Duliège, Sylvain Réault et les autres contributeurs et relecteurs pour leurs contributions.

La synchronisation du travail se passe sur le forum.

Si vous avez des idées d’articles ou de corrections à effectuer, que vous avez une compétence technique à retransmettre, n’hésitez pas à participer.

Comment se procurer Fedora Linux 45 ?
Logo de MediaWriter

Si vous avez déjà Fedora Linux 44 ou 43 sur votre machine, vous pouvez faire une mise à niveau vers Fedora Linux 45. Cela consiste en une grosse mise à jour, vos applications et données sont préservées.

Autrement, pas de panique, vous pouvez télécharger Fedora Linux avant de procéder à son installation. La procédure ne prend que quelques minutes.

Nous vous recommandons dans les deux cas de procéder à une sauvegarde de vos données au préalable.

De plus, pour éviter les mauvaises surprises, nous vous recommandons aussi de lire au préalable les bogues importants connus à ce jour pour Fedora Linux 45.

Commentaires : voir le flux Atom ouvrir dans le navigateur
  •  

Flus sort en 3.0

Flus est une plateforme de veille en ligne conçue pour suivre, lire, organiser et partager vos liens Web de manière simple. Elle s’intègre à votre écosystème d’outils existants pour compléter et éditorialiser votre veille.

Le 12 octobre dernier, j’ai sorti Flus en version 3.0. Cette nouvelle version majeure apporte des fils thématiques (l’équivalent des dossiers ou catégories dans les autres agrégateurs), un moteur de recherche plus puissant, et une nouvelle page pour gérer ses sources de manière avancée.

Logo de Flus

Flus est un logiciel libre sous licence AGPLv3 que je développe depuis 2020. Je le propose en SaaS, à prix libre, pour financer le développement de l’outil.

La dernière dépêche concernant Flus (flusio à l’époque) datant de 2021, je profite de cette sortie pour vous (re)présenter Flus de façon générale et vous détailler la feuille de route 2027.

Sommaire

Flus dans les grandes lignes

Présentation

Flus combine l’agrégation de flux, les listes « à lire plus tard » et le partage de signets pour vous éviter d’avoir à jongler entre trop d’outils. Il permet de :

  • Suivre des sources telles que des blogs, des podcasts ou des chaînes vidéo (flux RSS, Atom et JSON), ainsi que des collections partagées sur Flus.
  • Lire à votre rythme grâce au journal qui vous propose une sélection configurable de liens issus des sources que vous suivez, ainsi qu’aux listes « À lire » et « Liens lus ».
  • Ranger vos liens dans des collections pour les retrouver facilement. Vous pouvez prendre des notes et ajouter des #tags pour mémoriser ce que vous en avez pensé et préparer vos prochaines productions.
  • Partager vos liens, vos collections et vos fils publiquement sur votre profil pour que d’autres personnes puissent vous suivre, ou en privé pour collaborer avec des personnes en particulier.

Bref, si vous utilisez FreshRSS, wallabag et/ou Shaarli : c’est un peu les trois à la fois ! Mais évidemment pas tout à fait : par exemple, Flus ne permet pas (encore) de lire directement les articles dans l’application, il n’archive pas non plus (encore) les articles et il ne permet pas (encore) de prendre des notes en dehors du bloc-notes des liens.

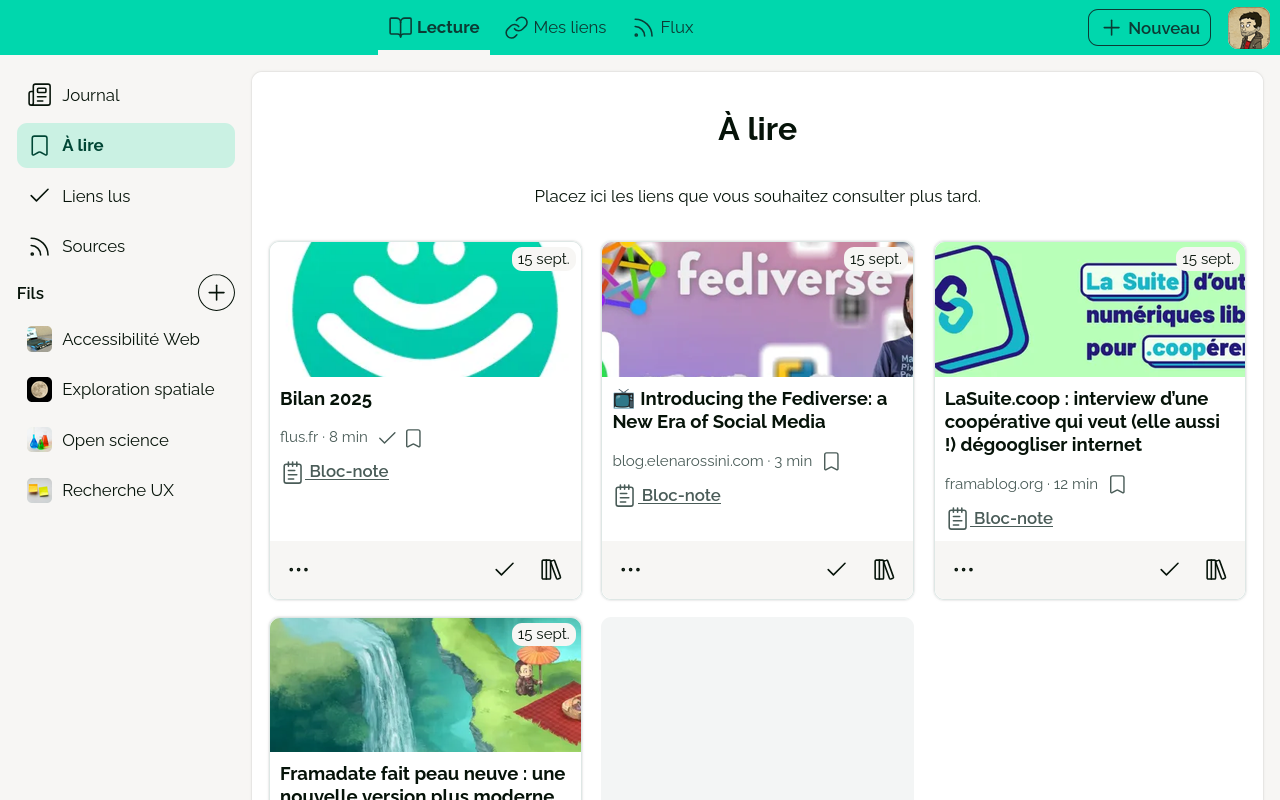
L’écran « À lire » affichant plusieurs liens à lire plus tard.

Stack technique et contributions

Flus est une application Web écrite en PHP, reposant sur Minz, mon framework maison. Côté interface, les templates sont écrits grâce au moteur Twig. Si le JavaScript est requis pour un certain nombre d’actions, on reste sur des technologies assez légères : Turbo et Stimulus. La seule base de données prise en charge est PostgreSQL. Flus a finalement assez peu de dépendances, ce qui me permet de mieux maîtriser la stack technique.

La documentation pour déployer concerne uniquement mon propre environnement de production : Git, Nginx, PHP, PostgreSQL. Je ne fournis pas d’image Docker de production, mais le Dockerfile et le docker-compose.yml de développement peuvent servir de base pour qui serait intéressé·e.

Un fichier détaille comment contribuer, néanmoins je restreins volontairement les possibilités car il m’est compliqué de trouver le temps d’accueillir des contributions en gérant tous les autres aspects (communication, infrastructure, support, etc.).

Du financement de Flus

Je développe Flus à mon compte depuis 2020. L’offre SaaS existe depuis le début : cela m’a permis de payer largement les serveurs ainsi que quelques prestations pour m’aider sur les aspects que je maîtrise moins (ex. le juridique ou les productions visuelles). Je ne me suis en revanche jamais payé un salaire mirobolant ; seulement de quoi mettre un peu de beurre dans les épinards. Désolé de décevoir les personnes qui pensaient que fournir un service en SaaS était un bon plan !

C’est par le biais d’un travail à mi-temps que j’ai trouvé l’équilibre nécessaire pour avancer sur Flus. Je ne consacre ainsi qu’une semaine sur deux au projet, le reste de mon temps étant passé au sein de la SCOP Probesys. Ce n’était absolument pas la solution que j’envisageais initialement, mais ça marche plutôt bien.

Le prix libre que je propose (entre 0 et 120 € par an) est globalement bien compris, notamment parce que je donne quelques seuils :

  • 15 € / an : le tarif solidaire pour celles et ceux qui ne sont pas prêts à dépenser plus, mais qui souhaitent tout de même soutenir le projet.
  • 30 € / an : le tarif équilibre que je juge comme étant le plus juste au regard du service que je propose et de mon objectif financier.
  • et le tarif soutien, qui évolue en fonction de mon objectif financier et du nombre d’abonné·es.

On le verra néanmoins plus loin dans cette dépêche, cela pourrait évoluer en 2027 avec l’arrivée prochaine d’une offre Pro.

Notons que le service va bientôt fêter son septième anniversaire. Ce sera l’occasion de publier un nouveau bilan, à la suite des précédents. Ces bilans abordent plutôt l’aspect « entrepreneurial », mais il me semble que le lectorat de LinuxFr est généralement friand de cela 😉

Les nouveautés de la 3.0

Assez digressé, que renferme donc Flus 3.0 ?

Des fils thématiques

Les fils répondent à deux besoins principaux :

  1. Créer des espaces de veille contextuels permettant de séparer votre veille personnelle de votre veille professionnelle, par exemple.
  2. Gérer les sources les plus prolifiques grâce à un système de filtres avancés pouvant être enregistrés sous forme de vues.

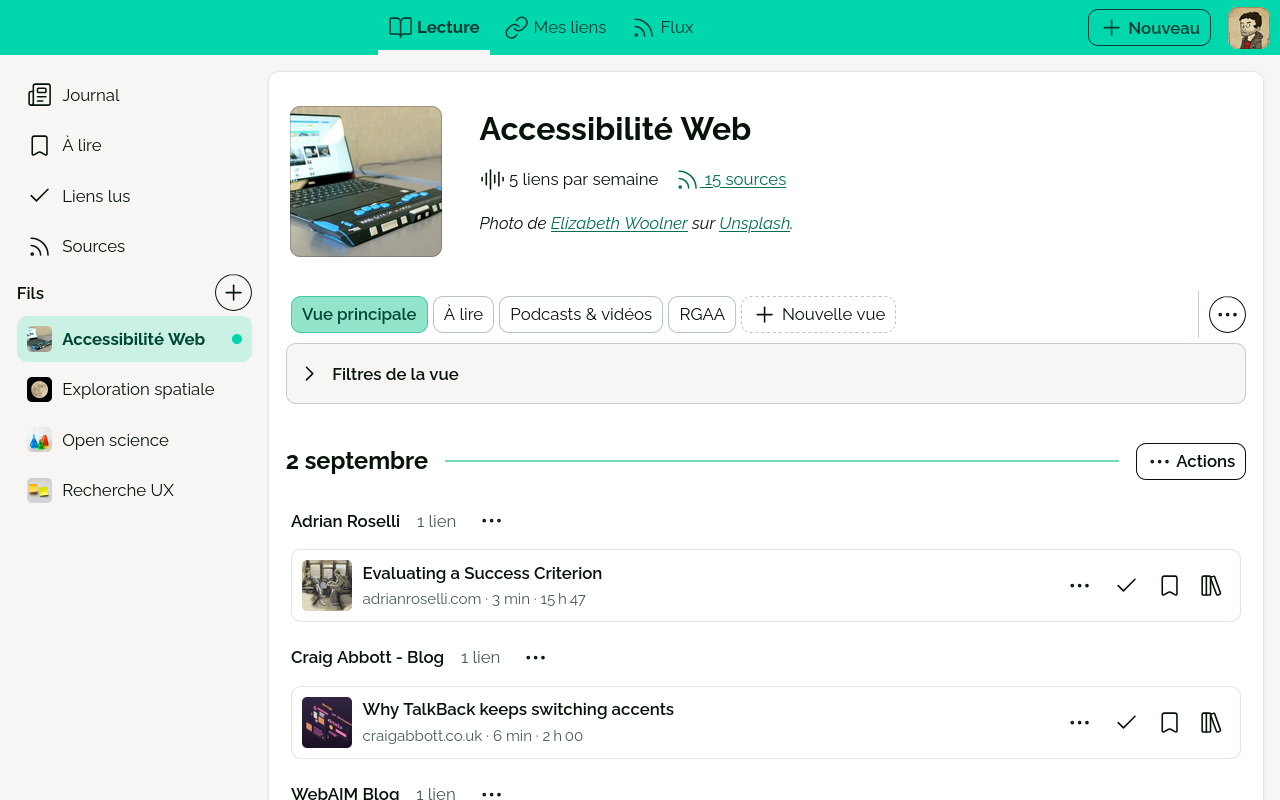
L’écran Lecture de Flus sur ordinateur, avec un fil de veille « Accessibilité Web » et ses liens du jour.

Concrètement, vous pouvez associer vos sources (flux Web et/ou collections Flus) à des fils que vous retrouvez dans le menu de navigation, à gauche de l’écran. Oui, comme les dossiers ou catégories dans les autres agrégateurs de flux. Mais les fils offrent quelques possibilités en plus :

  • ils peuvent être filtrés : par date, mots-clés, statut de lecture ou source ;
  • ces filtres peuvent être enregistrés sous forme de vues accessibles en un clic ;
  • les fils peuvent également être partagés, que ce soit publiquement (voici par exemple mon fil « Planet Flus ») ou avec des personnes spécifiques pour construire une veille commune.

Un moteur de recherche amélioré

Le moteur de recherche a été revu et grandement amélioré. Il est maintenant possible d’exprimer des recherches complexes :

  • la combinaison de mots avec l’opérateur AND (par défaut), l’alternative avec OR, ou encore l’exclusion avec NOT ;
  • le groupement avec les parenthèses, par exemple : (rapport OR étude) NOT #archive ;
  • la recherche par attributs, notamment par date (ex. date: 2026-10), par durée de lecture (duration: >10), ou en recherchant au sein de vos notes (notes: rapport).

Un écran d’aide intégré au champ de recherche permet de connaître les différentes possibilités.

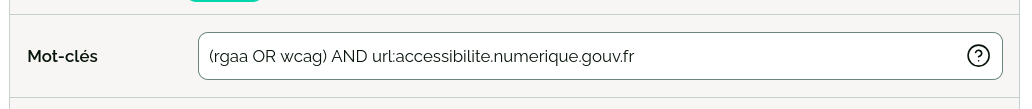
Capture d’écran montrant un champ texte de filtre.

Une nouvelle page pour vos sources

Une nouvelle page, nommée « Sources », permet de lister les flux et les collections Flus que vous suivez. Depuis cette page, il est maintenant possible de :

  • Rechercher et filtrer vos sources : pratique pour en retrouver une précisément, ou pour lister toutes les sources désormais inactives, par exemple.
  • Gérer vos abonnements (paramétrage pour le journal, ajout au sein des fils, désabonnement), que ce soit individuellement au niveau de chaque source, ou de manière groupée grâce aux actions de masse.

Capture d’écran montrant un formulaire de filtre et des sources.

Des améliorations diverses

Les trois nouveautés présentées ci-dessus changent fondamentalement la manière d’interagir avec Flus. Mais d’autres évolutions viennent compléter le tableau pour une utilisation plus agréable :

  • La possibilité de renommer une source et d’en changer l’illustration (pratique quand un flux déclare un nom obscur ou beaucoup trop long).
  • Une barre d’édition et des raccourcis pour l’éditeur de texte Markdown : juste de quoi ne pas avoir à tout mémoriser… en attendant des travaux plus conséquents !
  • La prolongation de la durée de session pour ne pas avoir à se reconnecter tous les mois si l’on se connecte régulièrement.

Les plans 2027 : entre travail en équipe et offre Pro

Cette 3.0 constitue déjà une version très complète, mais c’est loin d’être fini ! La feuille de route adoptée pour 2027 est claire (et sans doute ambitieuse) : permettre à des équipes d’organiser leur veille facilement à plusieurs. Voici les fonctionnalités prévues à ce stade :

  • Les organisations disposeront de leurs propres collections et fils, pourront gérer leurs membres et les répartir en équipes.
  • Un mécanisme de feedback léger (émoji + court commentaire) permettra de réagir aux liens et notes des autres membres d’une organisation.
  • Les notes pourront être mises en avant pour aider à contextualiser les liens au sein des collections.
  • Des synthèses pourront être produites pour préparer, par exemple, une newsletter, un article de blog, ou un document PDF à distribuer à ses collègues.
  • Enfin, le mécanisme pour partager les accès aux collections et aux fils sera simplifié (le fonctionnement actuel étant peu intuitif).

Ces éléments constitueront la base d’une offre Pro destinée aux entreprises, associations, universités, etc. Cette offre doit me permettre de dépasser (enfin !) le seuil des 5 000 € de chiffre d’affaires annuel, ce qui ne serait pas du luxe.

Toutes les fonctionnalités développées dans ce cadre seront sous licence libre AGPLv3, mais il n’est pas impossible que certaines soient limitées à l’offre Pro dans la version SaaS (à priori, celles qui impliqueront une utilisation plus intensive des ressources du serveur).

Rendez-vous ici dans un an, lors de la sortie de la 4.0 ? 🙂

Commentaires : voir le flux Atom ouvrir dans le navigateur
  •  

Capitole du Libre les 14 & 15 novembre 2026 à Toulouse

Le Capitole du Libre est un week-end dédié au Logiciel Libre et à la culture libre en Occitanie. Cette année, la treizième édition se tiendra les samedi 14 et dimanche 15 novembre 2026 à l’INP-N7 en centre‐ville de Toulouse.

Logo du Capitole du Libre

Comme chaque année, Toulouse va connaitre les 14 et 15 novembre un week-end placé sous le signe du partage communautaire, autour du numérique et des solutions libres. L’entrée est gratuite, sur simple inscription en ligne.

Sous le slogan « L’événement du Logiciel Libre et de la culture libre en Occitanie », le Capitole du Libre s’adresse à toute personne : novice curieuse, bidouilleuse confirmée, passionnée, ou simple flâneuse numérique.

Que nous réserve ce week-end libre & convivial ?

  • Beaucoup de personnes ont voulu partager leur passion en proposant de nombreuses présentations parmi lesquelles près de 120 conférences et 10 ateliers ont été retenues. Au menu : sécurité informatique, DevOps, développement web, création graphique libre, jeux libres, enjeux sociétaux autour du numérique ouvert, de nombreux débats sur l'Intelligence Artificielle et ses impacts, il y en aura pour tous les goûts !
  • Un village associatif riche de personnes engagées du libre : discutez avec de nombreuses associations et leurs bénévoles. C'est l'occasion de découvrir, et pourquoi pas, de s’impliquer !
  • Un espace “Adoptez le logiciel libre” : que ce soit pour installer Linux ou simplement poser vos questions, des bénévoles efficaces seront là pour vous renseigner, et peut-être repartir avec des outils libres ! L'atelier est ouvert aux propriétaires d'ordinateurs mais aussi de téléphones. Organisé en collaboration avec le club informatique de l'N7.
  • Un atelier "Initiation au Code" : venez découvrir de manière ludique le code. L'atelier est adapté à tous les âges (y compris les plus jeunes) et est réalisé en collaboration avec l'EPITECH.
  • Et bien sûr, la convivialité : un week-end pour rencontrer de nouvelles personnes, échanger avec les habitué·e·s, et surtout apprendre dans une ambiance détendue. Le samedi soir, un moment festif est prévu.

Deux conférences plénières

Quelques exemples de conférences/ateliers

Pourquoi faut-il y aller ?

Le libre ne se limite pas au code : c’est d'abord une culture et des valeurs partagées, des projets humains qui se construisent ensemble.
Nous avons la chance de vivre dans une région peuplée de passionnés de technologie libre, et comme le Capitole du Libre attire aussi des visiteurs·ses de bien au delà de l'Occitanie, c'est un rendez-vous à ne pas manquer pour aller à leur rencontre.
Que l'on souhaite y passer par simple curiosité, découvrir de nouvelles choses, ou bien retrouver d'autres passionné·e·s, toutes et tous sont les bienvenues !
Et en plus c'est gratuit, alors pourquoi se priver ?

Infos pratiques

  • 📅 Dates : samedi 14 et dimanche 15 novembre 2026.
  • 📍 Lieu : INP-N7, 2 rue Charles Camichel, 31000 Toulouse.
  • 🎟️ Entrée gratuite, mais inscription en ligne obligatoire.
  • ✅ Ouvert à tous les ages et tous les niveaux.
  • 🍴 Sur place : food-trucks pour les midis (et de nombreux choix à l'extérieur dans le quartier).

Affiche

En un mot

Avec le Capitole du Libre, plongez dans l’univers du libre sous toutes ses formes : un lieu de découvertes, de rencontres et de partages.
Réservez votre week-end : inscrivez-vous gratuitement et venez vivre le numérique autrement !

Commentaires : voir le flux Atom ouvrir dans le navigateur
  •  

Découverte du langage Elixir

Beaucoup de Rust par-ci… Un peu de Go par-là… Saupoudrez de LLM selon vos goûts et vous aurez une bonne photographie des sujets qui préoccupent les développeurs sur l'Internet d'aujourd'hui.
Alors, n'est-ce pas le meilleur moment pour se rafraîchir l'esprit avec des langages plus discrets ?
Je vous propose ici une présentation accélérée d'Elixir.

Sommaire

Un langage de programmation fonctionnelle

Ceux qui ont déjà fait de la programmation orientée objet organisent principalement leur code autour d'objets et d'instances. Cette approche a ses avantages, mais cela nécessite d'encapsuler la donnée et la gestion des changements d'état peut parfois devenir complexe.
De son côté, la programmation fonctionnelle privilégie les fonctions qui, au lieu de masquer les données, transforment simplement des entrées en sorties.
Elixir s'appuie essentiellement sur ce paradigme.

Correspondance de motifs (ou Pattern matching)

En Elixir, le signe égal n'est pas une affectation mais plutôt une assertion.
Ainsi, on n'affecte ou ne modifie la valeur que de la variable située à gauche du signe égal. À droite, la variable est remplacée par sa valeur. Exemple avec iex, la console interactive :

iex> a = 2
2
iex> 2 = a
2
iex> 1 = a
** (MatchError) no match of right hand side value: 2

Cette ligne de code échoue car elle équivaut à 1 = 2, ce qui provoque une erreur.
À noter que le caractère _ sert à ignorer une valeur, ainsi :

iex> [1, _, _] = [1, 2, 3]
[1, 2, 3]

La correspondance de motifs en Elixir est similaire à celle d'Erlang (ces deux langages utilisent la même VM).
Joe Armstrong, le créateur d'Erlang, compare ce signe égal à celui utilisé en algèbre : lorsque vous écrivez l'équation x = a + 1, vous n'attribuez pas la valeur de a + 1 à x.
Cette correspondance sert essentiellement à vérifier la forme d'une valeur, à en extraire des éléments et à traiter différemment les résultats d'une opération selon qu'elle réussit ou échoue.
Tout cela est un peu déroutant au début mais très puissant.

Module, fonctions et clauses de garde

Dès qu'un programme dépasse quelques lignes, il devient nécessaire de le structurer.
En Elixir, les fonctions nommées doivent être écrites à l'intérieur de modules :

defmodule BestMovie do
  def ever(name) do
    IO.puts "Le meilleur film de tous les temps est `#{name}`."
  end
end
BestMovie.ever("La cité de la peur") #=> Le meilleur film de tous les temps est `La cité de la peur`.

De son côté, la macro defp définit une fonction privée, c'est-à-dire une fonction qui ne peut être appelée qu'au sein du module qui la déclare :

defmodule MonModule do
  def fonction_publique do
    fonction_privée()
  end

  defp fonction_privée do
    IO.puts "Je suis appelé depuis une fonction privée"
  end
end
MonModule.fonction_privée()   #=> ** (UndefinedFunctionError) function MonModule.fonction_privée/0 is undefined or private.
MonModule.fonction_publique() #=> Je suis appelé depuis une fonction privée

En Elixir, la correspondance de motifs s'applique aux arguments des fonctions : plusieurs peuvent porter le même nom mais le langage choisira la fonction dont les motifs correspondent aux arguments.
Au moyen du mot clé when, les clauses de garde permettent d'étendre cette correspondance de motifs à des vérifications plus complexes comme la distinction des types d'arguments ou un test portant sur leurs valeurs :

defmodule GuardClause do
  def what_is(x) when is_number(x) and x > 0 do
    IO.puts "#{x} est un nombre positif"
  end

  def what_is(x) when is_list(x) do
    IO.puts "#{inspect(x)} est une liste"
  end
end
GuardClause.what_is(99)      #=> 99 est un nombre positif
GuardClause.what_is([1,2,3]) #=> [1,2,3] est une liste

Toutes les expressions ne sont pas autorisées dans les clauses de garde, mais seulement quelques-unes.
Il s'agit d'un choix délibéré du langage pour garantir une exécution efficace.

Listes et récursivité

En Elixir, une liste peut être vide ou se composer d'une tête et d'une queue. La tête (head) contient une valeur et la queue (tail) est elle-même une liste :

iex> [ head | tail ] = [ 1, 2, 3 ]
[1, 2, 3]
iex> head
1
iex> tail
[2, 3]

Ainsi, une liste à un seul élément (que nous écririons habituellement sous la forme [4]) peut s'écrire comme la valeur 4 jointe à une liste vide, soit [ 4 | [ ] ].
Cette définition permet d'aborder certains problèmes de manière récursifs et donc sans s'appuyer sur une variable de boucle et/ou les traditionnels if et else :

defmodule MyList do
  def flip([]), do: []
  def flip([ head | tail ]) do
    flip(tail) ++ [head] # `++` permet de concaténer des listes
  end
end
MyList.flip([1, 2, 3, 4, 5]) #=> [5, 4, 3, 2, 1]
# Explication pas à pas :
#   flip([1, 2, 3, 4, 5])
#     ↳ flip([2, 3, 4, 5]) ++ [1]
#         ↳ flip([3, 4, 5]) ++ [2] ++ [1]
#             ↳ flip([4, 5]) ++ [3] ++ [2] ++ [1]
#                 ↳ flip([5]) ++ [4] ++ [3] ++ [2] ++ [1]
#                     ↳ flip([]) ++ [5] ++ [4] ++ [3] ++ [2] ++ [1]
#                         ↳ [] ++ [5] ++ [4] ++ [3] ++ [2] ++ [1]
#                             ↳ [5, 4, 3, 2, 1]

Note : l'usage de ++ est moins efficace qu'une version utilisant une variable pour accumuler le résultat mais cette approche reste plus didactique pour découvrir la récursion.

L'opérateur pipe

Nous avons tous déjà croisé du code séquentiel où chaque étape dépend du résultat de la précédente :

  cart = ShoppingCart.for_user(user_id)
  items = Inventory.check_availability(cart)
  total = Pricing.calculate_total(items, tax: 1.2)

L'ordre des opérations est clair, mais au final les variables intermédiaires sont là pour éviter des appels imbriqués :

Pricing.calculate_total(
  Inventory.check_availability(
    ShoppingCart.for_user(user_id)
  ),
  tax: 1.2
)

Elixir propose d'écrire ce type de code d'une façon fluide et sans variable intermédiaire :

user_id
|> ShoppingCart.for_user()
|> Inventory.check_availability()
|> Pricing.calculate_total(tax: 1.2)

L'opérateur |> prend le résultat de l'expression située précédemment et l'insère en tant que premier paramètre de l'appel de la fonction suivante.

L'exercice sympa qui utilise tout ça (ou presque)

Maintenant que vous avez les bases, je vous propose un exercice qui m'avait bien plu lorsque j'ai découvert le langage au travers le livre de Dave Thomas : trouver un nombre compris dans un intervalle donné (ex : 1..100 dans une expression ou 1..100//1 pour effectuer une correspondance de motifs, //1 correspondant au pas).
Il existe plusieurs façon de résoudre le problème mais voici ma solution :

defmodule Devine do
  def en_tatonnant(cible, min..max//1) when is_integer(cible) and is_integer(min) and is_integer(max) and cible > min and cible < max do
    estimation = div(min + max, 2)
    IO.puts "Est-ce #{estimation} ?"
    guess(cible, min..max, estimation)
  end
  def en_tatonnant(cible, min..max//1) when not is_integer(cible) or not is_integer(min) or not is_integer(max) or cible < min or cible > max do
    IO.puts "Très drôle…"
  end
  defp guess(cible, min.._//1, estimation) when estimation > cible do
    IO.puts "Non, c'est plus petit… Maintenant on va rechercher entre #{min} et #{estimation}"
    en_tatonnant(cible, min..estimation)
  end
  defp guess(cible, _..max//1, estimation) when estimation < cible do
    IO.puts "Non, c'est plus grand… Maintenant on va rechercher entre #{estimation} et #{max}"
    en_tatonnant(cible, estimation..max)
  end
  defp guess(cible, _, estimation) when estimation == cible do
    IO.puts "Mais oui, c'est bien #{estimation} 🤩"
  end
end
Devine.en_tatonnant(273, 1..1000)
#=> Est-ce 500 ?
#=> Non, c'est plus petit… Maintenant on va rechercher entre 1 et 500
#=> Est-ce 250 ?
#=> Non, c'est plus grand… Maintenant on va rechercher entre 250 et 500
#=> Est-ce 375 ?
#=> Non, c'est plus petit… Maintenant on va rechercher entre 250 et 375
#=> Est-ce 312 ?
#=> Non, c'est plus petit… Maintenant on va rechercher entre 250 et 312
#=> Est-ce 281 ?
#=> Non, c'est plus petit… Maintenant on va rechercher entre 250 et 281
#=> Est-ce 265 ?
#=> Non, c'est plus grand… Maintenant on va rechercher entre 265 et 281
#=> Est-ce 273 ?
#=> Mais oui, c'est bien 273 🤩

Et maintenant

Vous vous doutez bien que je n'ai fait qu'effleurer le sujet mais j'ai trouvé le langage Elixir tellement singulier que je n'ai pas résisté à l'envie de vous le présenter.
Je continue ma découverte de ce langage, à mon rythme ; en ce moment, j'aborde la programmation concurrente.
À n'en pas douter, j'enchaînerai sur le framework Phoenix !

Commentaires : voir le flux Atom ouvrir dans le navigateur
  •  

Hadron, le futur de macOS court-circuite tout macOS

Un hadron est une particule composite, composée de particules subatomiques régies par l'interaction forte, nous dit Wikipédia. Si cela vous fait penser à Proton, ce n’est peut-être pas parce qu’un proton est un hadron, mais parce que Hadron, comme Proton, promet de faire tourner vos jeux (et plus) n’importe où, même sur des systèmes terreux.

Logo Hadron

Vous connaissez peut-être Proton, l’assemblage de Wine et d’autres composants libres que Valve emploie pour faire tourner des jeux Windows sous Linux pour sa plate-forme Steam. Hadron propose la même chose pour macOS.

Des jeux Windows ? Sous macOS ? Quel est le 🌀️💀️⚡️⁉️ de rapport avec LinuxFr.org et son objectif de promotion des logiciels libres ? C’est parce que Hadron est construit de briques libres du sol au plafond : Wine, FEX, Mesa, vkd3d…

Sommaire

7zFM sur macOS et Apple Silicon grâce à HadronLe logiciel libre 7zFM pour Windows x86-64 s‘exécutant sur un Mac mini M1 sous macOS 27 sans utiliser Rosetta 2.

Le développement de Hadron est encore très jeune, confidentiel, mais très rapide et réactif. Votre serviteur a testé de faire tourner le jeu libre Unvanquished et a rencontré deux bugs (1, 2) qui ont tous deux été corrigés dans les deux jours (1, 2), et une nouvelle version incorporant les correctifs a été publiée sous cinq jours (1).

Les spéculations sur « qui est derrière Hadron » pourraient se tourner naturellement vers Valve, qui est le premier bénéficiaire économique d’un tel système, mais le README du projet Hadron est explicite : « It is unofficial. Hadron is not affiliated with or endorsed by Valve, Apple, CodeWeavers or any of the projects it builds on », « C’est un projet non officiel. Hadron n’est ni affilié à, ni approuvé par Valve, Apple, CodeWeavers ou l’un des projets sur lesquels il s’appuie ».

Il semble donc que Hadron soit simplement l’initiative de son auteur David Andrews (Broyojo), ni plus ni moins.

Au delà de la proximité de nom entre Hadron et Proton, Hadron reste délibérément focalisé sur Steam : la fenêtre qui s’affiche quand vous lancez Hadron ne sert qu’à intégrer Hadron à Steam, et les premières versions ne proposaient d’ailleurs pas d’option pour lancer un programme non-Steam (fonctionnalité ajoutée très rapidement en quelques jours aussi). Le but premier de Hadron est Steam, et quand vous rapportez un bug pour un jeu, il vous est demandé l’identifiant Steam de ce jeu (cet identifiant est heureusement optionnel).

Pourquoi Hadron ?

En 2027, Apple sortira macOS 28 et à cette occasion, a prévu de drastiquement réduire l’étendue de la compatibilité Rosetta 2. Rosetta 2 est le système de traduction automatique qui permet de faire tourner des binaires amd64 (x86-64) sur arm64 (Apple Silicon ici, dans les macs « M »). Rosetta 2 a un 2 parce que Rosetta premier du nom s’occupait de traduire les binaires PowerPC vers Intel il y a très longtemps. Par commodité nous dirons simplement Rosetta au lieu de Rosetta 2 dans la suite de l’article.

Apple a annoncé que Rosetta ne sera plus disponible pour les applications, mais qu’ils conserveront une petite sous-partie prévue uniquement pour faire tourner des vieux jeux non maintenus s'appuyant sur des bibliothèques pour Intel (« we will keep a subset of Rosetta functionality aimed at supporting older unmaintained gaming titles, that rely on Intel-based frameworks » (source). C’est une affirmation super floue. Que restera-t-il de Rosetta ? Sur quoi pourra-t-on compter et ne pas compter ?

Pour Apple, décommissionner Rosetta a un intérêt : ne plus fournir toutes les bibliothèques systèmes en double, ne plus avoir à apporter de la maintenance et du code système pour l’architecture amd64, etc. Tout l’effort de migration vers arm64 est entièrement externalisé vers le développeur indépendant. Ça coûte très cher à l’échelle globale, mais rien du tout pour Apple, et leur clientèle est suffisamment captive pour que le développeur au milieu y soit contraint. Si un développeur échoue à porter son logiciel, le développeur perdra des ventes, mais pas nécessairement Apple. Ce n’est pas le problème d’Apple, surtout quand l’acquisition du logiciel a lieu probablement en dehors de leur marché. Ceci est d’autant plus vrai en dehors du jeu : un logiciel de production concurrent remplace facilement un autre s’il venait à disparaître.

Pour un consommateur de jeu, c’est insupportable : il ne veut pas perdre son jeu parce que le développeur ne le développe plus. Il y a un attachement affectif, le joueur y a investi une partie de sa vie, il peut être attaché à l’histoire, etc. Et si le jeu est encore développé, le joueur ne trouve pas d’intérêt à ce que le développeur se retrouve avec plus de travail qui ne lui apportera aucun changement en jeu. Rajouter gratuitement du travail au développeur de jeu n’apporte rien au joueur.

Et pour une plate-forme tierce de vente et de location de logiciels comme Steam et autre GOG GALAXY, c’est une catastrophe : si un développeur échoue à porter son logiciel, ou n’est plus disponible pour cette tâche, ce sont des ventes en moins pour le développeur et pour le vendeur. Un vendeur de jeux qui prend sa commission à chaque vente (et dont ce serait la première sinon la seule activité économique) a intérêt à ce que le moindre effort soit proposé aux développeurs de jeux.

L’architecture de Hadron

Ne pas confondre avec le Grand collisionneur de hadrons ! L’architecture de Hadron est très différente, mais fait aussi se rencontrer plein de particules élémentaires libres pour observer des effets très intéressants.

Diagramme de l’architecture de Hadron Diagramme de l’architecture de Hadron, telle que décrite dans la documentation du projet.

FEX, le traducteur automatique d’instruction processeur

Comme alternative à Rosetta pour traduire les instructions amd64 vers arm64 pour exécuter des logiciels, il existe au moins deux logiciels libres : FEX (dont le développement était initialement secrètement soutenu par Valve), et Box64 développé par notre ptitSeb national.

Ces deux logiciels libres ont été à la base développés pour s’exécuter sous Linux. Hadron a choisi FEX et le fait tourner sous macOS. Ainsi, plus besoin de compter sur Rosetta et d’être dépendant du bon-vouloir d’Apple !

Le choix de FEX correspond bien à l’écosystème de Valve : l’intégration de FEX peut prendre exemple sur celle déjà réalisée pour Steam sur le Steam Frame (un produit de réalité virtuelle tournant sous Linux et sur ARM), et permet d’hériter des tests déjà réalisés par Valve pour le Steam Frame.

En intégrant FEX, Hadron rend les jeux et autres logiciels indépendants de la volonté d’Apple d’abandonner la prise en charge de l’architecture x86.

Wine, l’implémentation libre des API Windows

On ne présente plus Wine, le logiciel libre qui permet de faire tourner depuis des décennies des programmes Windows sous Linux, BSD et macOS. En 2022 Arek Hiler avait prononcé la désormais célèbre phrase Win32 Is The Only Stable ABI on Linux, Win32 est la seule interface binaire de programmation qui soit stable sous Linux. Ce constat de l’ABI Win32 comme une interface très stable s’étend en fait bien au-delà des utilisateurs de Linux.

Wine est une brique fondamentale de Proton, la sous-couche de Valve pour faire tourner des jeux Windows sous Linux. Hadron fait de même pour macOS.

Hadron intègre donc FEX et Wine pour faire tourner des programmes Windows compilés pour x86 (32-bit et 64-bit) sur les macs exécutant macOS sur des processeurs ARM. L’héritage Wintel ne s’effacera donc jamais.

En intégrant Wine, Hadron rend les jeux et autres logiciels indépendants des interfaces de programmation de macOS.

Mesa, Zink et KosmicKrisp

Mesa est la collection de pilotes graphiques libres qui domine nos écosystèmes Linux et BSD. Mais Mesa propose aussi des pilotes pour d’autres plate-formes, comme Windows et macOS.

L’article Le pilote open-source Vulkan pour AMD “RADV” de chez Mesa bientôt disponible sous Windows ? posait ce constat en répondant à la question « Et pour Vulkan sur macOS ? » :

En participant au développement de RADV sous Linux et Windows, Valve se donne le pouvoir de contrôler la qualité de la pile logicielle d’exécution des jeux qu’ils vendent, jusqu’au pilote graphique inclus.

Pour macOS, la solution n’est pas à voir du côté de RADV (les derniers macs n’ont plus de cartes graphiques AMD de toute façon), mais du côté de MolktenVK et KosmicKrisp, des pilotes libres convertissant les appels Vulkan vers l’API Metal de macOS.

Sur macOS Vulkan est déjà disponible grâce à MoltenVK, une implémentation libre traduisant Vulkan pour l’API propriétaire Metal de macOS. Valve a investi dans MoltenVK. Cela permet par exemple à Valve de faire tourner leur jeu Dota2 sur macOS et pouvoir continuer à le vendre aux utilisateurs de macOS sans se soucier de l’obsolétisation d’OpenGL sur macOS par Apple.

KosmicKrisp est lui un pilote Mesa qui fait de même (convertir Vulkan vers Metal) mais de façon intimement spécialisée pour les puces AGX que l’on trouve dans les ordinateurs Apple M1, M2, etc. (aussi appelé « Apple Silicon »).

Et vous le voyez venir en mille, Hadron intègre KosmicKrisp pour fournir la prise en charge de l’API graphique Vulkan. KosmicKrisp traduit les appels Vulkan vers l’Interface de programmation (API) propriétaire Metal.

En intégrant KosmicKrisp, Hadron rend les jeux et autres logiciels indépendants de la politique d’Apple refusant de prendre en charge le standard industriel Vulkan.

Mais, et pour OpenGL ? Zink est un pilote Mesa qui implémente OpenGL au dessus de Vulkan, quel que soit le système (Zink tourne déjà sous Linux et Windows, et donc aussi macOS comme on peut le voir). Voilà, problème résolu.

En fait macOS fournit déjà OpenGL, mais ils l’ont déclaré obsolète depuis longtemps et ne fournissent qu’une ancienne version 4.1 qui date de 2010 (16 ans déjà !) qui est 7 ans plus ancienne que la dernière version d’OpenGL (4.6).

Zink implémente donc OpenGL 4.6 et en intégrant Zink, Hadron rend les jeux et autres logiciels indépendant de la volonté d’Apple d’abandonner OpenGL.

Et au passage, Zink propose la dernière version d’OpenGL et est un pilote désormais bien connu des développeurs de jeu, c’est tout bénef !

Hadron a comme politique de favoriser Zink à la place de l’implémentation OpenGL maison d’Apple. Quand un des bugs donnés comme exemple et affectant Unvanquished a été rapporté, l’expérimentation avait été réalisée avant que Hadron ne propose un moyen simple de lancer un logiciel en dehors de Steam, et donc l’expérimentation avait été faite en appelant Wine directement sans passer par le lanceur de Hadron. Le développeur Broyojo a constaté en lisant le journal du moteur de jeu Dæmon que dans ces circonstances, le jeu utilisait l’implémentation OpenGL d’Apple, chose qu’il s’est empressé de corriger fissa. Et pour le coup, ce changement est ce qui a corrigé le bug, trop facile.

L’article sur RADV et Windows indiquait :

Pour un distributeur de jeu vidéo comme Valve c’est excellent : ça signifie que — si nécessaire — le jeu peut être distribué avec RADV sur Windows et Linux pour les utilisateurs de cartes graphiques AMD, et MoltenVK ou KosmicKrisp sur macOS afin de fournir une expérience Vulkan finement contrôlée, et autres combinaisons sus-mentionnées. Cela permet de contrôler et donc d’assurer au maximum la compatibilité d’un jeu.

Nous y sommes. À part que cette fois-ci, ce n’est pas Valve qui en aurait eu l’initiative.

vkd3d-proton, DirectX 12 sur KosmicKrisp

Là où Zink implémente OpenGL sur Vulkan, vkd3d-proton fait de même et implémente DirectX 12 sur Vulkan, lui-même implémenté par KosmicKrisp.

DirectX 12 est l’interface de programmation graphique propriétaire de Microsoft pour Windows, elle est similaire à Metal et Vulkan.

Un développeur de jeu libre n’en a pas besoin : il peut utiliser OpenGL ou Vulkan, mais de très nombreux jeux utilisent Direct X 12, et Hadron s’assure donc de fournir cette prise en charge.

Comme son nom l’indique, vkd3d-proton est une brique essentielle de Proton, et l’est aussi maintenant pour Hadron.

mtld3d et DXMT, les plus anciens Direct3D sur Metal

Vous connaissez peut-être le logiciel DXVK qui implémentent Direct3D 8, 9, 10 et 11 au dessus de Vulkan. Vous aviez peut-être entendu parlé de D9VK qui faisait de même pour D3D9 mais qui est désormais intégré à DXVK, ou WineD3D qui implémentait Direct3D 8, 9, 10 et 11 au dessus de OpenGL.

Proton utilise DXVK sous Linux, implémentant donc D3D sur Vulkan, et Hadron pourrait faire de même, à la façon dont c’est effectivement implémenté avec vkd3d-proton.

Mais il existe deux logiciels qui implémentent D3D sur l’API Metal directement, ce qui permet de supprimer une couche intermédiaire de traduction.

Ces deux logiciels libres sont mtld3d qui implémente D3D9 sur Metal, et dxmt qui implémente D3D10 et D3D11 sur Metal.

Pour D3D8, Hadron ne précise pas si quelque chose est prévu, mais il devrait être possible d’utiliser DXVK, ou encore d3d8to9 qui implémente D3D8 sur D3D9. Et on peut supposer que rien ne devrait techniquement empêcher d’utiliser dd7to9 et autres projets de ce type (voir dxwrapper pour plus de détails).

Win32 + Vulkan + AMD64, la plate-forme universelle ?

Pour un développeur de logiciel libre, ces APIs DirectX sont peu utiles, mais tout le reste de cet écosystème peut profiter aux développeurs de logiciels libres.

Les compilateurs libres du projet MinGW permettent de compiler pour Win32. Wine permet de faire tourner ces programmes Win32 ailleurs que sur Windows. Et en s’appuyant sur les API graphiques OpenGL ou Vulkan, et des bibliothèques comme OpenAL ou SDL pour le son, le fenêtrage et les entrées, un développeur de jeu libre peut donc produire un seul binaire entièrement libre de la tête aux pieds qui tourne partout, sous Linux, BSD, macOS ou Windows.

Alors bien évidemment, certains préféreront un programme natif à leur système, avec de bonnes raisons. Mais quand un lanceur comme Steam ou une alternative libre comme Lutris fait toute l’intégration pour vous, tout ce qui retient se réduit à un attachement affectif (et ça compte beaucoup). C’est un chagrin légitime mais il n’empêche pas de jouer.

Wine fait déjà tourner naturellement les programmes x86 sur Linux et autres BSD. FEX peut être associé à Wine pour faire tourner des programmes Windows x86 sous Linux et macOS sur les processeurs ARM. Et Box64 sait faire de même sous Linux, non-seulement sur ARM64, mais aussi sur PowerPC (en mode petit-boutiste), RISC-V et Loongson.

Certains ont pu déclarer que « AMD64 is the new Java », en réalité, c’est peut-être la triforce Win32 + Vulkan + AMD64 qui est ce nouveau Java. Vous ferez peut-être autant la grimace, mais ça ne marche pas moins.

Et avec Hadron, votre prochain environnement de développement pour macOS pourrait simplement être MinGW, trop bien !

Avec Hadron, le futur de macOS court-circuite tout macOS, et Apple ne peut rien y faire.

Commentaires : voir le flux Atom ouvrir dans le navigateur
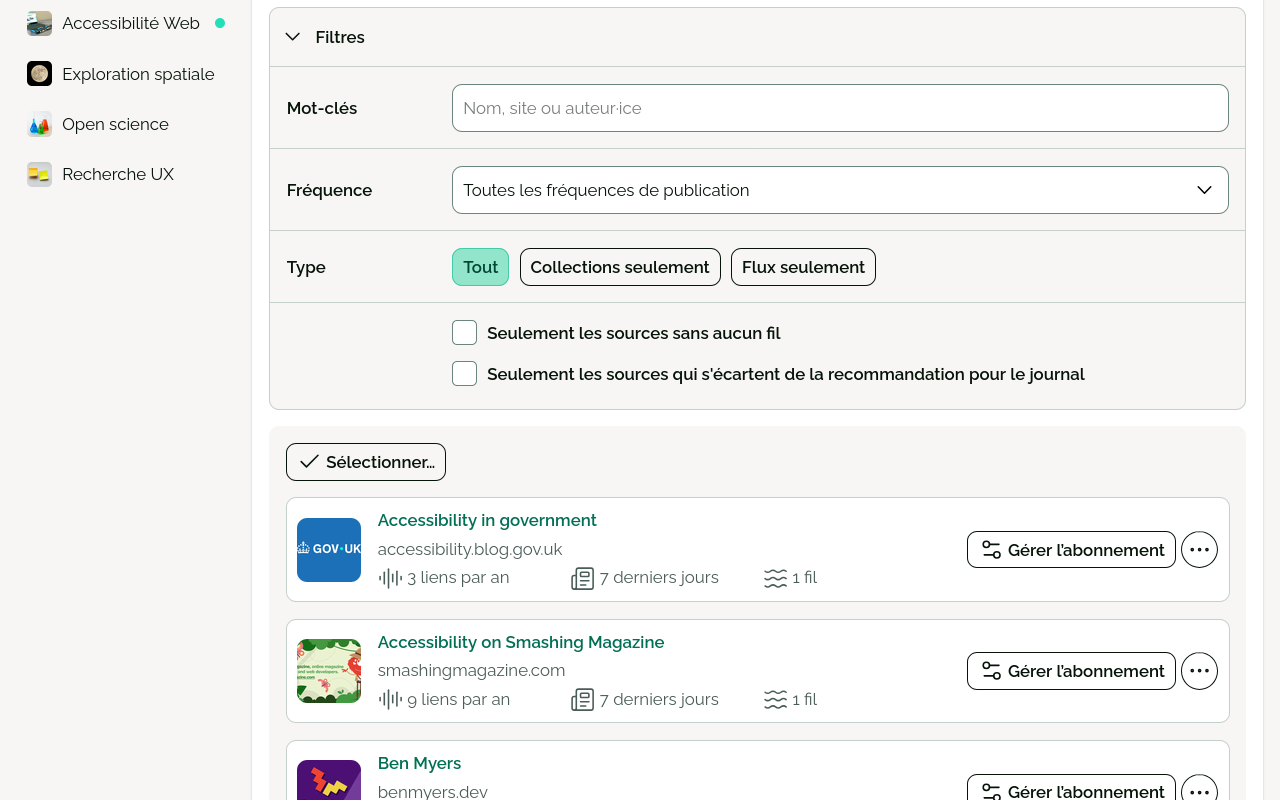
  •  

Et si vous louiez votre prochain appareil électronique ?

J’ai fait récemment deux découvertes étonnantes sur le réseau social du groupe bancaire dans lequel je travaille.

  1. Il existe un groupe de veille sur l’open source et les alternatives aux Gafam ;
  2. Ce groupe a récemment mis en ligne une conférence de découverte des distributions alternatives pour ordiphone, des ordiphones « différents », et enfin d’une autre manière de se procurer un ordiphone (entre autres).

Cette manière différente est de le louer à la SCIC Commown.

J’avoue que me serais plus attendu à faire cette découverte sur Linuxfr qu’au boulot… Quelques détails complémentaires dans la dépêche !

Comment ça marche ?

C’est très simple : le site de Commown propose divers matériels dégafamisés (ordiphones, pc portables ou fixes, casques audio) à louer selon différentes modalités.

Une fois le dépôt de garantie réglé, l’ordiphone vous est envoyé, à vous de régler les mensualités. Commown s’occupe de toute panne logiciel ou matérielle, en renvoyant un autre appareil au besoin.

Pourquoi ça donne envie ?

  • Parce que l’offre est bien travaillée, avec notamment une dégressivité marquée de 6 % des mensualités chaque année, avec un plancher à 60 % de la mensualité d’origine, et un matériel dégafamisé.

  • Parce que la démarche est vraiment très poussée et ne ressemble pas à un greenwashing quelconque. J’aime beaucoup par exemple l’incitation à ne pas forcément devenir client de suite tant qu’un changement d’appareil n'est pas nécessaire, mais
    à souscrire à un « bon de consom’action » donnant droit à une réduction dans le futur tout en asseyant la solidité financière de la coopérative.

Prêt à sauter le pas ?

Je réfléchirai sérieusement à souscrire à une de leur offre quand je serai venu à bout de mon Fairphone 3+ sous /e/OS, à moins que je ne souscrive un bon.

Et vous, que pensez-vous de ce type d’offre ?

Commentaires : voir le flux Atom ouvrir dans le navigateur
  •  

Le Capitole du Libre, la conférence sur le libre à Toulouse depuis 2011 - Podcast Projets Libres

Les 14 et 15 novembre prochain aura lieu le Capitole du Libre, la grande conférence autour du libre à Toulouse, qui existe depuis 2011.

Logo Capitole du Libre

Dans cet épisode, avec Lionel Porcheron et Guillaume Gasnier, nous retraçons l'histoire du Capitole du Libre, de ses débuts en tant qu'Ubuntu Party jusqu'à l'organisation telle que nous la connaissons de nos jours.

Logo Podcast Projets Libres

Nous parlons :

  • de l'association Toulibre
  • de sa pérennité et son financement
  • de ses inspirations
  • de ses transformations successives : d'un évènement local à une conférence nationale
  • des impacts d'évènements extérieurs tels que le COVID et des attentats de 2015
  • de ce que l'on peut attendre pour l'édition 2026 !

Venez nous rejoindre au Capitole du Libre dans quelques semaines, l'équipe de Projets Libres y sera !

Comme d'habitude, une transcription complète est disponible (merci Guillaume Gasnier pour son travail de relecture et amélioration).

Commentaires : voir le flux Atom ouvrir dans le navigateur
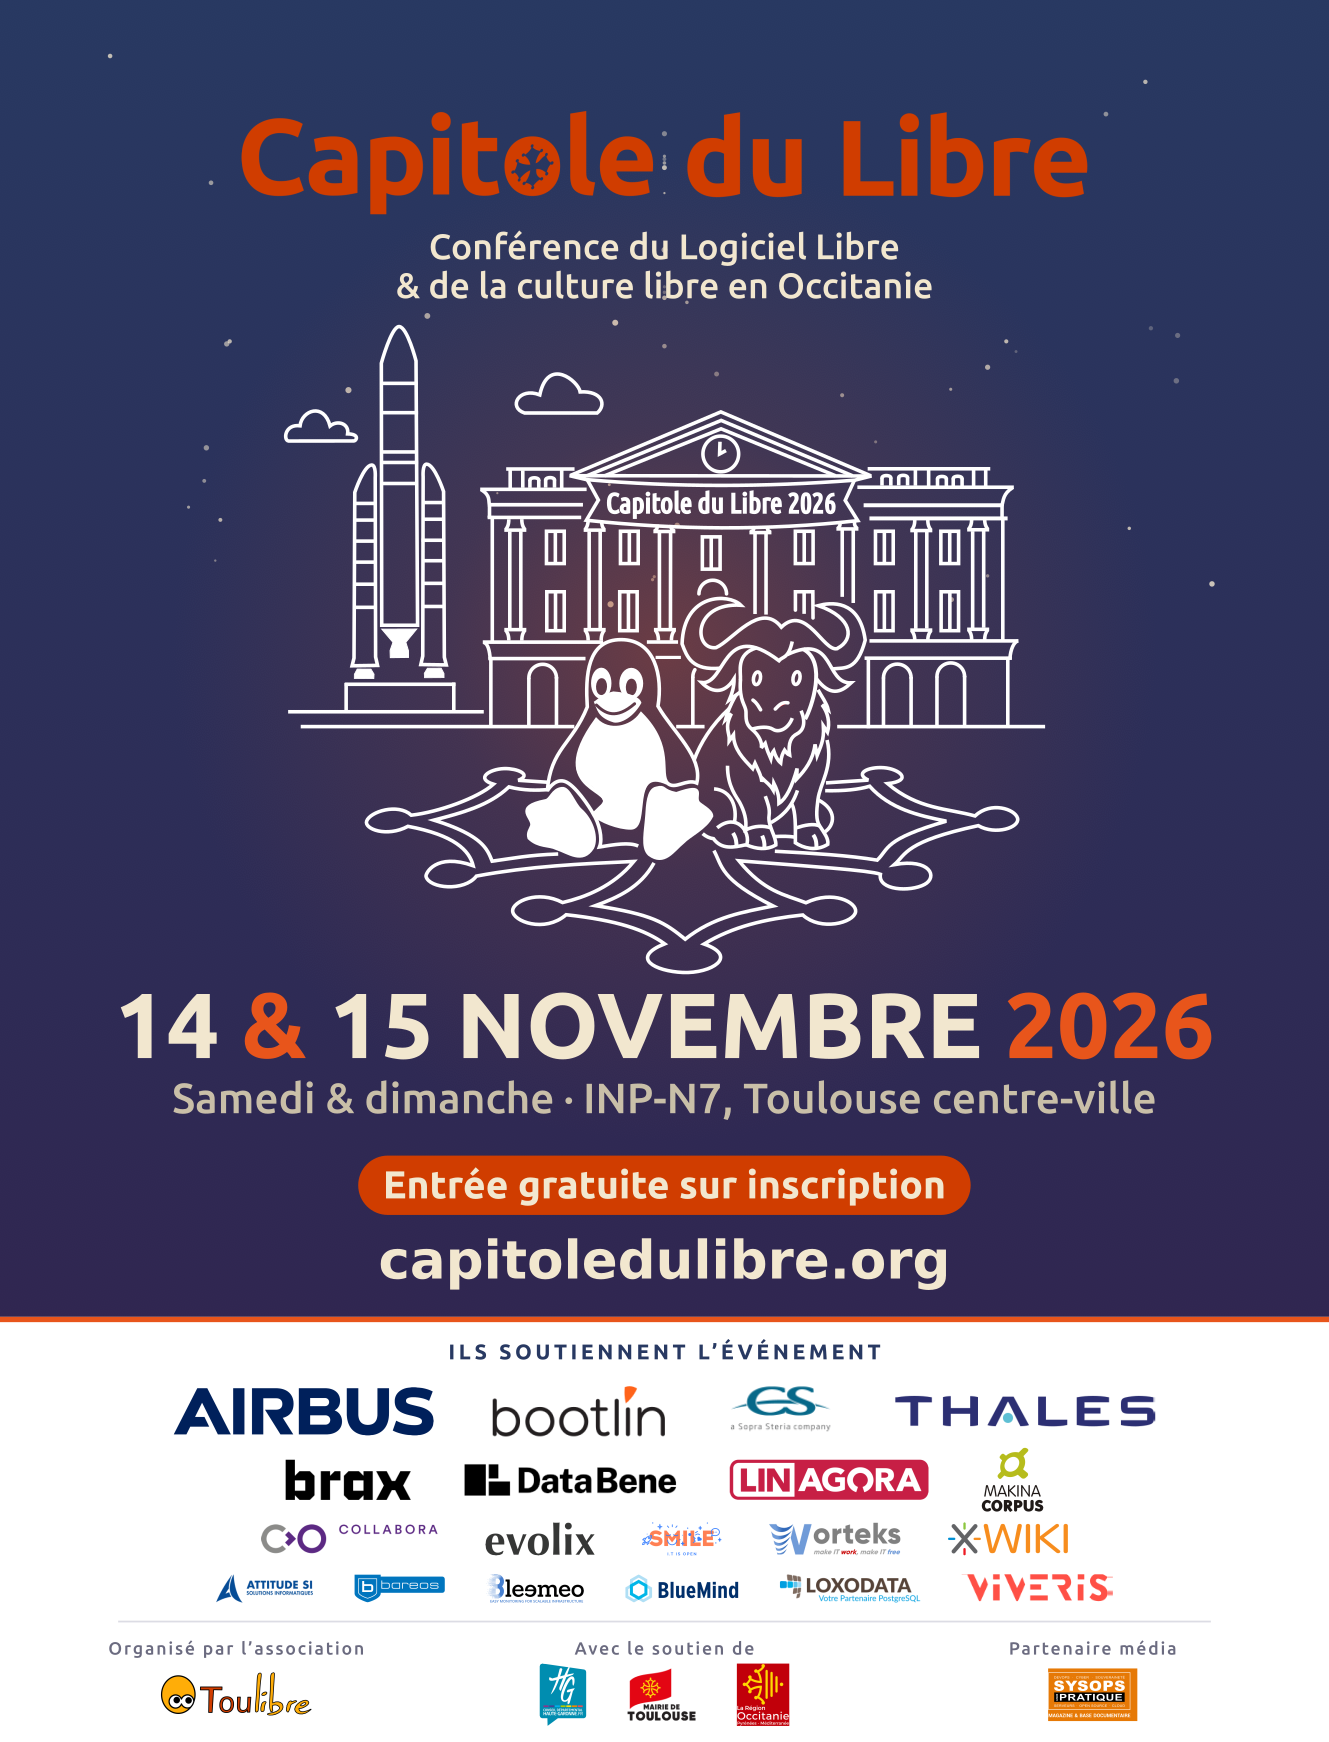
  •  

PandoraBox : la borne de décontamination USB

PandoraBox est une borne libre de décontamination de clés USB, une « station blanche » : on insère une clé, la borne analyse chaque fichier avec plusieurs moteurs de détection, affiche les fichiers dangereux sur son écran tactile, puis les supprime quand l'utilisateur touche l'écran. La nouvelle version est une réécriture complète. Elle ne dépend plus du projet Pandora du CIRCL et elle est distribuée sous forme d'image système durcie, construite à partir de Debian 13. Le code est sous licence GPL-3.0 et le boîtier imprimable en 3D sous licence CERN-OHL-S v2.

Pourquoi une borne de décontamination

Les clés USB restent une porte d'entrée courante dans des systèmes d'information par ailleurs bien protégés. Les personnes changent d'organisation, utilisent des ordinateurs qui ne sont pas surveillés et vont sur des réseaux isolés. La borne de décontamination vérifie les objets avant qu’ils arrivent au poste de travail.

PandoraBox propose une solution ouverte, que tout le monde peut vérifier, pour remplacer les bornes du commerce. PandoraBox s’adresse aux lieux qui demandent plus de sécurité, comme les hôpitaux, les usines ou les bureaux de l’État. Elle tourne sur un petit ordinateur reconditionné avec un écran tactile, et fonctionne sans réseau.

Plus de détail sur cette nouvelle version dans la seconde partie de la dépêche.

Sommaire

Une version entièrement réécrite.

La première version de PandoraBox s'appuyait sur Pandora du CIRCL pour analyser les fichiers. La nouvelle version repart d'une base propre et ne garde que ce qui fonctionnait : la machine à états, la détection USB avec pyudev, la quarantaine et l'interface curses du mode administrateur.

Les principaux changements :

  • les appels à pypandora sont remplacés par une chaîne de moteurs de détection intégrée ;
  • le moteur Comodo, qui n'est plus maintenu sous Linux, disparaît ;
  • le diaporama d'images (fim) laisse la place à une vraie interface graphique tactile ;
  • les clés sont montées en lecture seule par la borne elle-même, avec des options de montage durcies ;
  • les journaux passent au JSON structuré ;
  • la borne n'est plus un logiciel à installer sur un système existant, mais une image système complète.

Plusieurs moteurs de détection

Chaque fichier passe par plusieurs moteurs complémentaires :

  • MalwareBazaar propose des empreintes SHA-256 de logiciels malveillants connus.
  • Le service CIRCL Hashlookup aide à repérer les fichiers connus grâce à un filtre de Bloom.
  • ClamAV : antivirus, y compris dans les archives
  • YARA-X : YARA Forge
  • Heuristiques : programmes déguisés en documents (double extension, type réel différent de l'extension), PDF avec JavaScript ou actions de lancement

La borne a un mode « fail closed » : si la borne ne peut pas analyser tout le fichier, comme pour une archive protégée par mot de passe, un fichier trop gros ou une erreur dans un moteur, la borne ne dit jamais que le fichier est sûr. Chaque partition de la clé est analysée, et une partition illisible (chiffrée, système de fichiers inconnu) rend la clé « non vérifiée ».

Rien n'est supprimé sans l'utilisateur : les fichiers dangereux sont listés à l'écran, copiés dans la quarantaine de la borne, puis retirés de la clé seulement après un appui sur l'écran. Chaque analyse donne un rapport JSON.

Une image système durcie

La clé USB pose un risque car la clé USB est vue comme un objet dangereux. Les moteurs d'analyse risquent d'être piratés. L'image est construite avec mkosi à partir des paquets Debian 13, et ne contient que ce qui sert à analyser :

  • chaîne de démarrage vérifiée : Secure Boot avec la clé de l'image enrôlée à la place de celles de Microsoft, image noyau unifiée (UKI) signée, système de fichiers racine EROFS en lecture seule protégé par dm-verity, noyau en mode lockdown ;
  • périphériques USB filtrés : USBGuard n'autorise que le stockage de masse, ce qui bloque les clés qui se font passer pour un clavier (BadUSB), et les pilotes réseau USB, Wi-Fi et Bluetooth sont retirés de l'image ;
  • aucune session : pas de compte, pas de programme login, pas de menu de démarrage ;
  • un bac à sable par moteur : chaque moteur tourne dans son propre processus, avec bubblewrap, un utilisateur dédié sans privilèges, un filtre seccomp et aucun accès réseau. Un moteur compromis par un fichier piégé ne peut pas falsifier le résultat d'un autre ;
  • pare-feu et réglages du noyau inspirés des recommandations de l'ANSSI pour les systèmes GNU/Linux. Lynis donne un indice de durcissement de 73, sans avertissement.

L'interface graphique est dessinée avec Pillow directement dans le framebuffer, sans serveur d'affichage ni navigateur.

Mises à jour signées et maintenance sans session

La borne fonctionne hors ligne par défaut. Tout ce qui la modifie arrive signé :

  • Les signatures : le logiciel vérifie un jeu de signatures signé Ed25519 à chaque démarrage. Il s'installe depuis une clé USB de mise à jour, qui n'est jamais analysée, ou en ligne avec le profil online de l'image. Sans jeu valide, la borne n'analyse rien. Un jeu plus ancien est refusé ;
  • Le système accepte les mises à jour A/B avec systemd-sysupdate, par clé USB ou en ligne. La nouvelle version est écrite dans l'emplacement libre, et après 3 démarrages ratés, systemd-boot revient à la version précédente ;
  • journaux : une clé de maintenance signée récupère les journaux de la borne (journal systemd, noyau, USBGuard, matériel) sans ouvrir de session et sans rien modifier.

Une borne en ligne peut aussi envoyer ses journaux à un SIEM (Wazuh, Elastic, Graylog, Splunk) en syslog RFC 5424 ou en JSON, sur TLS. En ligne, seuls le service de mise à jour, l'export SIEM et NTP peuvent sortir à travers le pare-feu. La borne elle-même n'a toujours pas accès au réseau.

Matériel et interface

La borne de référence est un Lenovo ThinkCentre M720q Tiny reconditionné (Core i5-9400T, 6 cœurs), avec un écran tactile Waveshare de 7 pouces (1024x600). L'image fonctionne sur tout ordinateur x86_64 UEFI, avec 2 Go de mémoire au minimum. Le boîtier de bureau s'imprime en 3D en une seule pièce.

L'interface est pensée pour le tactile, sans bouton : attente d'une clé, progression de l'analyse, liste des fichiers dangereux, appui n'importe où sur l'écran pour nettoyer, puis résultat. Chaque organisation peut y mettre son logo, ses couleurs, ses textes et sa langue (français et anglais fournis).

L'image est testée de bout en bout dans une machine virtuelle QEMU/KVM. Le test démarre l'image avec Secure Boot, insère des clés USB émulées (vfat, exFAT, NTFS, ext4), vérifie le verdict de chaque moteur, le nettoyage, les mises à jour et le retour à la version précédente.

État du projet

Le projet est en développement actif. L'analyse marche bien. L'image durcie fonctionne comme attendu. L'interface tactile répond comme il faut. Les mises à jour passent sans souci. L'export SIEM est validé. Le matériel de référence a permis de tout vérifier.

Une limite importante reste à lever : l'image et les jeux de signatures ne sont signés pour l'instant qu'avec des clés de développement, générées sur la machine qui construit l'image. Les clés de publication du projet et leur stockage ne sont pas encore définis.

Les prochaines étapes de la feuille de route :

  • analyse des macros Office avec oletools et des exécutables avec capa ;
  • désarmement et reconstruction de contenu (CDR) avec Dangerzone ;
  • serveur central facultatif : inventaire des bornes, rapports, état des signatures ;
  • modèle de menace documenté, fuzzing des points d'entrée et audit de sécurité externe ;
  • correspondance avec les exigences NIS2 et ISO 27001 (mesure 7.10 « Supports de stockage »).

Essayer et contribuer

Il suffit de Docker pour construire l'image et la tester dans une machine virtuelle :

git clone https://github.com/sourcentis/pandora-box.git
cd pandora-box
image/build.sh                            # construit l'image
image/build-test.sh && image/vm.sh test   # la teste dans une machine virtuelle

Les contributions sont les bienvenues : retours d'expérience sur d'autres matériels, règles de détection, traductions de l'interface, revue de sécurité. Les vulnérabilités se signalent selon la politique de sécurité.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  •  

Tempo, saison 2026‑2027 : couleurs et prévisions en accès libre, sans jeton

(NdM : Tempo est une offre commerciale d'EDF, cette dépêche traite des API et flux de données ouverts permettant de connaître et prédire les coûts du kWh.)

En avril 2025, une dépêche faisait le point sur les sources accessibles sans jeton pour connaître la couleur Tempo du jour, après la fermeture des anciennes URL d'EDF. La saison des jours rouges reprend le 1er novembre : voici une mise à jour, avec une nouveauté, des prévisions au delà de demain en JSON et en données ouvertes. Transparence d'abord : je fais partie de l'équipe de Calendrier Tempo EDF, l'une des sources présentées plus bas.

    Rappel du contexte

    L'option Tempo d'EDF compte 300 jours bleus, 43 blancs et 22 rouges par saison. Les jours rouges tombent entre le 1er novembre et le 31 mars, jamais un samedi ni un dimanche, et le kWh y coûte nettement plus cher. La couleur du lendemain est fixée par RTE et annoncée la veille. Pour piloter un chauffage ou une machine à laver depuis une box domotique, il faut donc une source lisible par une machine.

    La couleur officielle (aujourd'hui et demain)

    • RTE : la source officielle. Son API passe par un compte et un jeton sur le portail data de RTE. Les couleurs passées sont aussi publiées en données ouvertes : Tempo Like Supply Contract sur data.gouv.fr.
    • api-couleur-tempo.fr : déjà citée en 2025, toujours là. JSON simple, sans clé, très utilisé dans les forums domotiques.
    • Calendrier Tempo EDF : relaie la couleur officielle (via api-couleur-tempo.fr) sur /api/today et /api/tomorrow, qui renvoie "status": "unavailable" tant que la couleur de demain n'est pas publiée. Si vous lisez déjà RTE directement, gardez cette source : c'est l'originale.

    Exemple :

    curl https://www.calendrier-tempo.fr/api/today
    {"status": "ok", "date": "2026-10-09", "couleur": "BLEU", "code": 1}
    

    Les prévisions (après demain)

    C'est ce qui a changé depuis 2025 : on trouve maintenant des prévisions en JSON, sans compte.

    • Open DPE publie un fichier de prévisions jour par jour, avec une probabilité : https://open-dpe.fr/assets/tempo_days_lite.json
    • Calendrier Tempo EDF publie /api/predictions : une prévision par jour jusqu'à J+15, avec la probabilité de chaque couleur et la température moyenne prévue, recalculée chaque soir à partir des prévisions de consommation de RTE, de la météo (Open‑Meteo) et des règles officielles de Tempo. /api/remaining donne les jours restants par couleur dans la saison.

    Une prévision reste une prévision, et seule la couleur publiée fait foi. Plus l'échéance est lointaine, plus c'est une tendance qu'une certitude.

    Vérifier avant de faire confiance

    Plusieurs fils de forums domotiques l'ont montré l'hiver dernier : des prévisions affichées sans historique, on ne sait jamais ce qu'elles valent. Chez Calendrier Tempo EDF, chaque prévision est figée au moment où elle est émise, de J‑15 à la veille, puis comparée à la couleur réelle. L'historique complet, erreurs comprises, est consultable en ligne et téléchargeable en CSV sous licence CC BY 4.0 :

    De quoi mesurer soi‑même la fiabilité par échéance, et comparer les sources cet hiver.

    Côté domotique

    L'API ne demande ni compte ni clé, et les réponses sont en cache deux minutes : une requête toutes les trente minutes suffit largement. Des configurations prêtes à copier pour Home Assistant (intégration installable via HACS, sous licence MIT), Jeedom et Domoticz sont réunies sur une page : intégrations domotique. Documentation de l'API : https://www.calendrier-tempo.fr/api-tempo

    Pour finir

    Comme en 2025 : si vous connaissez d'autres sources sans jeton, ou si vous suivez la fiabilité des prévisions de votre côté, les commentaires sont là pour ça.

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    •  
    ❌