❌

Vue lecture

L’UE somme TikTok d’arrêter d’enfermer ses utilisateurs dans une spirale de surutilisation

🐍 Aie confiance 🐍
L’UE somme TikTok d’arrêter d’enfermer ses utilisateurs dans une spirale de surutilisation

La Commission européenne estime à titre préliminaire que TikTok a enfreint le réglement sur les services numériques (DSA) en raison de l’effet de spirale de surutilisation de son système de recommandation sur l’onglet « Pour toi » de son application. Le réseau social a mis en place des modifications mais Bruxelles considère qu’elles sont inefficaces.

TikTok est de nouveau dans le viseur de la Commission européenne concernant de potentielles infractions au DSA. En effet, Bruxelles explique avoir bouclé une enquête préliminaire concernant le réseau social et la spirale de surutilisation (« rabbit holes » en anglais) mise en place par son système de recommandation et ouvrir une enquête formelle.

Des spirales de surutilisation poussées par l’algorithme de TikTok

Dans un communiqué, l’institution affirme que son enquête montre que « TikTok n’a pas suffisamment évalué la manière dont son algorithme de recommandation pouvait entraîner les utilisateurs dans de telles spirales, mettant ainsi leur bien-être en danger ». Elle ajoute que ses conclusions préliminaires font apparaitre « que la conception de l’algorithme pourrait jouer un rôle important dans l’apparition de ces spirales ». « L’algorithme utilise des informations relatives à l’engagement des utilisateurs, telles que le visionnage et les likes attribués aux vidéos, afin de personnaliser le contenu qui leur est recommandé », ajoute la Commission.

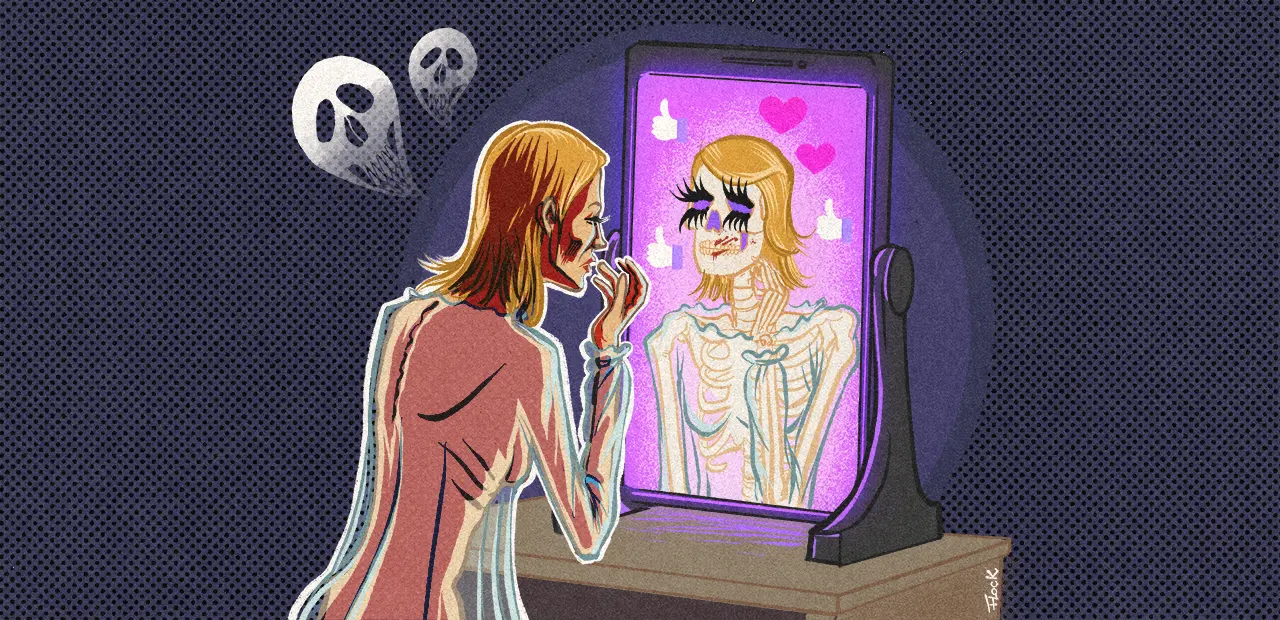
Elle donne notamment l’exemple d’un utilisateur qui regarderait ou « likerait » des contenus susceptibles « d’être source de détresse, comme ceux portant sur la perte de poids ou l’image corporelle », et affirme que dans ces conditions, le système « interprète ces interactions comme des signes positifs d’intérêt et lui recommande davantage de contenus du même type ».

« Une exposition répétée à ce type de contenu peut avoir de graves répercussions négatives sur le bien-être des utilisateurs, notamment un sentiment accru de tristesse ou d’anxiété, une insatisfaction vis-à-vis de son corps, une baisse de l’estime de soi ou une aggravation des troubles alimentaires et des troubles psychiques existants », commente-t-elle.

Les mesures mises en place par TikTok ne sont pas efficaces

L’information n’est pas nouvelle puisque nous vous parlions en septembre 2024 d’une étude scientifique montrant que les femmes exposées aux vidéos de TikTok perdent de l’estime pour leur propre corps. Les autrices de l’étude expliquaient que les vidéos du mouvement pro-anorexie profitent particulièrement de l’algorithme de recommandation « Pour vous » de l’application.

D’ailleurs, en février 2024, la Commission européenne avait déjà ouvert une procédure à ce sujet contre les « rabbit holes » de TikTok, soupçonnant déjà le réseau social d’être en infraction avec le DSA. La Commission explique que TikTok a mis certaines mesures en place censées atténuer l’effet, mais selon elle, ces mesures ne sont pas efficaces.

Son enquête constate que les dispositifs pour recommander des contenus diversifiés « ne réduisent pas suffisamment la fréquence à laquelle des contenus similaires sont recommandés, notamment ceux liés aux difficultés de santé mentale et à l’image corporelle ».

Elle ajoute que les outils donnés par TikTok à ses utilisateurs pour contrôler les contenus recommandés sont aussi inefficaces. Ainsi, elle donne l’exemple de l’utilisation du bouton « pas intéressé » qui n’a parfois aucun effet sur le flux de contenus de l’onglet « Pour toi ». « L’algorithme privilégie l’affichage de contenus en fonction du temps passé à les regarder, plutôt que du choix des utilisateurs de voir moins de certains contenus », explique la Commission.

L’institution européenne demande à TikTok de prendre réellement en compte les préférences explicites de ces utilisateurs.

TikTok a désormais la possibilité de défendre les changements qu’elle a mis en place en répondant à la Commission. L’entreprise n’a pas encore réagi publiquement. L’institution européenne ajoute qu’elle va, en parallèle, consulter le Comité européen des services numériques. Elle précise que si son enquête préliminaire est confirmée, elle pourra imposer à Bytedance (la maison mère chinoise de TikTok) une amende pouvant aller jusqu’à 6 % de son chiffre d’affaires annuel total mondial.

En France, l’année dernière, l’application avait fait l’objet quasiment à elle toute seule d’une enquête parlementaire qui avait fait des constats accablants sur les conséquences violentes de l’utilisation de TikTok sur les mineurs.

Mais les parlementaires ont surtout choisi d’interdire les réseaux sociaux aux plus jeunes. La Commission européenne a d’ailleurs récemment affiché sa volonté d’imposer un calendrier commun aux États sur ces questions avec le KIDS Act qu’elle veut mettre en place.

  •  

Les aéroports US vont remplacer des systèmes de contrôle qui tournaient sur des disquettes

Y-a-t-il un pilote dans l'avion ?
Les aéroports US vont remplacer des systèmes de contrôle qui tournaient sur des disquettes

Alors que l’administration Trump a longuement communiqué sur l’introduction de l’IA pour mieux gérer le contrôle aérien sur son territoire, elle s’enorgueillit maintenant de la mise en place d’un système qui doit enfin remplacer des logiciels qui tournaient encore sur des disquettes.

D’ici 2028, les aéroports états-uniens devraient avoir abandonné des systèmes qui tournaient encore sur des disquettes. C’est en tout cas la promesse de la Federal Aviation Administration (FAA), l’agence chargée des contrôles et des réglementations pour l’aviation civile aux États-Unis.

De grosses difficultés dans la gestion du trafic aérien des États-Unis

L’administration de Donald Trump fait face, depuis son arrivée au pouvoir, à des difficultés concernant le contrôle aérien alors qu’elle avait remis en question la FAA dès les premières semaines de son mandat. Dès février 2025, l’agence avait déjà licencié 400 personnes en période d’essai et avait prévu de s’appuyer sur une équipe de SpaceX pour revoir son système de contrôle du trafic aérien.

Depuis, la situation dans les aéroports des États-Unis s’est dégradée. Ainsi, par exemple, en mai 2025, des contrôleurs aériens avaient brièvement perdu le contact avec des avions. En avril dernier, la FAA a décidé de mettre en place une campagne de recrutement auprès des joueurs pour garnir les postes vacants de contrôleurs aériens, mais l’agence prévenait elle-même que le contrôle du ciel devrait attendre « d’ici deux ans et demi à trois ans » pour en voir les effets attendus.

En parallèle, elle a annoncé en avril dernier travailler sur un nouvel outil de gestion du trafic aérien basé sur une intelligence artificielle et nommé SMART (pour Strategic Management of Airspace Routing Trajectories). Selon le média spécialisé The Air Current, Palantir, Thales et Airspace Intelligence (ASI) ont été mis en concurrence pour mettre en place le projet. La promesse est que ce système permette à la FAA de prévoir les goulots d’étranglement et d’anticiper les conflits d’horaires avant qu’un avion ne décolle.

IA : plus de peur que de mal ?

Mais, selon Politico, la description vague qu’en faisait la FAA avait mis en ébullition l’industrie aérienne états-unienne, qui s’inquiétait du degré d’intégration de l’IA dans la gestion quotidienne du trafic aérien. Selon les sources de nos confrères, SMART ne devrait finalement pas créer de nouvelles procédures pour les contrôleurs aériens et les compagnies. Ce nouveau système proposera uniquement des itinéraires alternatifs via les systèmes et procédures déjà existants.

Le secrétaire aux Transports, Sean Duffy, avait aussi annoncé la mise en place d’un outil nommé « Foundry » s’appuyant sur l’IA pour identifier les risques récurrents au-dessus du sol américain. Il n’est par contre pas prévu d’utiliser ce logiciel pour prédire des événements.

Un remplacement de plusieurs outils obsolètes

Sean Duffy a néanmoins la volonté de montrer que son administration modernise les systèmes informatiques utilisés pour le contrôle aérien des États-Unis. Pour cela, au lieu de l’intégration à marche forcée de l’IA, il met en avant le remplacement de systèmes utilisant encore des disquettes.

De fait, la FAA a prévu de remplacer plusieurs outils utilisés depuis des décennies – devenus obsolètes et dont la maintenance devenait prohibitive – par un seul système nommé Enterprise-Information Display System (E-IDS). Certains de ces outils utilisaient encore des disquettes, a mis en avant Sean Duffy dans un tweet.

E-IDS doit permettre aux contrôleurs aériens d’accéder plus simplement aux informations dont ils ont besoin, dont celles relatives à la météo. Pour l’instant, la FAA annonce qu’il va être mis en place dans 5 aéroports américains, mais elle promet qu’E-IDS remplacera les logiciels qui tournent sur disquettes avant la fin 2028. E-IDS n’est par contre pas un logiciel initié par l’administration Trump actuelle. En effet, le média spécialisé Air Traffic Technology International en parlait déjà début 2022 sous l’administration Biden. À l’époque, la FAA prévoyait de le déployer dans un premier aéroport en 2025.

  •  

Le CNRS continue son ménage anti-GAFAM, sa messagerie migre vers Partage de Renater

Ils vont l'utiliser maintenant ?
Le CNRS continue son ménage anti-GAFAM, sa messagerie migre vers Partage de Renater

Le CNRS vient de souscrire à la plateforme de messagerie Partage de Renater. L’organisme de recherche affiche ainsi une volonté de « gagner en souveraineté numérique ». Les 50 000 boites emails de l’organisme doivent maintenant être gérées par le même service qu’une bonne partie des établissements de l’enseignement supérieur français.

Après avoir officiellement annoncé en début d’année l’abandon des licences Zoom au profit de l’utilisation de l’outil Visio de la Suite Numérique de la Dinum, le CNRS veut s’afficher « souverain » concernant la gestion des boites emails de ses agents.

La direction du CNRS, qui a changé de PDG en juin, veut continuer la « démarche de sortie des GAFAM » déjà amorcée et « plus particulièrement sa sortie de Microsoft » affirme-t-elle dans un communiqué [PDF].

Départ d’une solution Exchange hébergée chez un prestataire

Les emails du CNRS étaient jusque-là gérés via le logiciel Exchange de Microsoft et hébergés chez un prestataire externe (sur lequel l’organisme ne donne aucune information).

C’est maintenant avec la solution du logiciel libre Zimbra qu’ils seront traités. De fait, le CNRS se plie aux choix techniques du GIP Renater car il utilisera sa solution nommée « Partage » qui s’affiche comme un « service de messagerie collaborative » s’appuyant, entre autres, sur Zimbra.

En février, le directeur de Renater, Boris Dintrans, mettait en avant, dans une interview pour Next cette solution. Parmi les acteurs du numérique de l’enseignement supérieur et la recherche français, « on est les seuls à proposer 850 000 boîtes mails via notre solution Partage », nous expliquait-il. « Elle est utilisée par 83 établissements. Nous avons aussi un antispam qui protège Partage, mais aussi les établissements qui ne sont pas sur Partage avec 3,5 millions de boîtes mails protégées. Sur le volet messagerie, ce qu’on fait est unique ».

Dans le communiqué annonçant cette migration, Boris Dintrans se réjouit : « Accueillir le CNRS sur PARTAGE, c’est permettre de sécuriser les données scientifiques en s’appuyant sur un logiciel libre et sur l’ensemble de nos infrastructures en propre (datacentres et réseaux de communication) ». Il ajoute que la roadmap de Partage « vise 1,5 million d’utilisateurs d’ici 2027, un déploiement rendu possible notamment par la mise en production d’un nouveau stockage objet permettant [à Renater] de monter en puissance sans compromettre la souveraineté des données ».

Économie annoncée de 3,5 millions d’euros par an

Côté CNRS, on met aussi en avant « l’optimisation des coûts informatiques ». Sans dévoiler ni l’offre choisie chez Renater ni le prix global que paye l’organisme de recherche au GIP, le CNRS affirme que « cette migration permet également de réaliser des gains financiers, de l’ordre de 3,5 millions d’euros par an ». Cela lui permet aussi de mettre l’étiquette à la mode de la « souveraineté » en arguant que l’hébergement de Renater est « 100% français ».

L’organisme explique qu’il y avait 50 000 boites mails à migrer, en comptant celles des 35 000 agents du CNRS mais aussi les boîtes partagées et de service. Reste à savoir si les agents du CNRS vont en profiter pour s’approprier cette messagerie. En effet, les chercheurs du CNRS qui sont intégrés aux UMR ont souvent pris l’habitude d’utiliser les boites mails fournies par les autres tutelles et n’utilisaient l’email @cnrs.fr que pour communiquer avec leur administration interne.

Certains nous font déjà remonter que, même si le changement vers une solution plus souveraine leur semble aller dans le bon sens, l’application web se bloque quand la page est restée ouverte trop longtemps, qu’il est impossible d’envoyer des pièces jointes avec les calendriers partagés ou encore que la synchronisation avec Thunderbird est trop complexe.

  •  

Le NYTimes attaque Brave pour ses accords avec les entreprises d’IA et son option anti-paywall

Tout faire pour accéder aux contenus journalistiques sans les payer ?
Le NYTimes attaque Brave pour ses accords avec les entreprises d’IA et  son option anti-paywall

Le journal américain vient de déposer plainte contre Brave, l’accusant de passer outre son paywall pour vendre l’accès à ses contenus aux entreprises d’IA générative comme Anthropic, Perplexity, Mistral, xAI et Cohere. Accompagné d’autres médias, le New York Times cible aussi l’option « paywall blocker » et d’autres fonctionnalités du navigateur.

Le New York Times, suivi par d’autres titres de presse états-uniens, a déposé plainte devant la cour fédérale de Manhattan lundi 2 novembre contre l’éditeur du navigateur Brave.

Dans les deux documents très proches déposés devant la justice (un premier PDF ici et un autre là), ces médias pointent le « rôle central » de l’entreprise de Brendan Eich concernant la copie et la distribution de leurs articles copyrightés aux utilisateurs de son navigateur mais aussi aux entreprises d’IA génératives les plus en vue du marché.

Brave vendrait un accès aux articles sous paywall via une API

« Brave est le fournisseur, le revendeur et le distributeur de contenus copyrightés et obtenus illicitement, destinés à ses propres utilisateurs ainsi qu’à bon nombre des plus grandes entreprises spécialisées dans l’IA générative, notamment Anthropic, Perplexity, Mistral, xAI et Cohere », écrivent-ils.

Les entreprises de presse estiment, dans leur plainte, que Brave a engrangé plus de 100 millions de dollars en copiant et revendant leurs articles. Pour elles, Brave a pivoté et changé de modèle en monétisant son index de pages web scrapées.

D’une part, en déployant sa fonctionnalité IA « Ask Brave », un bot IA comme tant d’autres, mais qui, selon les plaignants, permet « souvent » d’accéder à des verbatim de leurs textes ou à des résumés détaillés.

D’autre part, Brave propose une API via laquelle elle donne accès , toujours selon la plainte, à « une source illicite de contenus copyrightés dont elle ne possède pas les droits, y compris des contenus copyrightés appartenant aux éditeurs, à d’autres sociétés du secteur de l’IA ».

Les éditeurs de presse ciblent aussi les différentes options mises en place dans le navigateur de Brave pour permettre de lire les contenus de médias en passant outre leur paywall. Ainsi, ils citent l’option « Paywall blocker », qui activée, permet aux internautes de passer outre leurs paywalls, mais aussi le portail Brave News et les fonctionnalités de blocage de publicités incluses dans le navigateur.

Ils demandent que Brave soit empêché de continuer à proposer ce genre de fonctionnalité et de vendre l’accès de cette API aux entreprises d’IA générative mais aussi « la restitution intégrale de l’ensemble des recettes et bénéfices obtenus par Brave grâce à son système de substitution publicitaire, majorés des intérêts ».

Perplexity s’énerve

Interrogées par The Verge, Brave ainsi que la plupart des entreprises d’IA générative citées n’ont pas donné suite. Seule Perplexity a vivement réagi en affirmant que « le New York Times paie ses avocats trop cher et sous-paie ses journalistes. (Qui auraient pourtant facilement pu repérer les fausses informations contenues dans cette plainte) ».

ArsTechnica, qui a reçu la même réponse, affirme que la déclaration de Perplexity ne contient aucune information sur ces prétendues fausses allégations. Nos confrères rappellent cependant que l’entreprise est déjà attaquée par le New York Times dans une affaire engagée depuis décembre 2025 concernant la reproduction illégale d’articles copyrightés.

  •  

☕️ L’Établissement français du sang touché par le piratage de certaines chambres froides


Après les frigos de plusieurs enseignes de supermarché en France puis en Europe, c’est maintenant les chambres froides de l’Établissement français du sang (EFS) qui ont été visées par un piratage.

Selon le Canard enchaîné, le prestataire de l’établissement public, Coolworld, a été ciblé par une cyberattaque dans la nuit de dimanche 1er novembre au lundi 2.

Coolworld est censé assurer la maintenance des chambres froides de l’établissement qui gère les centres de collecte de sang, plasma et plaquettes en France.

Mais, selon nos consœurs du palmipède, certaines chambres froides ont été programmées pour passer des - 30 °C prévus pour conserver des échantillons de donneurs à 110 °C.

Illustration : Flock

Interrogé par le Canard enchaîné, le ministère de la Santé rassure sur les conséquences du piratage : « Il y a zéro conséquence opératoire, car la situation a été repérée ».

Du côté de l’ESF, on explique qu’ « un technicien de permanence a constaté dans la nuit de dimanche à lundi une remontée en température dans les chambres froides », des échantillons d’un dispositif de veille sanitaire concernant la transfusion sanguine seraient concernés mais aussi du plasma congelé destiné à la transfusion.

Dans un communiqué, l’EFS précise que les installations de supervision et de pilotage de chambres froides déployées sur trois sites de l’EFS ont été touchées. Les systèmes de surveillance et d’alarme de l’EFS ont cela dit « permis d’identifier rapidement ces anomalies et de prendre les mesures nécessaires afin qu’aucun échantillon ou produit sanguin ne soit altéré » :

« Aucun impact sanitaire n’a été identifié et aucune perte de produits sanguins n’est à déclarer. Les produits conservés dans les équipements concernés, des poches de plasma destinées à la transfusion et des poches de plasma destinées au fractionnement pour la fabrication de médicaments, ont été transférés ou sécurisés. »

  •  

Chatbots IA : le droit européen interdirait la reprise d’articles de presse sous paywall

OpenAI mais pas open bar
Chatbots IA : le droit européen interdirait la reprise d’articles de presse sous paywall

Selon l’avocat général de la CJUE, le scraping et la réutilisation de publications de presse en ligne par les chatbots IA pour générer des réponses doivent respecter certains critères, et notamment qu’elles aient été obtenues légalement (donc sans passer outre un paywall), mais aussi que le chatbot ne réutilise pas le style utilisé dans l’article.

La presse européenne est suspendue au sort qui sera réservé à l’affaire qui oppose l’éditeur hongrois Like Compagny à Google. C’est, selon le communiqué de presse [PDF] de la Cour de justice de l’Union européenne (CJUE), la première affaire relative à l’IA générative portée devant elle.

Et l’avocat général à la Cour, Maciej Szpunar, vient de rendre ses conclusions. Rappelons qu’il doit donner un éclairage à la Cour mais que celle-ci n’est pas liée à ses conclusions. Les juges commencent tout juste à délibérer dans cette affaire et leur arrêt sera rendu ultérieurement. Mais le regard de l’avocat général permet de mieux cerner les enjeux de cette décision.

En l’occurrence, devant la Cour régionale de Budapest, Like Compagny accuse Google (en fait, sa maison mère, Alphabet) d’avoir violé les droits qu’elle possède sur les articles publiés sur le site Balaton Környéke en les utilisant entre juin 2023 et juin 2024, sans son accord, pour entrainer ses modèles, mais aussi dans son processus de RAG (pour retrieval-augmented generation) afin de générer des réponses aux utilisateurs de son chatbot Gemini en allant les chercher sur le web. Elle l’accuse aussi d’avoir « reproduit » ces articles et de les avoir « rendus accessibles » aux utilisateurs du chatbot.

Avant de statuer, cette cour hongroise a voulu consulter la Cour de justice de l’Union européenne pour vérifier comment le droit européen encadre ce genre de problèmes. Elle lui a demandé si le processus d’entrainement d’un modèle de langage peut être considéré comme un acte de reproduction illicite ou si il relève de l’exception au « text and data mining » que la loi européenne permet. La Cour hongroise a aussi interrogé la CJUE sur la reproduction des articles de presse par les chatbots.

Pas de preuve d’utilisation pour l’entrainement, pas de question

L’avocat général Maciej Szpunar demande à la CJUE d’évacuer les questions sur l’entrainement du modèle de langage avec les textes de Like Compagny car il considère qu’elles ne sont pas recevables. Pour lui, l’entreprise hongroise ne donne pas de preuve que Google a utilisé ses textes pour entrainer ses modèles.

Il demande à la Cour de se concentrer sur les questions relatives à la reproduction des articles par les chatbots via les processus de Retrieval-Augmented Generation (RAG).

Concernant la réutilisation d’articles en ligne par un chatbot pour générer une réponse, Maciej Szpunar estime que l’éditeur n’a pas un monopole sur l’information qu’il a publiée. Ainsi, selon lui, le droit européen permet à un chatbot de réutiliser une information publiée par un média sans avoir à lui demander son consentement.

Un chatbot ne peut pas réutiliser un contenu sous paywall ou utiliser le style d’un article

Par contre, le chatbot qui réutilise une information doit le faire sans y accéder de manière illicite, « notamment en contournant les mesures techniques efficaces destinées à restreindre l’accès à cette publication ou son extraction ».

Il ne doit pas non plus reproduire le style utilisé « dans tout ou partie de la publication de presse » en question, ce qui dispenserait le lecteur d’accéder à l’article originel. L’avocat général semble donc considérer que le droit européen protège la forme des articles de presse librement accessibles sur Internet mais pas le fond.

Il souligne aussi que, pour qu’ils soient retenus contre le fournisseur d’un chatbot, les actes de reproduction reprochés doivent être inhérents à son modèle économique, ou que ce fournisseur n’ait pas mis en place de mesures appropriées pour lutter contre ce genre de pratique de manière crédible et efficace.

Rappelons que les conclusions de l’avocat général ne sont pas contraignantes pour la CJUE, mais que, généralement, les juges de la Cour les suivent.

  •  

Les résultats de l’IA générative démotivent les jeunes mathématiciens

Des maths qui oublient l'humain ?
Les résultats de l’IA générative démotivent les jeunes mathématiciens

Alors qu’OpenAI et Anthropic ont affiché des « découvertes » scientifiques en laissant à la communauté le soin de vérifier les résultats obtenus par leurs IA, les jeunes chercheurs et chercheuses se sentent démotivés, bien qu’ils utilisent énormément ces outils.

Anna Brandenberger, Hannah Mularczyk et Dora Woodruff, trois jeunes chercheuses du département de maths du MIT ont lancé un sondage auprès de leurs jeunes collègues pour savoir quel est leur état d’esprit alors que, depuis plusieurs mois, l’IA générative bouscule la recherche en mathématiques. Il en ressort notamment que plus des trois quarts se disent d’un peu à très démotivés à travailler dans la recherche.

Elles ont mis en ligne le résultat de ce sondage sur la plateforme de prépublication arXiv en fin de semaine dernière. « Nous avons beaucoup entendu parler de l’IA en mathématiques de la part de lauréats de la médaille Fields, de laboratoires spécialisés dans l’IA et de professeurs reconnus », expliquent-elles. En effet, 25 lauréats de la médaille considérée comme le prix le plus prestigieux dans cette discipline ont publié un texte sur le sujet. « Cependant, ce sont les chercheurs en début de carrière qui ont le plus à y gagner ou à y perdre », ajoutent-elles.

Au final, elles ont pu obtenir les réponses de 268 jeunes chercheuses et chercheurs en mathématiques, soit en thèse soit postdocs et travaillant dans une soixantaine d’universités (une majorité venant des États-Unis, mais elles ont reçu aussi des réponses du Canada, d’Inde, des Pays-Bas, d’Allemagne, d’Angleterre et de France). Une grande partie des personnes qui ont répondu fait de la recherche en maths fondamentales (165).

Elles signalent que la plupart des réponses ont été données avant qu’OpenAI inonde la recherche, en début octobre, avec 722 « prépublications » de mathématiques générées par IA. Et évidemment, comme elles le soulignent, cet événement a sans doute encore fait évoluer les rapports des jeunes chercheuses et chercheurs face à l’IA générative. Mais leurs résultats restent intéressants pour comprendre comment cette technologie touche ce milieu.

Trois quarts des jeunes mathématiciens démotivés par les effets de l’IA sur leur discipline


Il reste 72% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

1 400 articles scientifiques rétractés en 24h : un record, 6 mois après le signalement

Mais une goutte d'eau dans l'océan de conférences douteuses publiées
1 400 articles scientifiques rétractés en 24h : un record, 6 mois après le signalement

Il y a six mois, des chercheuses et chercheurs signalaient avoir détecté plus de 1 800 actes de conférences scientifiques bidons dont les signatures avaient été achetées. L’un des principaux éditeurs, l’IEEE, vient d’annoncer la rétractation de plus de 1400 d’entre eux.

Fin avril, Next vous racontait l’histoire de chercheurs peu scrupuleux qui payaient des tiers pour publier des actes de conférences sans aucun sens dans des revues d’éditeurs parfois reconnus. Une bonne partie de ces articles viennent d’être rétractés par le principal éditeur en cause : l’Institute of Electrical and Electronics Engineers (IEEE). Cette association d’ingénieurs joue un rôle important dans l’élaboration de normes et publie chaque année plus de 200 autres revues scientifiques et actes de conférence. Les chercheuses et chercheurs qui ont fait le signalement il y a six mois se disent cependant contrariés par la manière dont l’association présente les choses.

Celle-ci a publié un communiqué la semaine dernière annonçant la rétractation d’ « environ 1 400 articles issus de la bibliothèque numérique IEEE Xplore, à l’issue d’une analyse approfondie ». « Les articles enfreignaient les principes de publication de l’IEEE, qui garantissent les normes les plus élevées en matière de qualité, de fiabilité et d’exactitude des publications scientifiques », ajoute l’éditeur qui affirme avoir mené une enquête après l’identification d’« irrégularités» par « une étude externe » dont il ne donne pas de détails.

1 417 rétractés en un jour, 1 622 rétractés en tout sur les 2 062 signalés

Selon le décompte de Miryam Naddaf, journaliste de la revue scientifique Nature, c’est plus précisément 1 417 actes de conférences qui ont été rétractés par l’IEEE le 23 octobre dernier. Et ceux-ci avaient tous été identifiés dans un article mis en ligne par les chercheuses et chercheurs Anna Abalkina, Marie Kunešová, Yagmur Ozturk et Solal Pirelli en avril dernier et que Next vous avait relayé. Leur article expliquait que certains chercheurs achetaient via des pubs sur Telegram ou LinkedIn la possibilité de signer ces actes de conférences, ce qui faisait augmenter leurs statistiques de publication.

De 1 800 faux actes détectés à l’époque, ces chercheuses et chercheurs en ont dénombré plus de 4 000 depuis, dont 2 062 rien que dans les actes publiés par l’IEEE. « Ces articles problématiques ont été co-signés par plus de 7 500 chercheurs issus de plus de 4 000 institutions réparties dans 56 pays », soulignent-ils dans la version de leur article mis à jour le 11 aout dernier.

Et si l’IEEE en a rétracté 1 417 le 23 octobre, en tout, l’éditeur a rétracté 1 622 des 2 062 signalés par Anna Abalkina et ses collègues, selon Nature qui a vérifié avec l’outil Problematic Paper Screener du chercheur toulousain Guillaume Cabanac, dont on vous parlait en 2022.

« Une goutte d’eau dans l’océan des conférences douteuses »

Pour Solal Pirelli, l’un des auteurs du signalement, « c’est un bon début, mais ce n’est qu’une goutte d’eau dans l’océan des conférences douteuses qu’ils publient chaque année », explique-t-il sur Bluesky. Il ajoute : « Ils doivent rétracter l’intégralité des actes dont le processus d’évaluation par les pairs a manifestement échoué, car les articles qui en résultent ne peuvent pas être qualifiés d’« évalués par les pairs ».

« Même si je me réjouis que l’IEEE ait commencé à retirer les articles que nous avions signalés, je suis un peu contrariée par leur communiqué officiel », affirme quant à elle Marie Kunešová, une autre chercheuse qui a participé au signalement. Elle se moque de la façon dont l’éditeur présente comment il a procédé pour filtrer les articles à rétracter :

« « Un éditeur de premier plan s’appuie sur une technologie de filtrage innovante et l’avis d’experts » ? C’est drôle, cette technologie ressemble beaucoup à : « si le titre correspond exactement à l’annonce, retirer ; sinon, ne pas retirer » ».

  •  

La taxe PS au gigaoctet votée à l’Assemblée nationale fait réagir de VLC à OVHCloud

« Ignares incompétents »
La taxe PS au gigaoctet votée à l’Assemblée nationale fait réagir de VLC à OVHCloud

En fin de semaine dernière, le Parti socialiste a réussi à faire passer un amendement au projet de loi de finance 2027 créant une taxe sur le transit internet en France. Ce projet de taxe, qui n’est pas le premier du genre, a fait réagir dans le milieu numérique français, des PDG d’Iliad et OVHCloud au projet open source de lecteur vidéo VLC.

Mise à jour le 2 novembre à 14h10 avec la précision sur le fait que VideoLAN ne ferait pas l’objet d’une taxe aussi importante que ce qu’annonce VLC.

De VLC à Xavier Niel en passant par Octave Klaba, la taxe au gigaoctet du Parti socialiste (PS) votée par 11 députés fait réagir le milieu du numérique français. Ainsi, le patron d’Iliad a simplement tweeté : « Ce sont des ignares incompétents ».

Un coût de plus d’un million d’euros par an pour VideoLAN et de 23 à 70 millions pour OVHCloud

Octave Klaba, le propriétaire d’OVHCloud, a quant à lui publié un long message montrant le coût important de la taxe votée sur le prix du transit, du peering et du trafic sortant des hyperscalers, mais aussi du cas de sa propre entreprise. Il fait ainsi remarquer qu’avec un port 100Gbits/s dont il estime le coût en interconnexion directe avec un FAI européen entre 20 à 30 k€ par mois, « la taxe atteint 1,02 M€ par mois, soit environ 3 400 % à 16 300 % du prix d’une interconnexion vers les FAI français ». Concernant directement le cas d’OVHCloud, il explique :

« Nous envoyons de l’ordre de 500 Gbps au 95e percentile vers les FAI français, soit environ 324 Gbps en moyenne. Sur un an, la taxe brute atteindrait 70 M€. Le texte la plafonne à 15 % du CA réalisé en France ou à 2 % du CA mondial, soit entre environ 23 et 70 M€ par an que nous devrions collecter pour l’État, et donc répercuter sur nos clients. »

Pour VLC, le compte du projet open source affirme que cette taxe coûterait à VideoLAN « plus d’un million d’euros par an », ajoutant : « N’oubliez pas que nous sommes une association à but non lucratif qui ne dispose pratiquement pas de moyens financiers pour fournir des logiciels gratuitement… ». Sur LinkedIn, le président de VideoLan, Jean-Baptiste Kempf, fait remarquer aussi la difficulté d’attribuer une taxe sur un trafic chiffré.

Remarquons quand même que l’amendement en question prévoit que cette taxe fasse « l’objet d’un plafonnement correspondant au maximum à 15 % du chiffre d’affaires réalisé en France par l’émetteur ou à 2 % de son chiffre d’affaires total ». Ainsi, contrairement à ce que VLC affirme, VideoLAN ne paierait sans doute pas 1 million d’euros par an, sauf si cela correspond à 2 % de son chiffre d’affaires, ce qui semble énorme pour une association à but non lucratif comme celle-ci.

LFI affirme s’être trompé, mais d’autres projets similaires ont déjà été présentés

Côté députés français, Éric Coquerel (LFI) qui a voté le texte, a affirmé sur X, avec un autre député LFI, qu’ils se sont « trompés de bouton sur cet amendement qui fait payer les utilisateurs au lieu des plateformes ». Il ajoute : « On a demandé depuis à faire corriger notre vote. Cet amendement n’aura de toutes façons aucune portée puisque le budget sera rejeté ». Une note de communauté fait remarquer que le président de la commission des Finances avait signé un amendement (retiré avant discussion) similaire en 2024 avec son groupe, proposant même un montant plus important (100 € par térabit).

Rappelons aussi que d’autres propositions moins importantes ont été faites, par exemple par le député Philippe Latombe (Les Démocrates) en 2024 (non soutenu) ou par Jean-Philippe Tanguy (RN) en 2025 (qui avait été rejeté).

À l’époque, Philippe Latombe avait prévu de limiter cette taxe aux « personnes désignées contrôleurs d’accès par la Commission européenne ». Sa proposition fixait la contribution à 12 000 euros par Gigabits/sec d’utilisation annuelle moyenne de cette bande passante et donnait à l’Arcep le rôle d’identifier cette utilisation.

Celle de Jean-Philippe Tanguy visait « les personnes morales fournisseurs de contenu et d’applications qui font appel à plusieurs intermédiaires pour acheminer leur contenu jusqu’aux utilisateurs finaux […] utilisant une bande passante moyenne annuelle supérieure à 1Gbit/sec ». Elle était aussi fixée à 12 000 euros par Gigabits/sec d’utilisation annuelle moyenne de cette bande passante.

On ne saura jamais si les députés LFI se sont vraiment trompés, mais une chose est vraie dans les propos d’Éric Coquerel concernant cet amendement : il y a peu de chances qu’il soit, au final, inclus dans la loi de finances 2027. Comme nous l’avions expliqué vendredi dernier, la majorité du Sénat ne devrait pas la voter et il est fort probable que le Premier ministre, Sébastien Lecornu, fasse passer son texte via l’article 49.3 sans y intégrer cette fameuse taxe.

  •  

[MàJ] La taxe au gigaoctet emportée par le rejet du projet de loi de finances 2027

Taxman
[MàJ] La taxe au gigaoctet emportée par le rejet du projet de loi de finances 2027

Le Parti socialiste avait réussi à faire passer sa « taxe au gigaoctet » censée faire contribuer les géants du numérique à l’infrastructure française. Une taxe finalement rejetée lors du vote lapidaire du volet recettes du projet de loi de finances 2027.

Mise à jour du 5 novembre à 21h04. La partie recettes du projet de loi de finances 2027 a été rejetée à l’unanimité par l’Assemblée : 458 voix contre, aucune voix pour, pas même un député macroniste. Cette première partie n’ayant pas été adopté, c’est tout le texte qui est rejeté.

À l’AFP, le Premier ministre Sébastien Lecornu relativise : « C’est le scénario classique, puisque c’est ce qui se passe depuis trois exercices budgétaires, depuis l’automne 2024 ». Le texte proposé par le gouvernement avait été largement modifié par les députés avant le vote. Le projet de loi reste en piste, il sera examiné à partir du 20 novembre au Sénat, mais dans sa version initiale. Donc avant l’adoption surprise du fameux amendement sur la taxe au gigaoctet qui a fait tant parler.

Article original du 30 octobre. Cet été, le Parti socialiste a exposé son projet politique pour les prochaines années. Nous en avions détaillé le pan numérique qui incluait une taxe de 0,10 euro par gigaoctet distribué par les géants du numérique sur le territoire pour financer « l’infrastructure du réseau » français.

11 députés dans l’hémicycle ont suffi

Dans une ambiance très incertaine sur le vote final de la loi de finances 2027, il semble avoir fait un pas symbolique dans ce sens. En effet, le député PS Laurent Lhardit avait déposé un amendement portant sur la création d’une taxe sur les producteurs de données numériques, qui a été adopté ce vendredi 30 octobre à l’Assemblée. Il a été voté dans un hémicycle quasiment vide : en effet, comme le relate le compte rendu de la session, seuls 35 députés étaient présents, 21 se sont exprimés et 11 ont voté pour.

Ce texte institue « une taxe assise sur les flux de données numériques émises par les fournisseurs de contenu et acquittée par ces derniers ».

Il demande aux fournisseurs d’accès à Internet « et toute entreprise proposant un service d’accès à internet aux ménages et entreprises » de mettre en place une procédure de collecte des quantités de données transitant vers leurs clients en identifiant l’émetteur de ces données. Cette collecte doit être faite, selon le texte, de façon anonymisée et consolidée. La procédure doit être supervisée par l’Arcep.

« Lorsqu’un émetteur de données utilise un réseau de diffusion de contenus visant à mettre en cache le contenu à proximité des utilisateurs finaux, la quantité de données émises est considérée égale à la somme des flux sortant du réseau de diffusion », ajoute le texte : « L’émetteur est redevable d’une taxe égale au produit de la somme des volumes de données produits et relevés par les fournisseurs d’accès à internet exprimés en gigaoctet et 0,055 euros ».

Un rendement de 10 milliards espéré

En séance, Laurent Lhardit a affirmé que « son rendement est estimé à 10 milliards d’euros. La taxe serait principalement acquittée par les géants mondialisés du numérique, puisqu’ils émettent l’immense majorité des flux adressés aux abonnés internet en France ».

Il a ajouté que cette taxe devrait rétablir une « équité fiscale entre l’économie implantée de nos commerces, qui souffrent tant aujourd’hui, et les géants du commerce en ligne, américains et asiatiques, qui échappent très largement à l’impôt si l’on considère la valeur financière qu’ils retirent de leurs activités sur le marché français ».

Le rapporteur général de la commission des finances, Philippe Juvin, a exprimé le désaccord de cette commission : « le risque est [que les GAFAM] répercutent le poids de cette taxe sur les annonceurs. Avis défavorable », affirmait-il.

Une taxe à l’avenir très incertain

Côté gouvernement, David Amiel a lui aussi exprimé un avis défavorable : « le dispositif que vous proposez obligerait à disposer de capteurs de flux, ou, à tout le moins, à mesurer ceux-ci au niveau des terminaux individuels de réception ». Il a aussi estimé que « la moitié de la taxe –⁠ soit tout de même 5 milliards d’euros selon votre proposition – ne pèserait pas sur les grandes entreprises du numérique mais sur des fournisseurs de contenus de plus petite taille, notamment sur des fournisseurs français ».

Reste que le futur de cette taxe est assez flou. En effet, il est peu probable qu’elle soit votée par le Sénat à majorité LR. De plus, il n’est pas certain que le budget soit lui-même voté par le parlement. La présidente de l’Assemblée nationale, Yaël Braun-Pivet, a d’ores et déjà appelé le Premier ministre, Sébastien Lecornu, à utiliser l’article 49.3 pour couper court aux débats, dans un entretien au Figaro ce mardi 27 octobre. Le gouvernement aurait tout le loisir de ne pas inclure cet amendement, même voté, au texte sur lequel il engagerait sa responsabilité.

  •  

Polymarket piratée : les comptes de certains utilisateurs ont pu être vidés

Bête clic
Polymarket piratée : les comptes de certains utilisateurs ont pu être vidés

L’entreprise de paris en ligne a dû suspendre l’accès à sa plateforme pendant un peu moins d’une heure : des pirates ont pu accéder aux comptes de certains de ses utilisateurs et récupérer les sommes accumulées. Polymarket rejette le problème sur un prestataire tiers. Celui-ci pourrait être DebugBear.

Ce jeudi 29 octobre, Polymarket a annoncé avoir mis temporairement sur pause l’utilisation de sa plateforme internationale Polymarket.⁠com, sur laquelle elle n’a permis pendant un peu moins d’une heure à ses utilisateurs que d’annuler leurs paris.

« Polymarket.⁠com : La plateforme de change fonctionne actuellement en mode « annulation uniquement » et les opérations des relais sont suspendues le temps que nous menions une enquête sur un incident », informait le compte X de l’entreprise hier soir. Une heure plus tard, elle affirmait que le problème était résolu après avoir expliqué : « L’un de nos prestataires tiers a été victime d’une intrusion, et nous avons signalé ce fait aux autorités compétentes ».

Un remboursement … après décharge juridique pour les sommes au-dessus de 10 000 dollars

Mais l’incident semble avoir fait perdre leurs portemonnaies à certains utilisateurs de la plateforme. Si l’entreprise n’a pas explicitement confirmé que certains ont perdu de l’argent, elle assurait que « Toute personne ayant subi un préjudice sera indemnisée intégralement ».

Selon CNBC, Polymarket a expliqué à ses utilisateurs sur Discord que les personnes qui ont perdu moins de 10 000 dollars se verront remboursées d’ici le 30 octobre. Pour ceux dont la somme perdue est plus importante, ils devront d’abord signer une décharge pour pouvoir récupérer leur argent. L’entreprise d’analyse de données Bubblemaps a estimé à plus de 700 le nombre d’utilisateurs touchés, et évoque le chiffre de 2,7 millions de dollars volés.

Selon des sources de Reuters, le problème viendrait de l’utilisation des outils de DebugBear. En parallèle de l’incident, cette entreprise qui fournit des outils de monitoring pour les sites web a posté un message sur X expliquant que « Nous sommes actuellement confrontés à un incident de sécurité », et demandant à ses utilisateurs : « si vous utilisez notre produit RUM, veuillez supprimer le code d’intégration de votre site web ». Selon CNBC, comme DebugBear est basée au Royaume-Uni, c’est aux autorités de ce pays que Polymarket a indiqué le problème. DebugBear n’a pas répondu aux sollicitations de nos confrères pour en savoir plus.

Une plateforme illégale en France et ailleurs

Ce problème de sécurisation des portemonnaies des utilisateurs de Polymarket ne va pas arranger ses relations avec les autorités à travers le monde. Rappelons que l’activité de Polymarket est mise en cause par l’État de New York pour activité illégale de jeux d’argent.

En France, le site de l’entreprise est bloqué par les principaux fournisseurs d’accès à Internet via une demande de l’Autorité nationale des jeux (ANJ), qui considère qu’il « fait la promotion d’une offre illégale de jeux d’argent et de hasard ». En septembre, l’entreprise faisait du lobbying en Europe pour assurer aux autorités que son activité était plus à ranger dans celles des « marchés prédictifs » que de sites de paris en ligne.

  •  

LFI s’inspire de la campagne numérique de Lula, au risque de dépendre de Meta

L'élection se gagnera-t-elle un jour sur les réseaux ?
LFI s’inspire de la campagne numérique de Lula, au risque de dépendre de Meta

Après la réélection de Lula au Brésil, les têtes se sont tournées vers son équipe de campagne et notamment vers son organisation sur les réseaux sociaux. Sautant sur l’opportunité, La France Insoumise revendique s’en inspirer.

Comme nous l’expliquions, il y a des enseignements à tirer de la manière dont s’est passée la campagne présidentielle brésilienne concernant la forme que les discours politiques prennent désormais en ligne. La France Insoumise revendique s’inspirer directement de la campagne mise en place par les équipes de Luiz Inácio Lula et notamment du travail fait par le député brésilien André Janones. Mais cela signifie aussi parier sur les outils des géants du numérique, à commencer par Meta, et mettre de côté les alternatives au prix d’un risque d’ingérence.

La France Insoumise n’a pas réellement investi d’autres réseaux sociaux aux protocoles plus ouverts comme Bluesky ou Mastodon, par exemple. Et elle ne semble pas parier sur ces réseaux pour la campagne de 2027.

S’inspirer d’une campagne qui a gagné, ça fait toujours bien

Communiquer sur l’inspiration d’une campagne numérique réussie n’est pas nouveau. Peu après l’élection de Barack Obama beaucoup de personnalités politiques ont revendiqué s’être inspirées de sa campagne. Ainsi, pour les campagnes de 2017, le logiciel Nation Builder s’inspirant du travail de l’équipe de campagne du 44ᵉ président des États-Unis avait été utilisé par Donald Trump comme par Jean-Luc Mélenchon ou Alain Juppé.

Aujourd’hui, les équipes de La France Insoumise préfèrent s’afficher dans la ligne du président brésilien. Il vient d’être réélu à tout juste 81 ans, et le maire LFI de Saint Denis a rapidement posté sur X un message clamant « Le Brésil l’a fait, la France peut le faire ! ».

Mais c’est du côté des pratiques du représentant de l’État rural de Minas Gerais au Congrès national du Brésil, André Janones, que le mouvement de gauche affirme s’inspirer et notamment de son canal Exercito de Lula (Armée de Lula) qui, comme nous l’expliquions, est très vite passé de 50 000 abonnés à plus de 10 millions. L’euphorie de la victoire peut rapidement lui donner un poids important alors qu’il est difficile à mesurer.

Qu’importe, certains ont même déjà fait de ses principes une doctrine à suivre sur les réseaux en temps de campagne : le Janonisme. Dont ceux concernant les propos des militants de l’extrême droite sur les réseaux sociaux : ne pas commenter, ne pas partager, ne pas interagir.

Calquer une campagne qui ne se passe pas vraiment dans les mêmes conditions

Dans un billet de blog, le député LFI Antoine Léaument, qui est aussi responsable communication du mouvement, revendique clairement de s’en inspirer. Ainsi, il résume en six leçons cette doctrine de communication allant de « développer un canal Whatsapp » comme « L’Armée de Lula » à invisibiliser l’extrême droite sur les réseaux tout en la provoquant en passant par lui contester l’usage des symboles nationaux et « gamifier » la campagne.

Ainsi, LFI semble calquer la campagne brésilienne en créant une chaine WhatsApp nommée de façon un poil moins guerrière « L’équipe de Mélenchon ».

Interrogée par Next sur l’utilisation de ce genre de chaînes en campagne électorale, la CNIL nous explique qu’ « en première analyse, ce type de service apparait fonctionner comme tout compte d’un organisme sur un réseau social, à savoir que l’utilisateur choisit de s’abonner pour suivre les publications et, ce faisant, les traitements de données personnelles mis en œuvre sont soumis au RGPD et relèvent de la responsabilité, chacun pour ce qui les concerne, du fournisseur de service (ici Meta) et de l’éditeur de la chaîne (ici LFI) ». Elle ajoute qu’ « il convient de préciser que si des sollicitations étaient adressées aux utilisateurs du réseau social en vue de s’abonner à la chaîne en ayant recours à un système de ciblage, alors les dispositions du règlement sur la prospection politique viendraient à s’appliquer, ce qui implique notamment : une collecte des données directement auprès des personnes, le recueil préalable de leur consentement à ce démarchage, des obligations de transparence renforcées et une interdiction de s’adresser à des mineurs ».

Mais, en faisant ce pas, LFI se livre elle-même dans les bras d’une entreprise qui, au Brésil justement, a été accusée d’ingérence dans la campagne contre Lula. Et, comme la plupart des partis politiques français, La France insoumise continue à utiliser massivement le réseau social X d’Elon Musk alors que celui-ci a aussi été accusé d’ingérences dans les débats démocratiques en Europe. Antoine Léaument souligne que cette chaine WhatsApp a permis, justement, d’éviter d’être trop touchée par l’ingérence de Meta qui a invisibilisé ses contenus et a bloqué pendant un temps à l’équipe de campagne de Lula la possibilité de sponsoriser ses contenus.

Mais le mouvement de Jean-Luc Mélenchon met en place une stratégie qui a été élaborée dans un pays qui n’a pas les mêmes règles électorales concernant l’utilisation des réseaux sociaux. Comme nous l’expliquions, la loi électorale brésilienne interdit toute recommandation algorithmique sur les réseaux sociaux mais permet l’utilisation des messages sponsorisés pour augmenter leur audience.

À l’inverse, côté français, la Commission nationale des comptes de campagne et des financements politiques a rappelé récemment que la recommandation algorithmique gratuite est autorisée mais que « toutes les formes de publicité à des fins de propagande électorale sur les réseaux sociaux sont interdites jusqu’à la date du tour de scrutin où l’élection a été acquise ».

S’il y a des règles à la radio et à la télévision afin d’assurer le pluralisme politique, ce n’est pas le cas sur Internet et les réseaux sociaux : « Les pratiques sont par essence différentes entre ces deux espaces. On ne peut pas dupliquer le pluralisme sur l’espace numérique », reconnaissait l’Arcom. Sur Internet, c’est de la consommation à la demande et/ou algorithmique.

Et si le Janonisme peut galvaniser les troupes sur les réseaux sociaux, aucune élection n’a été gagnée à la seule force d’une stratégie numérique, même celle de Lula.

  •  

Addiction aux réseaux sociaux : Meta a voulu monter les chercheurs contre l’un d’entre eux

Meta, le Marlboro du 21è siècle ?
Addiction aux réseaux sociaux : Meta a voulu monter les chercheurs contre l’un d’entre eux

Dans un procès concernant la mise en place de mécanismes d’addiction visant les ados sur ses plateformes, des documents révèlent que Meta a réfléchi à un plan pour discréditer Jonathan Haidt, un des psychologues les plus critiques de l’entreprise.

À la fin de l’été dernier, Meta a accepté de verser 18 milliards de dollars pour mettre fin aux plaintes de quatre États américains l’accusant d’avoir rendu Facebook et Instagram addictifs pour les mineurs. Mais l’entreprise de Mark Zuckerberg n’en a pas pour autant fini avec ce sujet devant les tribunaux. Un des procès encore en cours montre que l’entreprise a essayé de contrôler le discours scientifique sur ses produits.

En effet, des documents montrent, comme l’a remarqué le média Law 360, qu’en 2023 l’entreprise avait en tête de cibler Jonathan Haidt, chercheur et enseignant à la Stern School of Business de l’université de New York. Celui-ci a écrit le livre Génération anxieuse (publié en anglais en 2024 et en français en 2025) et a ainsi fourni, selon le New York Times, « un texte de référence à une coalition en cours de formation visant à protéger les enfants contre les géants de la technologie, un collectif informel composé de parents soucieux de la sécurité de leurs enfants, d’adolescents exaspérés, de candidats potentiels à la présidence et de célébrités en quête d’une cause sociale « non controversée » ».

Une « Mission Haidt » au sein de Meta

Des notes prises durant une réunion de l’entreprise [PDF] montrent qu’une « mission Haidt » a été créée. Selon ces notes, le but d’un certain Curtiss (sans doute le vice-président « Recherche fondamentale et sciences appliquées » de Meta, Curtiss Cobb) est de trouver « Comment amener la communauté universitaire à désavouer Haidt ? ».

Après cette question, les notes prises dans cette réunion décrivent le fait que l’entreprise « ne peut pas les rallier à [sa] cause » et posent la question : « Alors comment faire pour les mettre en rage ? ». Elles continuent en expliquant que ce que l’entreprise essaye d’accomplir est plus une « campagne discrète » qu’une campagne médiatique. Et y est suggéré d’« amener Gellman à rédiger un article de démolition ».

Le nom de Gellman avec deux l ne correspond à personne de connu sur ce genre de sujets de recherche. Mais un autre chercheur au nom d’Andrew Gelman (avec un seul l) est un statisticien qui travaille aussi sur les sciences politiques à l’université de Columbia.

Andrew Gelman embarqué dans l’histoire à l’insu de son plein gré ?

Celui-ci avait publié en 2012 deux billets de blog (ici et là) critiquant le travail de Jonathan Haidt. Dans un nouveau billet de blog, Andrew Gelman a réagi à la publication de ces notes en affirmant : « Moi non plus, je ne sais pas vraiment qui est Gellman ! Mais je vais vous dire une chose : je n’ai jamais été contacté par qui que ce soit chez Facebook ou Meta au sujet de Jonathan Haidt ou de ses travaux ».

Tout en reconnaissant avoir reçu des financements de la part de Facebook (mais pas dans le cadre de ce sujet), il ajoute : « En toute sincérité, cette révélation concernant l’équipe de relations publiques de Facebook est tout simplement effroyable — il s’agit là de certaines des personnes les plus riches et les plus puissantes au monde qui s’entendent pour entraver le bon déroulement des processus scientifiques, journalistiques et juridiques — mais elle n’a rien de surprenant, compte tenu de ce que nous avons appris grâce à des témoignages d’initiés tels que Careless People ».

Selon Gizmodo, le livre Restoring Childhood du chercheur en psychologie au Boston College, Peter Gray, sorti en anglais en septembre dernier, s’emploie à réfuter la théorie de Jonathan Haidt sans qu’il n’ait besoin que Meta le pousse.

« La tech est le nouveau tabac »

Cailin O’Connor, chercheuse en philosophie des sciences à l’université de Californie à Irvine, en profite pour pointer à nouveau du doigt les méthodes de l’industrie du numérique par rapport à la recherche sur ses produits. Dans un billet titré « c’est désormais officiel : la tech est le nouveau tabac », elle estime que les procès comme celui dont il est question ici « soulèvent également des questions importantes et difficiles à trancher concernant la causalité. La santé mentale des jeunes est peut-être affectée, mais il est délicat de prouver que c’est l’utilisation des réseaux sociaux qui en est la cause ».

Elle ajoute que c’est pour ça que la science « revêt une importance capitale dans ces affaires ». Mais elle remarque que « c’est également la raison pour laquelle les industries qui fabriquent des produits nocifs ont tout intérêt à aider la science à répondre aux questions concernant ces produits ».

Et elle n’hésite pas à faire le lien entre cette affaire et les stratégies des industries du tabac et du pétrole pour nier la nuisance de leurs produits : « Nous savons tous comment l’industrie du tabac a réussi à retarder pendant des décennies l’émergence d’un consensus et la mise en place d’une réglementation sur les cigarettes. Nous savons également comment les secteurs du pétrole et du gaz continuent de se battre désespérément pour empêcher toute réglementation des combustibles fossiles ».

La chercheuse avait déjà participé à une étude qui dénonçait le problème du financement de la recherche sur le numérique en montrant que, dans près d’un tiers des articles scientifiques à propos des réseaux sociaux, l’information sur les liens d’intérêt n’est pas indiquée.

  •  

Un compte Instagram contre Trump temporairement fermé, Zuckerberg sommé d’expliquer

No kings, ça s'adresse aussi à Mark ?
Un compte Instagram contre Trump temporairement fermé, Zuckerberg sommé d’expliquer

Alors que les élections de mi-mandat arrivent, Mark Zuckerberg est sommé par des élus démocrates de s’expliquer sur le blocage temporaire d’un compte « No Kings » qui co-organise des manifestations aux États-Unis contre l’autoritarisme de Donald Trump.

Le compte Instagram No Kings Coalition est maintenant accessible et l’équipe qui le gère a de nouveau la main dessus. Mais le 17 octobre, ce compte a été suspendu pendant un peu plus d’une heure, sans pouvoir être administré pendant plus de trois heures. Meta s’est excusée et a affirmé que c’était un problème technique, mais la question est reprise par des élus démocrates alors que la campagne électorale des mid-terms arrive à sa fin.

Cette campagne politique reprend le mot d’ordre « No Kings » qu’on peut retrouver régulièrement dans les manifestations contre Donald Trump aux États-Unis depuis octobre 2025. Le dirigeant avait critiqué, il y a un an, ce mouvement avec une vidéo scatologique générée par IA.

Le compte No Kings Coalition a plus de 27 000 abonnés et, au-delà de ces manifestations, pousse les états-uniens à aller voter (notamment en avance et par correspondance, puisque le système électoral de nombreux États le permet) avec des slogans comme « vote early ».

Meta explique le problème par une utilisation intensive de Claude

Les animateurs du compte semblent utiliser des outils d’automatisation et c’est ce genre de pratiques qui auraient, selon Meta, déclenché le blocage du compte. « Lorsque des comptes publient, partagent ou commentent à une fréquence très élevée, cela peut déclencher des systèmes automatisés. C’est ce qui s’est produit avec le compte Instagram « No Kings » à l’approche de la journée d’action d’aujourd’hui » affirmait Andy Stone le 18 octobre , porte-parole de Meta. « Malheureusement, cette intervention automatisée était manifestement une erreur. Tout fonctionne désormais comme il se doit et nous vous présentons nos sincères excuses », a-t-il ajouté.

L’équipe en charge du compte a posé huit questions à l’entreprise dans une lettre ouverte [PDF] pour en savoir plus. Comme par exemple : « Quelles actions spécifiques menées par le compte No Kings Coalition auraient enfreint les règles de Meta, et quelles règles étaient concernées ? ». L’entreprise a expliqué le blocage par « le fait que [ses] systèmes de sécurité réseau ont détecté une augmentation spectaculaire de l’utilisation d’un outil Claude pour analyser les profils, les publications et les hashtags ». « Par rapport à ce que [ses] systèmes avaient observé auparavant, le rythme de cette activité a été multiplié par quatre environ lors de pics intenses le 17 octobre », a-t-elle ajouté.

Une réponse qui ne satisfait pas les activistes

Cette réponse n’a pas suffi à No King Coalition qui demande [PDF] à Meta de répondre aux « questions plus générales de transparence, de responsabilité et d’ingérence potentielle dans les communications publiques au cours d’une élection encore en cours ».

L’équipe est donc maintenant soutenue par deux membres démocrates de la Chambre des représentants des États-Unis, Robert Garcia et Jamie Raskin. Dans une lettre ouverte [PDF] à Mark Zuckerberg, les élus demandent eux aussi plus de détails car « Meta a la responsabilité de ne pas porter atteinte à l’intégrité de nos élections ni d’enfreindre le droit du public à mener des activités politiques protégées par la Constitution », écrivent-ils. Ils demandent à l’entreprise de leur présenter, « au plus tard le 9 novembre 2026, un exposé sur ses mesures en matière de sécurité électorale et sur ces incidents ».

Dans leur lettre, les deux élus font aussi référence aux élections au Brésil où Meta a été sommée par la justice de prouver qu’elle ne faisait pas d’ingérence.

  •  

Les utilisateurs de Starlink ciblés par Discover-Tech, impliquée dans une attaque zéro-clic

Ciblage beaucoup plus que publicitaire
Les utilisateurs de Starlink ciblés par Discover-Tech, impliquée dans une attaque zéro-clic

L’entreprise de marketing israélienne Discover-Tech a participé à une attaque zéro-clic installant un logiciel espion via des publicités. Elle vise particulièrement les utilisateurs du réseau Starlink, selon des sources de l’agence de presse Reuters.

L’agence de marketing israélienne Discover-Tech, impliquée dans la diffusion d’un logiciel espion via une attaque zéro-clic, est aussi une des entreprises qui enchérissent le plus pour obtenir des publicités sur le réseau Starlink. Ainsi, elle serait en capacité de localiser assez facilement des utilisateurs de ce réseau qui permet à ses utilisateurs de passer à travers les surveillances gouvernementales.

Mi-octobre, on apprenait que Discover-Tech avait mis au point une attaque zéro-clic installant un logiciel espion via la publicité ciblée. Les chercheurs de Citizen Lab et de Cinfiant avaient constaté que des appareils des équipes du média Al Jazeera avaient été choisis pour être infectés avec un logiciel espion attribué à la société Candiru.

En parallèle, des chercheurs de l’entreprise de sécurité Trend Micro publiaient un rapport sur les activités d’un groupe nommé SHADOW-EARTH-79 qui utilise aussi la publicité ciblée pour « suivre et établir le profil de personnes se trouvant dans des zones de conflit, des États soumis à des sanctions et d’autres lieux sensibles à travers le monde ».

Des sources anonymes affirment que Discover-Tech et SHADOW-EARTH-79 sont la même entité

Selon plusieurs sources de Reuters, Discover-Tech est l’entité réelle qui se trouve derrière le groupe SHADOW-EARTH-79. Les chercheurs de l’unité TrendAI de Trend Micro ne citent pas le nom de l’entreprise israélienne : cette unité s’est donné des règles très prudentes concernant l’attribution des menaces cyber qu’elle découvre. Mais six sources ont confirmé à l’agence de presse que Shadow-Earth-79 est le nom de code utilisé par TrendAI pour désigner Discover-Tech.

Selon TrendAI, ce groupe est sur le trafic des adresses IP de Starlink, ce groupe est la deuxième entreprise concernant le nombre d’enchères gagnées pour placer des publicités (12,9%) derrière l’entreprise américaine de marketing ciblé Steelhouse  qui a obtenu 38,4 % des enchères sur une période de 90 jours étudiée.

TrendAI a pu observer que ce groupe avait gagné des enchères publicitaires dans 150 pays concernant le trafic des adresses IP de Starlink. « Certains de ces pays (le Cameroun, la Syrie, le Soudan, la Birmanie et la Libye) sont des pays où Starlink est officiellement interdit ou soumis à des restrictions réglementaires », remarquent-ils dans leur rapport. Mais on peut y voir qu’y figurent aussi la France, l’Italie ou l’Espagne où le groupe est premier enchérisseur concernant les pubs du trafic de Starlink.

Infrastructure de ciblage et de suivi plutôt que d’opération publicitaire commerciale

Concernant les enchères publicitaires sur tout le trafic (et non plus seulement Starlink), selon TrendAI, ce groupe est « le premier enchérisseur dans 49 pays où les données publicitaires font l’objet d’enchères ». « Dans plusieurs cas, il détient une part incroyablement dominante de l’ensemble des enchères, ce qui ne correspond pas à un achat publicitaire concurrentiel normal », ajoutaient les chercheurs en cybersécurité. Ils pointaient notamment son « quasi monopole » en Hongrie, en Israël, en Égypte, en Azerbaïdjan et au Venezuela où le groupe fait entre 72 % et 91 % des offres.

Le rapport de TendAI concluait que « les éléments de preuve recueillis indiquent, avec un niveau de confiance modéré à élevé, que la présence publicitaire de SHADOW-EARTH-79 sert d’infrastructure de ciblage et de suivi plutôt que d’opération publicitaire commerciale ».

Contactées par Reuters, Discover-Tech mais aussi SpaceX n’ont pas répondu aux demandes de commentaires sur le sujet de nos confrères.

En mai dernier, Intelligence Online expliquait qu’une autre entreprise israélienne, Targeteam qui a aussi un bureau à Chypre, allait dévoiler un nouvel outil dédié à la désanonymisation des utilisateurs du système Starlink. Cette entreprise est la « nouvelle aventure business d’un vétéran du secteur cyber israélien et légende de l’export, Ron Zilka », selon nos confrères. De son côté, le média israélien Haaretz parlait de deux entreprises du même pays capables de localiser les terminaux satellitaires de Starlink alors que ce système permet, par exemple, à l’armée ukrainienne de se défendre face à l’envahisseur russe. Mais récemment, le pays de Volodymyr Zelensky a accusé Starlink d’avoir restreint l’accès à Internet de ses forces militaires.

  •  

OpenAI patauge encore en annonçant des « découvertes » scientifiques sans en être sûr

Démerdez-nous avec ça
OpenAI patauge encore en annonçant des « découvertes » scientifiques sans en être sûr

L’entreprise de Sam Altman continue de promouvoir la puissance de ses outils en les employant sur divers problèmes de recherche scientifique. Mais n’ayant pas les compétences en interne, elle cherche toujours à savoir comment rendre publique cette production sans trop fâcher la communauté scientifique.

Depuis le printemps, OpenAI comme Anthropic bandent les muscles en annonçant régulièrement des « découvertes » scientifiques. Ainsi, fin septembre, l’entreprise de Dario Amodei affirmait, elle, avoir découvert un nouveau système enzymatique, « dont la structure rappelle celle du système CRISPR » alors que tout le travail de recherche en biologie reste à faire pour démontrer ce qui n’est pour l’instant qu’une hypothèse.

Après avoir inondé la recherche avec 722 « prépublications » de mathématiques générées par IA, OpenAI vient encore d’annoncer sans prendre de pincettes « trois nouvelles découvertes en mathématiques, en informatique et en physique, portant respectivement sur l’analyse harmonique, la théorie de la complexité et la théorie quantique des champs ». Mais, encore une fois, les résultats n’ont pas été relus par des chercheurs.

Comme ces entreprises d’IA générative en ont pris l’habitude, c’est dans un billet de blog qu’OpenAI a fait l’annonce de ces « découvertes » scientifiques. Mais l’entreprise patauge encore dans sa façon de gérer le partage de ses résultats aux communautés de chercheuses et chercheurs qui travaillent parfois depuis des années sur les sujets auxquels elle s’attaque. Car, n’ayant pas d’employés capables de s’attaquer à tous ces sujets, elle se retrouve avec des problèmes qu’elle ne peut maitriser en interne. Ainsi, comme différents chercheurs nous l’ont souligné, ces résultats restent « la première étape d’une découverte scientifique, pas la dernière ».

Consultations de « guides » pour savoir quoi faire de ces « résultats »

La mise en ligne des 722 « prépublications » à différents stades de vérification ne semble pas être la solution miracle pour un partage serein avec les chercheurs. OpenAI tente donc encore une autre méthode. Elle indique faire appel à des experts externes qu’elle qualifie de « guides » (shepherds, en anglais), mais dont elle ne donne pas les noms.

Concernant le problème de maths dont elle affirme que ses modèles ont produit une preuve de sa résolution, OpenAI n’a contacté un expert que pour « discuter de la mise en place d’une collaboration autour de ce résultat », pas pour être conseillée sur la méthode de publication. Cet expert lui aurait recommandé de rendre publique sa production, comme avec les 722 « prépublications ».

OpenAI affirme que ses modèles ont « établi une preuve de la conjecture de lissage local dans toutes les dimensions et ont ainsi également résolu la conjecture de Kakeya et la conjecture de restriction de Stein dans toutes les dimensions ». En juillet dernier, la mathématicienne Hong Wang venait de se voir attribuer la médaille Fields notamment pour cette conjecture de Kakeya en dimension trois, comme l’expliquait le Journal du CNRS.

En informatique théorique et physique, des collaborations initiées avec certains chercheurs

En informatique, les travaux générés par OpenAI concernent une hypothèse de difficulté calculatoire : l’Exponential Time Hypothesis. L’entreprise soutient que cette hypothèse est « fausse ». Cette fois, un groupe d’experts (Russell Impagliazzo de l’UC San Diego, Ramamohan Paturi de l’UC San Diego et Ryan Williams du MIT) a accepté d’accompagner OpenAI dans la vérification de ces travaux, mis en ligne sur GitHub.

Ces trois chercheurs ont aussi publié une lettre adressée à leur communauté : « Notre implication ne doit pas être interprétée comme une validation de cette affirmation. Un résultat d’une telle importance nécessite un examen minutieux et indépendant, ainsi qu’une compréhension que d’autres puissent reproduire, remettre en question et développer ».

Sur la publication de ces travaux, OpenAI est cependant accusée – une nouvelle fois – de mauvaises pratiques scientifiques en s’appuyant sur des travaux d’autres chercheurs sans les citer et en les prenant de vitesse sans réellement maitriser ce qu’elle fait.

Le mathématicien Levent Alpöge, qui travaille pour Anthropic et qui avait déjà pointé ce genre de problèmes concernant OpenAI et les maths, a expliqué sur X que son confrère Ethan Sussman de l’université Northwestern avait beaucoup avancé sur le sujet et partagé ses résultats avec la communauté. « Je n’ai cessé de lui répéter de ne pas se montrer trop déférent et modeste, car on lui volerait la vedette à la première occasion. Au lieu de le contacter pour collaborer avec lui, comme cela a été suggéré publiquement à maintes reprises, les responsables d’OpenAI ont choisi de procéder ainsi », explique-t-il. Anthropic a depuis mis en ligne les travaux sur le sujet générés avec ses modèles.

Enfin, du côté de la physique, les documents générés n’ont pas été rendus publics. L’entreprise affirme, par contre, que ce serait « une démonstration mathématiquement rigoureuse de l’existence de certaines théories quantiques des champs en interaction, comprenant des champs de jauge et des fermions en quatre dimensions, notamment la chromodynamique quantique (QCD) et une formulation unifiée du Modèle standard de la physique des particules ». Ici aussi, OpenAI a listé les chercheurs avec lesquels elle allait collaborer : David Gross (prix Nobel 2004), Michael Douglas, Arthur Jaffe, Igor Klebanov et Nikita Nekrasov.

Comme elle le souligne, ces annonces s’ajoutent à sa volonté, ainsi que celle d’Anthropic, de s’afficher comme les futurs financeurs de la recherche mondiale, alors que ces entreprises sont encore loin d’être seulement à l’équilibre.

  •  

Le gouvernement annonce remplacer Parcoursup et un outil d’orientation enrichi par l’IA

France Études ?
Le gouvernement annonce remplacer Parcoursup et un outil d’orientation enrichi par l’IA

Les lycéens se mobilisent depuis des semaines pour demander l’amélioration de leurs conditions d’étude et notamment l’abrogation de la plateforme Parcoursup symbole d’un système de sélection à l’entrée de l’enseignement supérieur. Le gouvernement vient d’en annoncer la modification pour 2027, son remplacement pour 2028 et l’ajout d’un outil d’orientation enrichi par l’IA. Reste à savoir ce qui remplacera la plateforme et le système de sélection qu’elle accompagne.

Depuis plusieurs semaines les lycéens, rejoints par les étudiants et d’autres mouvements, dénoncent un système scolaire à bout. Après l’envoi d’une répression policière violente et la volonté de Matignon de couper les réseaux sociaux « en cas de réitération de violences urbaines », le gouvernement a apporté sa première réponse politique. Celle-ci, sans stopper les appels à la mobilisation, inclut notamment la modification de la fameuse plateforme Parcoursup de préinscription en première année de l’enseignement supérieur. Cette plateforme a été mise en place pendant le premier quinquennat d’Emmanuel Macron, en 2018, avec la loi ORE (relative à l’orientation et à la réussite des étudiants) qui a généralisé la sélection dans l’enseignement supérieur français.

Le mouvement lycéen est parti de Mayotte cet été et s’est étendu à l’Hexagone via les lycées de Créteil et de la banlieue parisienne. Il pointe les emplois du temps surchargés, le manque de moyens et de personnel, des classes surchargées, un manque très concret de tables dans certaines salles, mais aussi le « stress engendré par Parcoursup ».

« Le souci du dématérialisé »

Seydou Ba, élève de terminale au lycée Charles de Gaulle, très en vue dans la mobilisation et militant LFI, pointait sur le plateau de France Info le 9 octobre le problème qu’il voit dans cette plateforme : « C’est le souci du dématérialisé : on se retrouve avec une plateforme face à nous, pas un être humain. Vous vous retrouvez face à Parcoursup et vous ne savez pas quoi faire, pas quoi dire, qui aller voir. »

À la demande de l’abrogation de la plateforme, le gouvernement répond en deux étapes : un aménagement de Parcoursup pour la session 2027 qui va commencer d’ici peu et le « remplacement » de la plateforme prévu pour 2028.

Un remplacement prévu pour 2028, des ajustements avant


Il reste 65% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

La mémoire des chatbots IA crée des autoportraits algorithmiques des utilisateurs

N'aurait-on pas besoin d'un RGPD au carré ?
La mémoire des chatbots IA crée des autoportraits algorithmiques des utilisateurs

Avec la mise en place de « mémoires » pour que leurs systèmes donnent des réponses plus proches de la réalité, les entreprises d’IA génératives ont mis en place ce que des chercheuses et chercheurs appellent des « autoportraits algorithmiques » des utilisatrices et utilisateurs. Ceux-ci incorporent énormément d’informations (notamment psychologiques) considérées comme des données personnelles par le RGPD.

Les chatbots IA sont entrés dans notre quotidien alors qu’ils ne s’appuyaient que sur des modèles de langage, mais OpenAI et ses concurrents y ont ajouté depuis une mémoire qui permet des réponses plus adaptées et hyperpersonnalisées. Des chercheuses et chercheurs ont montré que cette mémoire posait de nouvelles questions concernant les données personnelles. Cela touche notamment des informations d’ordre psychologique.

C’est une équipe notamment issue du Max Planck Institute for Software Systems qui a travaillé sur cette question. Le chercheur Abhisek Dash et ses collègues ont présenté leurs travaux titrés « The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT » lors d’une conférence scientifique de l’Association for Computing Machinery à Dubaï en avril dernier.

La mémoire est beaucoup plus intrusive que les données récupérées par les autres plateformes

Si, depuis, OpenAI a modifié le fonctionnement de la mémoire de son chatbot, les questions restent pertinentes et les résultats montrent que les entreprises d’IA génératives n’ont pas créé leurs systèmes en y faisant particulièrement attention.

« La mémoire [des chatbots IA] donne naissance à ce que nous appelons l’ « autoportrait algorithmique » – une nouvelle forme de personnalisation issue des informations que les utilisateurs révèlent d’eux-mêmes au cours de conversations privées », expliquent ces chercheurs.

« Si la mémoire permet des échanges plus cohérents, les processus sous-jacents à sa création restent opaques, ce qui soulève des questions cruciales concernant la sensibilité des données, l’autonomie des utilisateurs et la fidélité du portrait qui en résulte », préviennent-ils.

Pour mieux comprendre ces mécanismes, ils ont analysé, en février 2026, 1 058 conversations avec ChatGPT, totalisant 22 971 échanges, dont 2 050 requêtes ont déclenché des mises à jour de la mémoire.

Ils notent déjà que la plupart de ces mises à jour ne sont pas enclenchées par l’utilisateur. Ainsi, « seuls 4 % des souvenirs de notre ensemble de données analysé sont initiés par les participants, tandis que les 96 % restants sont déclenchés unilatéralement par ChatGPT ». « Une telle asymétrie flagrante dans les schémas de mise à jour des souvenirs témoigne d’une capacité d’action supérieure du système d’IA dans la construction de la mémoire conversationnelle, par opposition à un contrôle exercé par l’utilisateur », commentent-ils.

En analysant ces « souvenirs » gardés en mémoire par ChatGPT, les chercheurs ont remarqué que 28 % d’entre eux contiennent des données personnelles comme définies par le RGPD et 7 % appartenant à des catégories particulières de données à caractère personnel. Pour 91 % des utilisateurs, cette mémoire avait recueilli des données personnelles et pour plus de la moitié (54 %) des données sensibles.

Concernant les données psychologiques des utilisateurs, les chercheurs font remarquer une différence entre les plateformes numériques traditionnelles et les chatbots. Ainsi, les premières collectent des données démographiques, le comportement, l’historique des likes et des partages, les commentaires ou encore les interactions pour en déduire les centres d’intérêt des utilisateurs.

« À l’inverse, les systèmes d’IA conversationnelle tels que ChatGPT construisent leur mémoire directement à partir des récits que les utilisateurs leur confient eux-mêmes », remarquent-ils, « ces souvenirs vont souvent au-delà des éléments factuels, reflétant certains aspects de l’univers intérieur de l’utilisateur ».

En mémoire sont aussi intégrés la façon de penser ainsi que les sentiments

Et de fait, ils ajoutent que les « souvenirs » du chatbot concernant ses utilisateurs montrent qu’elle peut « non seulement enregistrer l’identité de l’utilisateur, mais aussi sa façon de penser et ses sentiments ».

Pour analyser ces nouvelles données collectées par les plateformes comme ChatGPT, cette équipe de chercheurs s’est appuyée sur le concept de théorie de l’esprit (Theory of Mind, en anglais, ToM), utilisé en psychologie. Ce concept correspond à la capacité à inférer des états mentaux à autrui, comme des croyances, des désirs, ou des intentions, comme l’expliquent [PDF] les chercheuses et chercheurs en neurosciences et neuropsychologie.

En classifiant avec GPT-4o les « souvenirs » enregistrés par ChatGPT, ils se sont ainsi aperçus, par exemple, que 73 % d’entre eux exprimaient un désir et 16 % une intention. Dans les données qu’ils ont analysées, les « souvenirs » retenus par ChatGPT de 97 % des utilisateurs comprenaient des informations sur leurs désirs, 68 % sur leurs intentions et 52 % sur leurs connaissances.

En utilisant leurs données, les plateformes traditionnelles peuvent répondre à la question « de quel genre de personne s’agit-il ? ». Mais ChatGPT et les services du même genre, avec leur mémoire, pourraient se rapprocher encore plus de la réponse à la question « qui est cette personne ? ».

Abhisek Dash et ses collègues soulignent que cela « soulève de graves préoccupations en matière de sécurité et de vie privée ». Ils expliquent travailler sur un outil appelé « Attribution Shield » qui alerterait les utilisateurs de la présence éventuelle de souvenirs sensibles et leur proposerait des prompts alternatifs pour protéger l’anonymat des personnes concernées tout en préservant leur utilité.

Depuis la publication de leur recherche, OpenAI a modifié la façon dont fonctionne la mémoire de ChatGPT. Depuis juin, celle-ci synthétise les informations collectées petit à petit et les met à jour de façon continue plutôt que de compiler les « souvenirs » de manière individuelle. Et les utilisateurs peuvent accéder à un résumé, mais OpenAI souligne dans sa FAQ sur l’outil que « cela n’inclut pas nécessairement tous les détails ou toutes les sources » auxquels son outil de mémoire peut avoir accès. Il n’en reste pas moins que les informations qui peuvent y être stockées restent les mêmes que celles analysées par les chercheurs dans cette étude.

  •  

PLF 2027 : le budget de l’inclusion numérique risque d’être réduit à peau de chagrin

L'inclusion ? Pourquoi faire ?
PLF 2027 : le budget de l’inclusion numérique risque d’être réduit à peau de chagrin

Dans son projet de loi de finances, le gouvernement de Sébastien Lecornu a prévu de baisser drastiquement le budget que l’État allouait à l’inclusion numérique. Les associations qui accompagnaient notamment les personnes âgées dans la prise en main du numérique sont en danger.

Le projet de loi de finances 2027 présenté par le premier ministre Sébastien Lecornu prévoit de réduire à 3 millions d’euros le budget alloué à l’inclusion numérique. Il était déjà passé d’environ 40 millions d’euros en 2025 à 14 millions d’euros en 2026. Cette baisse signifierait la suppression de quasiment tous les postes de conseillers numériques des diverses associations installées sur le territoire français.

3 000 postes de conseillers menacés

Dans son projet de loi, le gouvernement projette de baisser fortement le budget du Programme 343 intitulé « Plan France Très haut débit ». Celui-ci a été notamment mis en place pour assurer la transition du cuivre vers la fibre optique, mais aussi pour « rapprocher les personnes les plus fragiles vers les nouveaux usages du numérique en portant une politique d’inclusion numérique ». Dans l’annexe de son projet de loi concernant ce programme [PDF], le gouvernement prévoit que le budget consacré à l’inclusion numérique soit fixé à 3 millions d’euros pour 2027.

Cette baisse est particulièrement préoccupante car ces financements permettaient à des associations sur tout le territoire de mettre à disposition des citoyens des conseillers numériques via un dispositif national créé en 2021. Ils peuvent accompagner, par exemple, des personnes âgées pour la prise en main de leurs appareils, mais aussi pour résoudre un besoin administratif immédiat. Rappelons que l’accès aux services publics numériques reste un casse-tête pour une grande partie des Français. Selon les associations comme Avicca ou Les Interconnectés rassemblées dans un groupement appelé La Belle alliance, cela représenterait près de 3 000 postes de conseillers menacés.

L’annexe du projet de loi de finances en question explique sobrement que, « dans un contexte de maîtrise des finances publiques, il a été décidé dès 2025 de réduire progressivement les financements de l’État dans ce dispositif, les conseillers France Service assurant toujours l’accompagnement aux démarches administratives ».

Des propositions «  balayées d’un revers de la main par le ministère de l’Économie »

« Nous alertons les autorités sur ce problème depuis des mois, mais elles ne veulent rien savoir, se désole Luc Derriano, chargé de mission à l’Avicca, une association d’élus engagés dans l’aménagement numérique de leur territoire auprès de Que Choisir. « Toutes les solutions concrètes que nous avons proposées pour maintenir ce financement ont été balayées d’un revers de la main par le ministère de l’Économie. »

La Belle Alliance demandait en septembre dans un communiqué une prise en charge par l’État de 115 millions d’euros par an, l’articulation de l’accompagnement humain que les associations apportent avec les maisons France Services et l’ouverture de concertation d’urgence.

« Les points évoqués avec la ministre rejoignent des discussions déjà tenues depuis des mois, sur lesquelles les associations ont exprimé leur accord, mais il manque la mise en place et les moyens de financement », affirmait Céline Colucci, déléguée générale des Interconnectés, à Acteurs Publics après un rendez-vous avec la ministre du Numérique Anne Le Hénanff mi-septembre.

Côté députés, certains essaient de trouver des moyens pour financer ce dispositif. Ainsi le député socialiste Jacques Oberti a déposé un amendement proposant de relever le tarif de l’imposition forfaitaire sur les entreprises de réseau afin de financer l’inclusion numérique. Mais il a été rejeté par la Commission des finances.

  •  

DNS : Quad9 quitte la France après avoir été condamnée face à BeIN pour défaut de blocage

Jeu, set et match
DNS : Quad9 quitte la France après avoir été condamnée face à BeIN pour défaut de blocage

La fondation suisse qui fournit des services de DNS jette l’éponge en France après avoir été contrainte de bloquer des noms de domaine de sites de streaming sportifs dont BeIN Sports France avait les droits exclusifs.

Les internautes français ne pourront bientôt plus utiliser les serveurs DNS du fournisseur Quad9. En effet, après une décision de justice, l’entreprise suisse a annoncé ne pas pouvoir assurer son service correctement auprès de ses utilisateurs dans le monde tout en s’y conformant à long terme.

Ce n’est pas la première fois qu’un fournisseur de DNS prend une telle décision. En effet, en 2024, OpenDNS s’était résolu à arrêter de proposer ses services en France à cause d’une décision de justice similaire. À l’époque, l’entreprise américaine était en conflit avec Canal+.

Le litige : le blocage de sites de streaming du tournoi de tennis féminin de la WTA

Cette fois-ci, c’est BeIN Sports France qui incite la fondation suisse à suivre. Le 13 mai dernier [PDF], la chaîne de télévision sportive qatarie avait obtenu devant le Tribunal judiciaire de Paris l’ordre donné à Google et à Quad9 de bloquer, sur le territoire français, l’accès via leurs serveurs DNS respectifs à une liste de sites et services IPTV qui permettaient de regarder le tournoi de tennis féminin de la WTA. Cette décision prévoyait un blocage jusqu’à la fin du tournoi, c’est-à-dire jusqu’au 14 novembre prochain, et ce dans un délai de trois jours maximums suivant la signification de la décision.

Mais Quad9 ne s’y est pas plié et a fait appel. Problème, le jugement était revêtu d’une exécution provisoire. BeIN a relancé la procédure en septembre en faisant assigner la fondation suisse devant le même tribunal pour la forcer à appliquer la décision de justice prise en mai. Le jugement rendu ce 21 octobre (dont Quad9 diffuse la décision, PDF) a décidé d’une astreinte de 1 000 euros par jour de retard à compter du prononcé de la décision jusqu’à la fin du tournoi. BeIN Sports demandait « une astreinte de 10 000 euros par jour de retard et par nom de domaine ou sous-domaine demeurant accessible via les services de Quad9 », ce qui, selon la fondation, aurait donné un total de 580 000 € par jour.

Quad9 retire l’accès à ses services en France à partir du 24 novembre

Dans un billet de blog intitulé « Ce n’est qu’un au revoir, la France », Quad9 qualifie de « bonne nouvelle » le fait que le tribunal a « considérablement réduit » la pénalité financière. Elle annonce, cependant, qu’ « à compter du 24 novembre, Quad9 ne sera plus en mesure d’offrir son service gratuit de cyberprotection aux utilisateurs situés en France ». Pour la fondation suisse, la mise en conformité de la décision juridique française « est techniquement irréalisable, et son exécution contredit directement notre mandat d’intérêt public ».

Elle explique sa décision par son refus de mettre en place un dispositif qui altérait les réponses DNS : « Nous ne pouvons pas nous conformer à cette décision sur le long terme tout en restant fidèles à notre mission de protéger votre vie privée, de vous défendre contre les cybermenaces et de préserver l’intégrité d’Internet. Pour nous, la résolution DNS récursive est un service neutre et passif. Nous refusons catégoriquement d’altérer ou de vous mentir sur les réponses DNS que vous recevez contre vos attentes ».

Quad9 précise que son appel est toujours en cours et que « nous continuerons de défendre notre position devant les tribunaux dans cette affaire comme dans toutes celles que nos moyens permettront de mener ».

  •  
❌