❌

Vue lecture

☕️ Vivaldi 8.3 devient plus agressif contre les publicités et les traqueurs


Nouvelle version pour le navigateur alternatif basé sur Chromium et orienté vers les « power users ». L’ajout majeur de cette mouture est l’arrivée d’un nouveau sélecteur pour le niveau de blocage que l’on souhaite contre les publicités et traqueurs.

Jusqu’à présent, les utilisateurs avaient le choix entre trois options : pas de blocage, bloquer les traqueurs, bloquer les traqueurs et les publicités. Désormais, les traqueurs et publicités sont regroupés et le sélecteur propose quatre réglages :

  • Désactivé
  • Léger, qui bloque la plupart des traqueurs et certaines publicités
  • Fort, qui augmente le niveau de blocage, au risque de perturber certains sites
  • Agressif, le niveau maximal de blocage, au risque de « casser » certains sites

Le navigateur laisse cependant la possibilité de définir des niveaux personnalisés en fonction des sites. L’éditeur norvégien pousse d’ailleurs dans ce sens : « Mettez ce DJ-set sur Youtube à fond sans que les publicités ne brisent votre rythme avec le niveau « Agressif  ». Gardez le niveau « Léger » sur votre appli de banque pour que chaque formulaire fonctionne comme prévu. Refusez la protection sur le petit site indépendant en qui vous avez confiance et sur lequel vous tolérez de voir des publicités ». On peut également créer un niveau général de blocage personnalisé, où l’on pourra notamment choisir les listes de blocage.

Vivaldi 8.3 ajoute aussi deux options pour les onglets verticaux. La première permet de déployer la barre d’onglets au survol de la souris, offrant une solution à mi-chemin entre la vue minimaliste (qui n’affiche que les favicons) et la vue classique (qui affiche les noms des pages ouvertes). La seconde regroupe les onglets épinglés pour les afficher en grille, si la colonne est élargie. Dans le cas d’une colonne minimaliste, les favicons s’empilent comme d’habitude. Il s’agit du nouveau comportement par défaut, mais une option permet de le désactiver pour revenir à l’ancien (un site épinglé par liste).

Source : Vivaldi

Parmi les autres améliorations, on trouve en outre une fonction bienvenue : on peut copier une liste de liens et la coller dans la barre d’adresses, Vivaldi ouvrant alors chaque lien dans un onglet dédié. Selon l’éditeur, c’est une solution pratique quand vous recevez par exemple une liste de liens dans un e-mail. La version 8.3 ajoute également une fonction « Copier l’URL sans traqueurs » dans le menu contextuel depuis la barre d’adresses, un mode lecture plus réactif (lancement plus rapide et défilement plus fluide), ainsi que le support de l’API Tab Groups de Chrome pour les extensions

  •  

Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Lumière !
Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Microsoft a publié les préversions de deux nouvelles technologies liées au ray tracing : Clustered Geometry et PTLAS. Elles promettent l’allègement des calculs liés à la lumière dans bon nombre de scénarios, avec des gains parfois significatifs.

Pour comprendre les améliorations proposées, il faut d’abord parler du ray tracing – ou lancer de rayons – pour comprendre le problème.

Ce lancer de rayons simule le trajet de la lumière. Pour chaque pixel, le GPU envoie des rayons et cherche ce qu’ils touchent dans la scène. Cette technique permet de produire des reflets, ombres et éclairages nettement plus réalistes que les méthodes précédentes. Les jeux compatibles avec le ray tracing ont souvent mis en avant cette fonction, dont on sait qu’elle est vorace en puissance de calcul.

La difficulté, en effet, est que la scène contient généralement des millions de triangles, utilisés pour la composition des objets 3D. Tester chaque rayon émis sur chaque triangle en temps réel est impossible.

La carte graphique s’appuie donc sur un résumé de la scène, que l’on nomme « structure d’accélération », dans laquelle les objets sont rangés dans des boites, elles-mêmes rangées dans d’autres boites. Par exemple, une fenêtre appartient à une maison, qui appartient à un quartier, qui appartient à une ville. Ce classement est important, car il permet d’écarter d’un coup tout ce qu’un rayon ne peut pas toucher. Le résumé dispose en outre de deux étages : le bas décrit chaque objet en détail, tandis que le haut décrit la scène complète, donc où se trouve chaque objet.

Où se situe le problème alors ? Dans le mouvement ! Dès que la scène bouge, tout se complique. Un personnage qui marche, un arbre agité par le vent ou autre oblige à recalculer une partie du résumé, parfois à chaque image. Dès qu’une scène devient très détaillée, ce travail de réorganisation peut couter plus cher en calculs que le lancer de rayons lui-même. Pour éviter que les GPU n’arrivent plus à suivre la cadence (donnant des performances exécrables), de nombreux jeux calculent les reflets et autres éléments sur la base d’objets simplifiés.

Ce que Microsoft a présenté

Le 28 octobre, Microsoft a donc lancé deux nouvelles technologies en préversions. L’entreprise présente ces évolutions comme les plus importantes pour DXR (DirectX Raytracing) depuis son lancement en 2018.

La première se nomme Clustered Geometry. Au lieu de construire d’une traite le résumé d’un objet, on le découpe en paquets contenant un maximum de 256 triangles, à la manière de briques de construction. Chacune est préparée une seule fois, puis réutilisée et assemblée selon les besoins. Quand un objet change de niveau de détail (par exemple quand le personnage s’approche), il n’y a pas de reconstruction, le GPU assemblant d’autres briques déjà prêtes. Et pour les objets qui se déforment, comme des personnages animés ? Microsoft prévoit des gabarits, selon le même fonctionnement : la forme des briques est préparée à l’avance, seule leur position étant mise à jour.

La seconde est appelée PTLAS, pour Partitioned Top-Level Acceleration Structures. Pour l’étage haut (donc le descriptif de la scène complète), la scène est découpée en zones. Dans une scène 3D, si une caisse tombe par exemple dans un coin, seule cette zone est mise à jour, le reste étant conservé à l’identique d’une image à l’autre. Les objets qui bougent sans arrêt peuvent être mis à part pour ne pas forcer l’actualisation de toute leur zone.

Dans les deux cas, une autre amélioration est liée : le GPU peut décider de lui-même de ce qu’il faut reconstruire. Un changement de taille, car c’est le CPU qui s’occupe aujourd’hui de préparer une bonne partie de ces opérations. Avec Clustered Geometry et PTLAS, il n’y a presque plus d’allers-retours entre le GPU et le CPU, soulageant d’autant ce dernier.

Précisons quand même que l’idée n’est pas nouvelle : elle vient de NVIDIA. La firme au caméléon propose actuellement ces techniques sous l’appellation RTX Mega Geometry. Gears of War: E-Day est d’ailleurs le premier jeu à l’exploiter. Cependant, sa « standardisation » (en quelque sorte) dans DirectX rend ces techniques utilisables par les autres GPU, ce qui change la donne.

Pour qui ?

L’un des avantages de cette approche est que ces techologies ne réclament aucun nouveau matériel. En théorie, Clustered Geometry et PTLAS sont compatibles avec un très grand nombre de GPU existants.

En résumé, pour l’instant :

  • NVIDIA : toutes les cartes GeForce RTX
  • AMD : les Radeon RX 9000
  • Intel : les Arc série B et certains processeurs Core Ultra récents
  • Qualcomm : les Snapdragon X2 (pilotes attendus au premier semestre 2027)

Techniquement, il suffit que les entreprises concernées mettent à jour leurs pilotes pour profiter de ces améliorations. Chacune devra déterminer quelles cartes seront compatibles. Par exemple, il n’y a aucune information sur le support des Radeon RX 7000, il faudra donc attendre pour en savoir bien.

Bon, et les performances alors ?

Commençons par la mauvaise nouvelle : oui, il est nécessaire que les éditeurs de jeux rendent leurs titres compatibles avec ces techniques pour en profiter. Il n’y a donc aucun jeu prenant en charge Clustered Geometry et PTLAS aujourd’hui, et il faudra attendre que les entreprises concernées s’expriment sur le sujet.

La bonne nouvelle maintenant : le gain peut être significatif, voire… gigantesque. Dans une démonstration de Microsoft sur une Radeon RX 9070, la scène passe de 1,2 à 79 images par seconde, et la mémoire vidéo consacrée au sommaire de la scène tombe d’environ 7,3 Go à 774 Mo.

Cette multiplication des performances par 66 a fait le tour du web ces derniers jours. Et pour cause, on n’a pas souvent l’occasion de voir de tels gains. Mais calmons tout de suite les espoirs, sans les doucher : il s’agit d’un cas extrême, mis en avant par Microsoft pour illustrer le potentiel de ses deux techniques. Ensuite, la comparaison est faite avec le pire scénario possible, c’est-à-dire une reconstruction complète à chaque image. Comme on l’a vu précédemment, les développeurs ont déjà des astuces pour éviter ce type de scénario. Enfin, on n’a rien sans rien : la mémoire de travail nécessaire pendant la reconstruction augmente fortement, mais les autres gains permettent en théorie un bon compromis dans tous les cas.

Microsoft l’indique clairement dans son billet de présentation, il ne faut pas s’attendre à des gains d’une telle ampleur dans tous les jeux. Une démonstration plus réaliste, fournie par NVIDIA, met ainsi en scène des milliers de dominos qui tombent. La mise à jour de la scène passe de 2,88 ms à 0,79 ms par image, alors que le lancer de rayons lui-même devient légèrement plus lent. Le bilan reste positif, mais on est loin d’un facteur 66 (le nombre d’images par seconde passe de 116 à 125).

Même si les gains réels seront plus mesurés et limités aux titres exploitant le ray tracing, une hausse des performances sans changer de matériel est toujours appréciable. Les deux techniques laissent imaginer des mondes ouverts plus denses et plus animés en lancer de rayons, des reflets et des ombres plus fidèles au décor, et une consommation de mémoire vidéo moindre.

Enfin, notez que ces annonces se sont accompagnées d’une autre en parallèle : Advanced Shader Delivery, qui doit réduire les saccades dues à la compilation des shaders en livrant des shaders déjà compilés. La fonction est déjà prise en charge par AMD pour ses Radeon RX 7000 et 9000 dans les derniers pilotes. Chez Intel et NVIDIA, il faudra attendre une nouvelle mouture.

  •  

☕️ Discord travaille sur des clients natifs pour les ordinateurs


Discord travaille à se débarrasser d’Electron pour son client « desktop », à destination de Windows, macOS et Linux. La rumeur courait depuis un moment, mais Stanislav Vishnevskiy en personne, cofondateur et directeur technique de l’entreprise, l’a confirmé sur X.

Son message s’accompagne d’ailleurs d’une capture, montrant le processus « Discord Phoenix » (nom de code de cette future mouture) et sa consommation de 290 Mo de mémoire vive. On remarque d’autres éléments, dont probablement un clin d’œil à Steam et ses 856 Mo consommés, l’application de Valve utilisant des technologies web.

Ce changement est attendu de pied ferme, car Discord peut consommer jusqu’à plusieurs Go de mémoire. Nous l’évoquions fin septembre, quand l’arrivée d’un mode jeu avait été révélée par le compte Discord Previews. La différence pourrait donc s’avérer énorme, libérant une grande quantité de RAM au profit des jeux, Discord étant souvent associé aux plaisirs vidéoludiques.

Dans son message, Stanislav Vishnevskiy indique que la nouvelle application sera intégralement en Rust, langage que l’entreprise utilise déjà pour différents composants. L’interface sera bâtie avec GPUI, un framework accéléré matériellement par le GPU pour Rust. Dans des réponses données sous son tweet d’origine, on apprend également que l’application aura exactement la même apparence qu’aujourd’hui, que le support de Linux devrait en être amélioré et qu’une version web continuera d’exister, Discord abandonnant l’actuel JavaScript pour du WebAssembly (Wasm).

Enfin, Stanislav Vishnevskiy espère que cette nouvelle version sera « bientôt » proposée en test aux utilisateurs. Le responsable n’en parle pas, mais il s’agira probablement du canal Canary de l’application.

  •  

Microsoft veut décidément convaincre sur les performances de Windows 11

Ram, ram, rameurs ramez...
Microsoft veut décidément convaincre sur les performances de Windows 11

Microsoft l’assure encore : Windows 11 consomme moins de mémoire vive. Ce serait surtout le cas pour les machines dotées de 8 Go de RAM, dans un contexte toujours plus tendu de pénurie et d’explosion des prix. Bien que la communication ait une visée marketing, l’entreprise assure que les efforts se poursuivent.

2026 doit marquer un tournant dans l’histoire de Windows 11. Microsoft communique abondamment depuis le début de l’année sur un effort général et profond autour de son système, afin de répondre aux critiques. L’éditeur aura pris le temps de la réflexion, depuis la commercialisation de son produit en octobre 2021.

Comme le rappelle notamment Windows Central, la sortie du MacBook Neo et de ses 8 Go de mémoire a mis en lumière les défaillances de Windows dans ce domaine. Le système est accusé d’être lent, peu réactif, un ogre vorace en mémoire aux interfaces bâties sur des technologies web et pénible à utiliser. Avec les tensions croissantes sur la mémoire vive et la NAND (dans les SSD), et probablement sous pression des constructeurs qui aimeraient lancer des configurations plus chichement équipées, Microsoft devait réagir. D’autant que Windows 11 demande officiellement 4 Go de mémoire pour fonctionner.

Trois axes d’amélioration

Dans son billet du 3 novembre, Microsoft commence par indiquer qu’une mémoire pleine n’est pas en soi un problème : les données et applications se tiennent prêtes dans un certain contexte, qui peut évoluer à mesure que les besoins changent au cours de la session. « Le vrai test est de savoir si votre PC reste réactif, pas de la quantité de mémoire inutilisée », affirme l’entreprise.

Trois leviers sont quand même mentionnés pour les améliorations de ce mécanisme. La compression des données d’abord, pour réduire la taille des informations moins utilisées. La fonction existe depuis des années, mais elle a été retravaillée pour les configurations à 8 Go, a priori pour être plus agressive. En conséquence, Windows 11 peut garder jusqu’à 2 Go de données actives supplémentaires en mémoire, réduisant les chances qu’un onglet ou une application ait besoin d’être complètement rechargé.

Microsoft indique ensuite avoir donné la priorité aux interactions, surtout les principales comme le menu Démarrer, le clic droit, la recherche, les paramètres, l’Explorateur ou encore l’outil Capture d’écran. Autant de composants qui répondraient jusqu’à 20 % plus vite, sans que Microsoft ne détaille sa méthode de calcul. Le système sait mieux suspendre certaines activités quand la machine est sollicitée par l’utilisateur, par exemple l’indexation.

Un mécanisme de lancement accéléré a également été mis en place, dont Edge est la première application à profiter. Le gain de temps peut grimper jusqu’à 33 %, mais il est de 15 % en moyenne. Microsoft ajoute que ce mécanisme est ouvert aux applications tierces. À propos d’Edge, le navigateur met désormais en veille les onglets après 15 min par défaut, contre 2 heures jusqu’à présent.

Enfin, Microsoft travaille sur les applications courantes. Dans des scénarios multitâches impliquant Windows, Edge et la suite Office, les gains observés grimpaient jusqu’à 900 Mo, dont jusqu’à 360 Mo pour Office. L’éditeur explique que les améliorations viennent aussi bien de la manière dont la mémoire est gérée et de comment elle est utilisée par les applications, mais sans donner plus de détails.

Les éditeurs tiers doivent eux aussi profiter de ces améliorations, en théorie. Microsoft cite l’exemple du client WhatsApp pour Windows, qui aurait constaté un gain à deux chiffres, là encore sans plus de précision. Drôle de choix d’ailleurs, car cette application est probablement l’une des pires en matière d’efficacité : WhatsApp a mis fin à son application native et a basculé sur des technologies web, avec une consommation oscillant entre 1 et 3 Go de mémoire. À moins de besoins spécifiques, la version web du service fera largement l’affaire.

La route sera longue

La fin du billet mentionne plusieurs autres améliorations en préparation. Par exemple, une compression des données en mémoire « encore plus intelligente et efficace ». Plus intéressant, il y a un travail en cours pour qu’un plus grand nombre de fonctions et d’applications partagent des éléments communs, avec moins de chargements en mémoire à la clé. La recherche et les widgets devraient ainsi partager un seul moteur web. Idem pour OneDrive et Photos, même si on ignore s’il s’agit là encore d’un moteur web ou d’autres composants.

D’autres chantiers sont en cours, dont la progression du framework natif WinUI 3 pour un nombre croissant d’applications. Microsoft dit également être en discussion avec les fabricants de PC et de puces pour « optimiser » la quantité de mémoire que le matériel réclame pour fonctionner. L’éditeur affirme enfin travailler avec des développeurs tiers pour « aider leurs apps à utiliser plus efficacement la mémoire ».

Toutes ces informations manquent cependant de précision. Les notes en bas de page montrent que les gains observés sont souvent basés sur un faible nombre de machines et dans des cas favorables. Il ne semble pas y avoir pour l’instant de tests indépendants. Si le mouvement de fond va dans le bon sens, il est donc difficile de savoir aujourd’hui dans quelle mesure ces améliorations sont efficaces.

Ce billet comporte en outre une dimension marketing très claire. D’une part, il se termine justement par des offres sur des PC peu onéreux, comme une offre à 429 dollars chez Walmart. D’autre part, il est évident que Microsoft travaille au successeur de Windows 11. Le système ayant agacé par de nombreux aspects depuis sa sortie, l’éditeur doit redorer son image avant d’avoir un nouveau produit à vendre.

Ce point est loin d’être anodin. La fin précipitée de Windows 10 (même si l’Europe a un traitement de « faveur »), le passage forcé à Windows 11, l’expérience utilisateur moyenne, la montée en puissance de Linux ou encore l’agacement engendré par la prolifération des outils IA sont autant de facteurs à prendre en compte. Si « Windows 12 » n’est pas suffisamment attirant, la question d’une bascule vers un autre environnement se posera d’autant. Microsoft a donc tout intérêt à continuer le travail sur ce que l’on attend d’un système d’exploitation : performances, fiabilité et sécurité.

  •  

Mode sombre adaptatif, onglets verticaux, Siri AI : Apple sort Safari de sa torpeur

Dans la jungle, terrible jungle
Mode sombre adaptatif, onglets verticaux, Siri AI : Apple sort Safari de sa torpeur

Avec les prochaines versions d’iOS et de macOS, Safari s’offrira plusieurs nouvelles fonctions importantes : les onglets verticaux, un mode sombre adaptatif qui va mettre à la retraite plusieurs extensions, et une nouvelle dose de Siri AI.

Là où les éditeurs de navigateurs web empilent les nouvelles fonctions et les modifications à toute vitesse, Apple a toujours conservé un train de sénateur pour Safari. La position privilégiée que le logiciel occupe dans les systèmes d’exploitation du constructeur lui permet de vivre une petite vie assez tranquille, loin de la frénésie de la concurrence.

Mais il arrive aussi parfois, au détour d’une mise à jour discrète, qu’Apple décide de faire soudainement un petit effort. La version 27.3 contient non pas une, pas deux mais trois nouveautés importantes ! Pour en profiter, il faudra au préalable télécharger et installer iOS 27.3, iPadOS 27.3 et macOS 27.3 . Oui, chez Apple, pour pouvoir utiliser une poignée de nouveautés dans un navigateur, il faut impérativement lancer les grandes manœuvres sur ses machines et les mettre à jour.

Ces nouvelles versions des systèmes d’exploitation sont actuellement proposées en bêta pour les développeurs. Sur Mac, avec un peu de chance, le constructeur livrera peut-être une version autonome de Safari 27.3 quand la mouture finale de macOS 27.3 sera disponible.

Un mode sombre pour les sites qui n’en ont pas

La première nouveauté est un mode sombre adaptatif, qui bascule la page web en mode sombre lorsque l’affichage du smartphone, de la tablette ou de l’ordinateur est lui-même en mode sombre. Bien sûr, les feuilles de styles des sites web peuvent adapter les couleurs de leurs pages en fonction du mode de la machine.

Mais ce n’est pas le cas de tous : en se basant sur des stats de Google, Apple relève que près de 40 % des pages sont chargées par des internautes ayant activé le mode sombre, mais seuls 10 % des chargements concernent des pages qui le prennent en charge.

Lorsque Safari 27.3 affiche un site web incompatible avec le monde sombre, il affiche en haut de page une invitation à activer le mode adaptatif. Attention, des éléments peuvent alors manquer de contraste, les couleurs peuvent paraître « différentes », et certains sites ne sont pas compatibles.

Apple explique que ce mode inverse la luminosité des couleurs tout en préservant leurs teintes : les fonds clairs deviennent sombres, et les textes foncés s’éclaircissent, avec un contraste d’au moins 4,5:1 pour assurer la meilleure lisibilité possible. Les dégradés clairs sont eux aussi assombris ; la plupart des images restent intactes, mais certaines icônes et logos au format SVG sont adaptés pour rester visibles.

Il n’existe pas d’option dans les réglages de Safari pour activer ou désactiver automatiquement cette nouveauté, il faut se rendre sur un site incompatible avec le mode sombre pour voir la notification. Cela pourra changer dans les prochaines versions.

Cette nouveauté risque de porter un coup fatal à plusieurs extensions qui se chargeaient déjà de la bascule forcée au mode sombre pour les sites web récalcitrants (comme Noir, par exemple).

Les onglets prennent la verticale

Deuxième grosse nouveauté de Safari 27.3 : les onglets verticaux. Sur Mac, iPad et sur l’écran interne de l’iPhone Duo (l’iPhone tout court n’y a pas droit), ces onglets se présentent sous la forme de leurs favicons dans un panneau à droite. Il est possible d’agrandir ce panneau pour révéler les noms des pages web. Les onglets peuvent être déplacés à la main, et supprimés.

Sur Mac, l’activation passe par le menu Présentation > Tab Layout > Vertical. Sur iOS et iPadOS, il faut se rendre dans les réglages de Safari et sélectionner la nouvelle option « Barre d’onglets verticale ».

Siri AI aux commandes

Apple ne pouvait décemment pas passer à côté de l’occasion d’intégrer un peu plus profondément Siri AI dans Safari. La version 27.3 du navigateur permet à l’assistant de gérer les onglets. Siri AI est par exemple capable de montrer tous les onglets (ou uniquement les onglets d’un site web) de fermer un onglet, d’afficher l’onglet qui parle d’un sujet spécifique, de dupliquer ou de fermer un onglet, ou encore d’organiser les onglets (par exemple « place les onglets de Next en premier »).

Siri AI est également en mesure d’effacer les données des sites et de l’historique, d’épingler des articles dans la liste de lecture (et d’afficher cette même liste). Cela fonctionne plutôt bien dans nos tests, et l’assistant demande régulièrement de confirmer une action. Mais malheureusement tout cela reste cantonné au Mac dans l’Union européenne. Siri AI n’est toujours pas disponible sur iPhone ou iPad dans l’UE.

  •  

Revolut vire Claude Code pour une IA chinoise et divise ses coûts par dix

La fintech britannique Revolut affirme avoir réduit d'environ 90 % sa facture d'IA de codage en moins d'un an, en remplaçant les outils commerciaux comme Claude Code, l'assistant de programmation d'Anthropic, par un modèle chinois hébergé sur ses propres serveurs.

David Abitbol, qui dirige l'infrastructure de la banque en ligne, a raconté la bascule lors d'une conférence à New York. Ses 2 000 ingénieurs sont passés de Gemini début 2025 à Claude Code début 2026, avant d'adopter GLM, un modèle ouvert développé par le chinois Z.ai et utilisé aujourd'hui en version 5.3.

Le calcul est vite fait. Auto-hébergé, GLM revient à 0,30 dollar le million de tokens, ces unités de texte que les fournisseurs d'IA facturent à la consommation, soit à peu près dix fois moins que Claude Code ou que Codex, son équivalent chez OpenAI. Certains développeurs coûtaient jusqu'à 10 000 dollars par mois, pour un retour jugé décevant en interne.

Le tout tourne sur 56 cartes graphiques Nvidia B200 installées chez Revolut. Plutôt que d'empiler les cartes, les équipes ont surtout gratté de la performance avec des réglages fins, comme la compression du modèle ou la séparation des différentes phases de calcul.

Côté performances, la première réponse tombe en moins de 3 secondes et le système sort environ 200 tokens par seconde, et même 800 le soir quand les bureaux se vident. Au-delà de 5 secondes d'attente, les plaintes pleuvent en interne.

La vraie surprise est ailleurs en fait. Les plus gros gains ne viennent pas de l'écriture de code mais du débogage et du traitement des tickets Jira et Confluence, ces outils de suivi de projet que tout le monde adore détester. Le temps de codage se serait quand même amélioré de 60 %.

Et puis il y a l'effet psychologique. Avec des tokens illimités en interne, les ingénieurs ne rationnent plus leurs requêtes pour tenir le budget du trimestre, et la facture ne réserve plus de mauvaise surprise en fin de mois. Les modèles commerciaux restent accessibles pour les cas particuliers, les tâches visuelles partent par exemple chez Gemini.

Un modèle chinois au coeur d'une banque, la question fâche forcément. Abitbol balaie. Hébergés en local ou sur un cloud régional, les poids du modèle ne font selon lui courir aucun risque, le danger serait plutôt de passer par des API hébergées on ne sait où.

Les fenêtres d'un million de tokens que vendent les gros acteurs du secteur sont à ses yeux "une arnaque", 256 000 suffisent largement à coder. Tout le marché vend exactement l'inverse depuis deux ans.

Source : Theregister

  •  

Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Le comite n'a pas contracté
Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Pour la première fois de son histoire, le langage C++ a échoué à réunir assez de votes au sein de l’ISO pour une nouvelle version. Le C++ 26 n’a pas été ratifié, faute d’un accord sur plusieurs points, dont le principal est le concept de contrat. Explications.

Le 23 octobre avait lieu le vote des organismes nationaux sur le projet de norme internationale (DIS). Le lendemain, Robert Seacord, qui dirige le comité du langage C à l’ISO, annonçait sur LinkedIn que le texte avait été désapprouvé, y évoquant un « jour triste pour la communauté C++ ».

Une première pour le C++

Pour être adopté, un projet doit réunir deux conditions. Il lui faut non seulement les deux tiers des voix des membres participants, mais les votes négatifs ne doivent pas non plus dépasser le quart des votants. Or, C++ 26 n’a obtenu que 12 voix sur 20, soit 60 %, alors que 14 étaient nécessaires. En outre, les votes négatifs ont atteint 9 sur 22, soit 41 %. Le projet C++ 26 a donc échoué sur les deux tableaux.

Selon Mateusz Pusz, membre du comité national polonais qui a consulté le résultat officiel, neuf pays ont voté contre : Danemark, Finlande, Iran, Italie, Japon, Luxembourg, Roumanie, Espagne et Suède. La France et l’Irlande se sont abstenues tout en adressant des commentaires techniques. La Pologne et les États-Unis se sont abstenus sans commentaires.

C’est la première fois qu’une nouvelle version du langage n’est pas normalisée par l’ISO. Pour Robert Seacord, aucune norme de langage n’avait jamais échoué à ce stade. Selon Daveed Vandevoorde, membre du groupe de direction du comité C++, c’est même encore plus significatif : aucun projet antérieur n’avait reçu un seul vote contre.

Au cœur des débats, les contrats

Le C++ 26 dresse une longue liste de nouveautés, parmi lesquelles les contrats. En développement, un contrat inscrit dans la déclaration d’une fonction ce qu’elle exige de son appelant et ce qu’elle garantit en retour. Il s’agit respectivement de la précondition et de la postcondition. Par exemple, une fonction de racine carrée peut exiger un nombre positif et promettre un résultat tout aussi positif.

Cette idée n’est pas nouvelle, comme l’indique le site Les Joies du Code. Le principe a été popularisé dans les années 1980 par l’informaticien français Bertrand Meyer avec son langage Eiffel. D’autres langages plus modernes, comme Ada et D, l’intègrent également. Le contrat figure dans la déclaration, à la vue de tous (aussi bien les appelants que le compilateur et les outils d’analyse). Pour ses défenseurs, il sert même de documentation qui ne peut pas devenir obsolète en silence.

Pour donner une idée de l’âge du sujet, le comité C++ travaille dessus de manière concertée depuis 2004, et une première version avait été proposée pour C++ 20, avant d’être supprimée en 2019. La version actuelle, présente dans la proposition de C++ 26 récemment refusée, avait pourtant reçu l’aval d’un sous-comité technique en février 2025, par 100 voix contre 14.

Alors que s’est-il passé ? En fait, si l’idée fait globalement consensus, sa conception divise. Dans C++ 26, le code source ne décide pas si un contrat est vérifié. Le texte définit quatre comportements possibles : ignorer la vérification, l’effectuer en signalant l’erreur sans s’arrêter, l’effectuer et arrêter le programme, ou l’arrêter immédiatement sans traitement intermédiaire.

Problème, le choix revient à l’implémentation, autrement dit à une option de compilation. Ainsi, une même règle écrite par le développeur peut donc être appliquée strictement, simplement signalée ou ignorée selon la manière dont le programme est construit. Dans son billet, Mateusz Pusz avait résumé ainsi la problématique : une assertion de contrat est-elle une vérification que la compilation peut supprimer, ou une garantie sur laquelle le programme peut compter ?

Deux camps irréconciliables

Sans surprise, les opposants reprochent la possibilité de désactiver les vérifications. Selon eux, cela revient à la pratique déjà connue de tester du code avec des contrôles puis à les supprimer en production. Ils préfèrent que ces vérifications soient toujours actives, ce qui aurait un coût estimé par Google à 0,3 %.

Ils lui reprochent également son inachèvement, car les contrats sur les fonctions virtuelles ont été repoussés à C++ 29. Dans ce camp, on retrouve notamment Bjarne Stroustrup, le propre créateur du C++. Il exprime son rejet des contrats sous cette forme depuis des années, comme l’indiquait The Register en mars dernier.

Pour les défenseurs en revanche, toutes ces critiques ont déjà reçu des réponses. Ils craignent également que le retrait ne repousse encore les contrats de plusieurs années. L’historique va d’ailleurs dans ce sens : après le retrait de C++ 20, il avait fallu six ans pour les remettre sur la table, dans une version plus modeste. En outre, ils reprochent à certains opposants d’avoir plaidé leur cause directement auprès des pays pendant le vote.

Et maintenant ?

D’abord, précisons qu’il y a peu de conséquences immédiates pour les développeurs. La situation est similaire avec les normes Wi-Fi : les compilateurs n’attendent pas la publication d’une norme pour implémenter un projet en cours de travail. Le vote ne modifie pas non plus ce qu’ils proposent déjà. Par exemple, la version 16 de GCC (sortie en avril) prend en charge les contrats à titre expérimental (avec l’option -std=c++ 26). Clang ne les intègre pas encore en revanche.

Quelle suite à présent ? Le comité WG21, le groupe de travail de l’ISO chargé du langage C++, doit se réunir à Búzios, au Brésil, du 16 au 21 novembre 2026. Il devra répondre à chacun des commentaires nationaux (que l’on ne peut pas consulter) et recommander une marche à suivre.

De là, il peut y avoir quatre possibilités : un projet révisé soumis à un nouveau vote de huit semaines, un nouveau projet de comité soumis à commentaires, une publication comme spécification technique, ou l’abandon pur et simple. Le président du SC22, sous-comité de l’ISO chargé des langages de programmation, devra choisir parmi les trois premières. Pour un abandon, il faut en revanche que tout le SC22 vote.

Pour l’instant, les camps sont divisés. Certains militent pour un nouveau vote sur le texte inchangé, d’autres pour retirer la seule fonction contestée afin que le reste passe. D’ici à ce que le problème soit tranché, il est probable que la date du vote glisse en 2027. La future norme pourrait alors changer de nom pour C++ 27.

  •  

[MàJ] Fedora 45 est disponible en version finale

Chapeau la distrib'
[MàJ] Fedora 45 est disponible en version finale

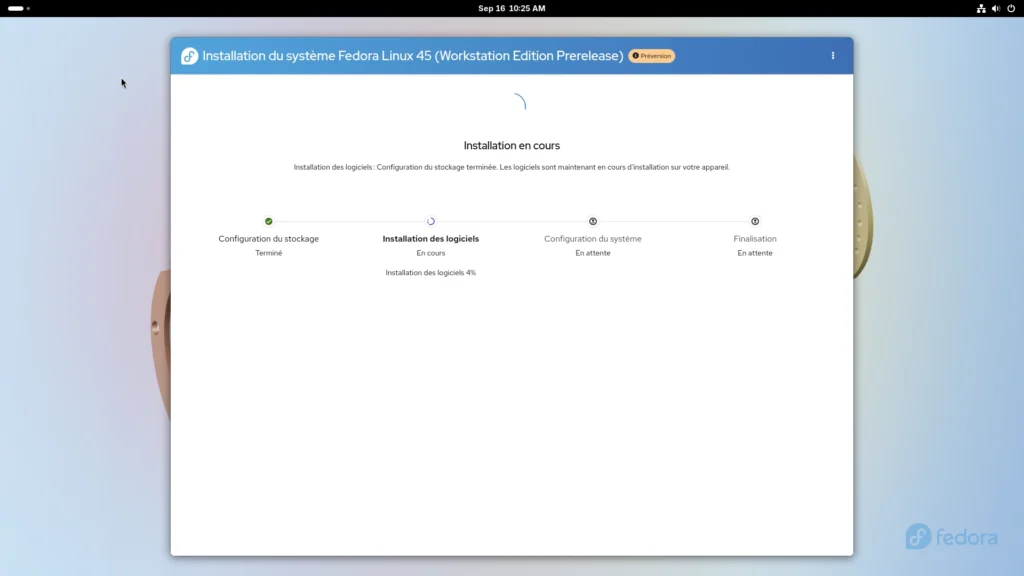
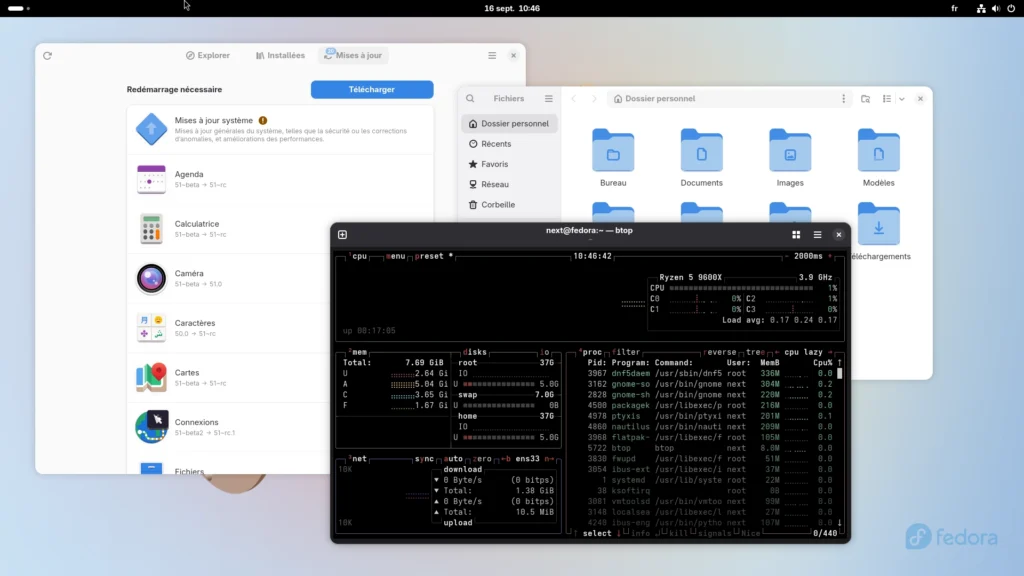
Fedora 45 est maintenant téléchargeable en version finale. Les nouveautés sont assez nombreuses, notamment sur la sécurité et les paquets reproductibles.

Mise à jour du 4 novembre

La version finale est désormais disponible au téléchargement. On peut récupérer les images ISO depuis le site officiel.


Article original du 16 septembre

Fedora est le laboratoire à ciel ouvert de Red Hat. La distribution est connue pour être pionnière dans ses choix technologiques, comme le choix du serveur d’affichage Wayland par défaut dès la version 25, longtemps avant les autres distributions (et les bugs de jeunesse qui allaient avec).

Comme Ubuntu, Fedora dispose d’un rythme biannuel, au printemps et à l’automne. La nouvelle mouture 45 est ainsi prévue pour le 20 octobre, ou le 27 en cas de problème. Maintenant que la bêta est disponible, on peut observer ses nouveautés, parmi lesquelles une hausse manifeste du niveau de sécurité.

Toutes les variantes du système peuvent être téléchargées (images ISO) depuis le site officiel. Sur la page de téléchargement, il faut penser à activer le sélecteur d’affichage pour la bêta. Depuis l’annonce officielle, les différents liens pointent tous directement vers les versions 45.

Composants de base

La bêta de Fedora 45 est livrée avec le noyau Linux 7.2, la dernière révision stable (sortie le 16 aout). Parmi les nouveautés de ce dernier, le Cache Aware Scheduling permet à l’équilibrage de charge de tenir compte du cache de dernier niveau au sein des processeurs. Phoronix, connu pour ses tests de performances, indiquait en outre que le noyau 7.2 introduisait des gains mesurables de performances pour les processeurs AMD et Intel. Entre autres nouveautés, on trouve une première prise en charge du HDMI 2.1 FRL dans le pilote AMDGPU, le support du protocole USB4STREAM d’Intel ou diverses prises en charge dans KVM de fonctions de sécurité propres à AMD et Intel.

Comme toujours avec Fedora, la version proposée par défaut pour les PC, Workstation, est fournie avec GNOME, qui passe pour l’occasion en version 51. Cette mouture n’est pas finalisée, même si les composants en bêta sont remplacés par leurs équivalents RC (Release Candidate) après l’installation de Fedora 45. GNOME 51 inaugure des curseurs au format SVG (déjà présents dans KDE), une nouvelle interface de gestion des empreintes digitales, le support de la connexion distante multi-utilisateurs via Kerberos, de nouveaux réglages pour le pavé tactile, de meilleures performances pour Agenda ou encore le nettoyage du code auparavant lié aux anciens pilotes NVIDIA. Pour les personnes n’appréciant pas GNOME, KDE Plasma 6.7 est disponible dans une version dédiée.

Côté développement, la chaîne GNU passe à GCC 16.2, binutils 2.47, glibc 2.44 et gdb 17.2. S’y ajoutent LLVM 23 pour l’ensemble des sous-projets, Go 1.27, Python 3.15, Perl 5.44 et Lua 5.5. Dans les notes de version de la distribution, on peut lire que plusieurs changements cassent la compatibilité. Par exemple, Setuptools 82 supprime le module pkg_resources. Pandas passe de la 2.3 à la 3.0, avec une gestion des chaînes revue, un comportement copie-sur-écriture cohérent et la suppression de fonctionnalités dépréciées depuis longtemps. Même chose avec libxml2, dont le passage de la 2.13.9 à la 2.15.3 s’est accompagné d’un changement d’ABI, imposant une recompilation de masse avec dépréciation des liaisons Python.

Parmi les autres changements, Podman 6 est une des mises à jour les plus lourdes de conséquences. Elle « inclut des changements importants de rupture de l’API et de la ligne de commande, de nouvelles fonctionnalités, ainsi que la suppression finale de composants obsolètes tels que slirp4netns, cgroups v1 et le backend BoltDB », prévient Fedora. Citons également le passage de MySQL de la version 8.4 à 9.7, et celui de MariaDB de la version 11.8 à la 12.3. NetworkManager prend en charge par défaut les réseaux « IPv6-mostly ».

Sécurité : plusieurs serrages de vis

Plusieurs changements importants sont présents dans Fedora 45. D’abord, l’équipe indique avoir franchi la barre des 90 % de paquets reproductibles.

Pour comprendre l’intérêt, rappelons qu’un paquet est dit « reproductible » si, à partir du même code source, du même environnement de compilation et des mêmes instructions, n’importe qui peut régénérer une copie identique bit à bit du paquet publié. En clair, il s’agit d’un gage de sécurité de la chaine d’approvisionnement : c’est la garantie que le binaire téléchargé correspond bien au code source publié. Dans le cas de Fedora, toute non-reproductibilité détectée est considérée comme un bug et est traitée comme telle, via un rapport. La distribution n’est pas la seule à progresser dans ce domaine, d’autres comme Arch Linux ou NixOS font de même.

On reste dans le sujet avec la vérification désormais obligatoire des signatures par le gestionnaire de paquets RPM. Un mode de vérification stricte, conformément au comportement en amont introduit par la version 6.0, comme nous l’indiquions il y a un an. Ainsi, seuls les paquets dont la signature est vérifiée peuvent être installés, sauf dérogation explicite avec --nosignature ou l’API correspondante. Les RPM compilés localement et non signés sont directement concernés. Côté Fedora, ce changement se fait dans la foulée du passage à RPM 6.1.

Fedora 45 restreint également ptrace par réglage global dans le noyau qui retire par défaut certaines permissions de débogage aux utilisateurs non privilégiés. L’objectif est d’empêcher un logiciel malveillant d’inspecter les autres processus du même utilisateur. En revanche, si des outils de débogage sont installés, un fichier sysctl rétablit le comportement classique de Fedora 44 et des versions précédentes.

Autre changement significatif, le changement de fournisseur par défaut du service Secret. On passe ainsi de KWallet et GNOME Keyring à oo7. Écrit en Rust, il implémente la même interface D-Bus org.freedesktop.secrets, et se veut une alternative légère utilisable sur tous les environnements. Il est développé dans le cadre du projet linux-credentials et sert déjà de service de secrets natif pour COSMIC Desktop. D’après la fiche Fedora, oo7 doit permettre un modèle d’autorisation limitée par application ou par service, ouvrir la voie à l’authentification FIDO2 et mieux encadrer l’accès des applications isolées aux secrets.

On trouve d’autres modifications liées à la sécurité, comme l’interdiction par DNF5 de changer de fournisseur par défaut. Un changement important, car à moins d’une manipulation spécifique, un paquet installé ne peut donc plus être remplacé automatiquement par celui d’un autre fournisseur. Signalons aussi que chpasswd et newusers passent désormais par PAM et appliquent donc les politiques de mots de passe du système.

  •  

Le créateur de Rocky Linux a créé un noyau compatible Linux en 11 jours avec l’IA

Du code « jetable »
Le créateur de Rocky Linux a créé un noyau compatible Linux en 11 jours avec l’IA

Gregory Kurtzer, créateur de CentOS et Rocky Linux, a créé un noyau compatible Linux, nommé Ginux. Loin d’être une proposition concrète, le projet était surtout une expérience : était-il possible de proposer un noyau compatible principalement développé par IA ?

L’expérience fait parler d’elle depuis plusieurs jours. Gregory Kurtzer est loin d’être un inconnu, il est connu pour avoir créé CentOS, une distribution Linux 100 % compatible avec Red Hat Enterprise Linux (RHEL), dont elle est une reconstruction. Apparue en 2003, CentOS attire l’attention, jusqu’à ce que Red Hat commence à sponsoriser la distribution en 2014. Dans les années suivantes, Red Hat embauche progressivement les développeurs travaillant sur CentOS, jusqu’à récupérer la gestion du projet.

Décembre 2020, patatras : Red Hat met fin à CentOS et pousse Stream, sa variante conçue pour intégrer les nouveautés. Le positionnement est alors clair : Fedora pour son aspect laboratoire, CentOS Stream pour intégrer les nouveautés en vue d’une utilisation professionnelle, RHEL pour l’offre commerciale. Gregory Kurtzer, frustré par le nouveau positionnement de Red Hat, crée alors Rocky Linux, à nouveau une reconstruction de RHEL, avec la même compatibilité complète.

Alors quand le développeur annonce avoir créé un noyau compatible Linux, développé avec l’IA, le sujet attire l’attention. Mais pas toujours pour les « bonnes » raisons.

Un noyau compatible, pas un fork

Le projet Ginux est surtout une expérience. Il la présente sur X le 27 octobre comme « un nouveau noyau de système d’exploitation compatible avec Linux qui démarre Rocky Linux 10 avec systemd, le tout en utilisant l’ingénierie agentique dirigée par l’humain (HDAE) ».

Le noyau est conçu pour l’architecture x86-64 et est indépendant. Il ne s’agit pas d’un fork du noyau actuel. Le code utilisé est principalement écrit en Rust. Ginux propose sa propre gestion mémoire, son processus de démarrage, son ordonnanceur, son modèle de processus, ses systèmes de fichiers, son réseau, ses périphériques et sa couche de compatibilité Linux.

Sa particularité est d’implémenter l’interface binaire (ABI) de Linux afin de faire tourner les exécutables Linux existants, sans modification. Gregory Kurtzer indique que cette compatibilité est partielle : sur 375 appels système recondensés dans l’ABI Linux 6.12 en x86-64, 82 sont entièrement implémentés, 245 le sont partiellement et 48 sont refusés volontairement.

Dans l’architecture choisie par le développeur, les charges de travail sont réparties dans des environnements nommés « domaines ». Chacun dispose de ses processus, espaces d’adressage, systèmes de fichiers, points de montage, privilèges et cycle de vie. Il présente ces frontières comme plus marquées que les espaces de noms Linux et les conteneurs OCI (Open Container Initiative).

Source : Gregory Kurtzer

Des limites assumées

Gregory Kurtzer affirme que son projet a pris 11 jours. Il tâche de rester « humble » dans l’annonce en précisant plusieurs points. D’abord, le nom Ginux fait référence aussi bien à Greg qu’à GPT. Dans le README du projet sur GitHub, l’auteur plaisante : pour s’assurer que son égo reste contenu, le G est officiellement une référence à GPT, puisque le projet a été entièrement réalisé avec GPT-5.6 Sol.

En outre, Ginux ne fonctionne pour l’instant qu’au sein d’une machine virtuelle QEMU. Il n’y a donc ni profil matériel physique, ni support des GPU et disques NVMe, ni audit de sécurité indépendant. Le code est publié sous licence Apache 2.0 comme prototype de recherche.

Le développement cible principalement QEMU/KVM avec une configuration x86-64 Q35, et le dépôt documente aussi une exécution en émulation QEMU sur Apple Silicon. Kurtzer reconnaît que la couverture ABI est incomplète et le matériel peu pris en charge. Réseau, systèmes de fichiers, application des limites de ressources et sécurité demandent encore un travail décrit comme « considérable ».

Dans la méthode HDAE évoquée, c’est lui-même qui a fixé l’architecture, les contraintes, les jalons et les critères d’acceptation. L’agent, lui, menait la boucle d’implémentation : il était chargé d’écrire, démarrer, tester, diagnostiquer, corriger, recommencer face à des vérifications exécutables. C’est l’ensemble de ces actions qui ont alimenté une tâche unique confiée à GPT-5.6 Sol, produisant finalement 139 000 lignes de code et de tests, réparties sur un millier de validations Git environ.

Une expérience, pas un concurrent

En quelques jours, le projet a généré une attention croissante. Face à un nombre croissant de questions sur la possibilité que Ginux puisse concurrencer le noyau Linux, Gregory Kurtzer est intervenu le 29 octobre pour expliquer que « les gens passent à côté du but de Ginux » et que ce dernier n’a pas été conçu pour rivaliser avec Linux : « Ce serait idiot ! ».

Il considère le code produit comme jetable, car Ginux en tant que tel n’était pas le but de l’expérience. Il s’agissait bien du processus de création, c’est-à-dire confier à un agent un travail de longue haleine, guidé par une infrastructure, pour répondre à la question : « L’IA, dirigée par un ingénieur expérimenté, pouvait-elle construire et valider un système logiciel extraordinairement complexe ? ».

Il répète d’ailleurs que l’article de recherche documente la méthodologie, les résultats et les limitations, pas le noyau comme possibilité alternative. Il estime que les questions posées sur la méthode sont plus intéressantes que le résultat. Par exemple : « Combien de temps faut-il pour reproduire un problème, identifier la cause racine, implémenter une correction et valider le résultat ? Quelle intervention humaine est réellement requise ? ».

« Parce que la vraie question n’a jamais été de savoir si l’IA pouvait remplacer Linux. Même si elle peut remplacer certains aspects de sa fonction, elle ne peut pas reproduire la communauté, les normes, la collaboration, l’alignement ou la stabilité », affirme-t-il. Dans une autre publication le 30 octobre, il détaille d’ailleurs comment il a collecté les retours pour déclencher de nouveaux travaux, pour continuer à tester sa méthode.

Ginux est donc davantage une démonstration de faisabilité qu’un produit. Rien n’empêche bien sûr la communauté de s’emparer du projet et de le poursuivre. Rien ne permet d’affirmer que ce noyau alternatif, s’il était développé plus avant, offrirait des avantages concrets et mesurables par rapport au noyau Linux.

Si l’expérience a fait parler, c’est aussi parce que la question de l’IA agite largement le domaine du logiciel libre. La récente enquête publiée par Linux Foundation a montré en partie l’ampleur de ce questionnement, avec des développeurs et mainteneurs de projets dans une position ambivalente, entre abaissement du ticket d’entrée et besoins accrus de vérifier toute la production de code. Dans cette optique, l’expérience de Kurtzer donne un aperçu de ce qu’une IA, employée par un développeur expérimenté, peut accomplir quand elle est strictement encadrée.

  •  

☕️ Windows 11 a son nouveau menu contextuel et oui, il est « rapide »


Microsoft avait promis de remanier le menu contextuel de Windows 11 sur les fichiers. C’est désormais chose faite, avec la mise à jour KB5127936 disponible depuis peu en option. Ce qui signifie qu’elle n’apparaitra que si vous déclenchez une recherche volontaire de mise à jour dans Windows Update. Sinon, elle sera installée automatiquement le mois prochain.

Problème : comme toujours chez Microsoft, les nouvelles fonctions n’apparaissent pas tout de suite. Le nouveau menu contextuel est en cours de déploiement. Pour vérifier si vous l’avez après l’installation de la mise à jour, il suffit de vérifier en faisant un clic droit sur un fichier. Si c’est bien le nouveau menu, vous verrez une ligne « Personnaliser le menu » tout en bas. Il existe toutefois un moyen de forcer l’activation en passant par l’outil ViVeTool, dans un Terminal avec droits administrateur, via la commande :

vivetool /enable /id:60813048

Sur certaines configurations, cet ID peut ne pas suffire. Auquel cas, il faudra tenter avec la fin de commande « /id:49453572,60813048 », voire « /id:49453572,60813048,61934903 ». Dans notre cas, la commande simple a suffi.

Deux exemples de configuration du nouveau menu

Après un redémarrage, vous aurez alors le nouveau menu. Le jeu en vaut-il la chandelle ? Tout dépend de votre utilisation du fameux menu. Le nouveau est clairement plus réactif, ce qui était un point régulier de friction jusqu’ici. Surtout, le menu est maintenant personnalisable. En cliquant sur le dernier élément du menu, le panneau idoine s’ouvre dans Paramètres.

Les options sont assez nombreuses. On peut voir notamment une ligne permettant de retrouver les options Couper/Copier/Coller en liste, et plus les icônes en tête de menu. Il aura donc fallu cinq ans à Microsoft à comprendre qu’un élément aussi basique que le menu contextuel doit être réactif, personnalisable et que l’on ne casse pas plusieurs décennies de mémoire musculaire impunément.

La mise à jour KB5127936 contient d’autres nouveautés, comme une fenêtre modernisée pour AutoPlay, un affichage plus cohérent pour les résultats de recherche dans l’Explorateur, une nouvelle Gaming Task View en mode Xbox, ou encore l’intronisation officielle de la réinstallation par le cloud, que Microsoft avait présentée en juillet.

  •  

☕️ Tor Browser 16 se dote de noms de fenêtres génériques


Nouvelle mouture majeure pour Tor Browser, dont la version 16 se fonde désormais sur Firefox 153 ESR, avec à la clé un an de changements techniques sous le capot. Dans son billet, l’équipe de Tor Browser indique que son audit annuel du code de Firefox a porté sur plus de 270 anomalies référencées dans Bugzilla, susceptibles de nuire à la vie privée ou à la sécurité.

Côté nouveautés, la plus visible est la refonte des paramètres, qui reprennent en bonne partie ceux de Firefox. Ainsi, la page Général disparaît et son contenu est réparti entre Apparence, Téléchargements, Onglets et navigation, Accessibilité et Langues. Les pages spécifiques à Tor – comme Connexion et Niveau de sécurité – ont été reconstruites avec les nouveaux composants de Firefox.

Certains réglages qui pourraient dégrader la vie privée ou faciliter la prise d’empreinte du navigateur sont masqués ou accompagnés d’avertissements. L’équipe du navigateur ajoute que les préférences personnelles sont gardées lors de la mise à jour.

Autre nouveauté importante, les titres de fenêtres génériques. Cette option (Confidentialité et sécurité> Protections contre les applications tierces) permet de remplacer tous les titres par « Tor Brower », avec pour objectif de barrer la route au système ou autres applications qui voudraient lire l’historique de navigation via les titres de fenêtres. L’équipe est en quête de retours sur cette fonction, qui a d’ailleurs été reversée à Firefox via deux nouvelles lignes dans le about:config :

  • privacy.exposeContentTitleInWindow
  • privacy.exposeContentTitleInWindow.pbm.
Source : Tor Browser

Outre une révision complète du manuel utilisateur, Tor Browser 16 introduit également une version ARM 64 bits pour Linux (Aarch64). Cette architecture était supposée dans la branche Alpha du navigateur, mais l’équipe recommande désormais de basculer sur la branche stable.

Puisque l’on parle d’architectures, Tor Browser 16 ne prend plus en charge les installations Linux 32 bits. « Heureusement, très peu de personnes devraient être touchées, car nous recevons actuellement environ 200 vérifications de mise à jour par jour de cette plateforme, contre un pic d’environ 4 000 en 2019. La plupart des utilisateurs 32 bits restants devraient pouvoir passer à la version 64 bits, sauf s’ils utilisent du matériel ou des versions de Linux obsolètes », précise le billet.

Quant à la version Android, elle reprend elle aussi les améliorations de Mozilla sur l’année écoulée, dont le passage progressif à Jetpack Compose, permettant une migration vers des interfaces « natives », autrement dit Material Design 3. L’équipe de Tor Browser rappelle cependant que Google limite la taille des applications distribuées en APK à 100 Mo, ce qui représente « un défi constant ». Il a fallu par exemple sortir le manuel utilisateur alors que l’équipe aurait préféré qu’il soit toujours consultable, indépendamment des conditions réseau.

  •  

☕️ Microsoft lâche la version de Copilot pour les télés connectées


Le saviez-vous ? Il existe une version de Copilot pour les télés connectées, mais les jours de cet assistant sont comptés. LG a en effet commencé à prévenir les utilisateurs de ses téléviseurs sous webOS que « Microsoft a récemment décidé de mettre fin à la prise en charge de Copilot sur tous les téléviseurs, y compris les fonctionnalités intégrant Copilot proposées sur nos téléviseurs LG ». La fenêtre pop-up est partagée par Windows Central.

Image : Windows Central

Par conséquent, Copilot va tirer le rideau entre aujourd’hui et la fin de l’année, au moins sur les télés LG. Microsoft n’a cependant pas communiqué officiellement sur le sujet. L’arrivée de l’assistant ne s’était pas faite dans la douceur : en fin d’année dernière, LG et Samsung avaient installé l’application Copilot sur leurs smart TV automatiquement. Une app impossible à supprimer, d’après des témoignages de l’époque.

Dans les faits, on peut se demander si un téléspectateur a jamais utilisé les services de Copilot depuis son canapé. Il peut poser des questions en lien avec ce qui se passe à l’écran, recevoir des recommandations personnalisées de contenus, ou encore demander la météo ou une précision sur telle ou telle actualité.

C’était à un moment où Microsoft voulait encore imposer Copilot partout, parfois en dépit du bon sens. L’éditeur a retrouvé une certaine sobriété depuis. Le projet d’intégrer Copilot dans Xbox a finalement été abandonné au printemps. En septembre, il rassemblait toutes ses applications en une seule (quitte à complexifier l’utilisation de l’assistant). Plus largement, Microsoft a aussi décidé de mettre (un peu) de côté l’IA pour serrer les boulons d’un Windows 11 tout de guingois.

  •  

Apple ajoute du JSON dans Xcode et Keynote pour les agents IA et les développeurs

Merci qui ? Merci l’IA
Apple ajoute du JSON dans Xcode et Keynote pour les agents IA et les développeurs

Apple ouvre Xcode et Keynote à de nouveaux formats de fichier basés sur JSON. Il s’agit en priorité de faciliter la vie des agents IA, mais les développeurs de chair et de sang vont aussi en profiter.

Depuis sa version 27.2, Xcode, l’environnement de développement d’applications d’Apple, propose un nouveau format de projet (.xcproj) basé sur JSON. Il en ira bientôt de même pour l’application de présentation Keynote avec la prise en charge à venir des fichiers .keyx (Keynote Interchange Format), un format qui repose lui aussi sur JSON.

Des fichiers plus faciles à lire et à modifier

Apple vante des formats plus faciles à exploiter par les outils tiers et les agents IA. Le xcproj est « plus simple à modifier pour les agents IA », tandis que le keyx est conçu pour être « lisible et accessible aux outils externes, aux workflows de développeurs et aux agents d’IA ». En ce qui concerne Xcode en particulier, les développeurs réclamaient depuis des lustres un format de fichier moins complexe et plus lisible.

Comme son acronyme l’indique, le format de données JSON (JavaScript Object Notation) repose sur la notation des objets du langage JavaScript. Il décrit des éléments et leurs propriétés : le titre d’une diapositive par exemple, ou encore les réglages d’un projet Xcode. Très répandu, il peut être lu et modifié par de nombreux outils. Le choix du JSON ne fait pas tout : l’organisation des données compte tout autant pour rendre un fichier facile à exploiter.

Cette structure claire profite aussi bien aux humains qu’aux agents IA, pour identifier des éléments, leurs propriétés et les relations entre eux. Les agents peuvent dès lors intervenir plus facilement dans les fichiers pour créer des diapositives, remplacer des données ou modifier des réglages dans un projet Xcode. Les fichiers JSON ne garantissent pas la lisibilité du document, mais ils rendent le travail moins casse-tête.

Comme le rappelle John Gruber, l’ancien format de projet pour Xcode (.pbxproj) utilise une liste de propriétés héritée de NeXT. Un format ASCII « étonnamment proche de JSON » relève l’observateur, mais qui précède non seulement JSON mais aussi JavaScript.

Ce format représente les éléments avec des identifiants sans signification évidente. Une petite modification dans Xcode peut entraîner plusieurs changements à différents endroits du fichier du projet. Techniquement, le fichier reste lisible par un humain, et donc par un agent IA, mais les références croisées entre éléments obscurs rendent les modifications manuelles (via un éditeur de texte par exemple) assez délicates.

L’IA avant les humains

L’adoption de formats mieux structurés et documentés est donc une bonne nouvelle, aussi bien pour Keynote que pour Xcode. Même si, comme le déplore le développeur Rob Napier, Apple donne l’impression d’avoir cédé très rapidement à l’IA alors que les humains réclamaient un tel changement depuis des années : « C’est frustrant qu’il ait fallu l’argument « ça peut aider l’IA » pour que les choses bougent. »

En ce qui concerne Keynote, ce nouveau format – pas encore disponible – pourrait bien représenter un véritable bouleversement pour le vénérable logiciel. Les fichiers .key actuels regroupent les médias (images, vidéos, sons) et les descriptions des objets de la présentation dans des fichiers .iwa (textes, mise en forme). Et comme l’indique MacGeneration, ces fichiers sont difficiles à exploiter avec des outils autres que Keynote.

Keynote était pourtant parti d’un bien meilleur pied : en 2003, la première version du logiciel utilisait le format APXL (Apple Presentation XML), autrement dit un fichier XML décrivant la présentation, accompagné des ressources associées. C’est en 2013 que le constructeur a basculé dans la structure actuelle, difficile à lire.

  •  

IA : la Linux Foundation constate l’épuisement croissant des contributeurs

Beau bazar
IA : la Linux Foundation constate l’épuisement croissant des contributeurs

Quel effet produit l’IA sur le développement open source ? Selon un rapport de la Linux Foundation, il est conséquent, entre augmentation de la production brute, abaissement du ticket d’entrée, obligation plus intense de relecture et épuisement d’une partie des personnes impliquées.

La question de la productivité et des transformations dans les processus est au cœur des questionnements autour de l’IA, les études, rapports et articles étant particulièrement nombreux depuis quelques mois. Dans les grandes lignes, les constats sont les mêmes : la production brute s’envole, mais l’IA impose sa « taxe de vérification », annulant une partie importante de ses bénéfices et ne débouchant pas sur une hausse des livraisons de produits finis dans les mêmes proportions.

La Linux Foundation souhaitait donc faire un point d’étape auprès de mainteneurs de projets open source, pour savoir comment leurs habitudes avaient changé, et surtout quels étaient les problèmes constatés. Une étude a ainsi été réalisée par Sam Boysel de la Linux Foundation et Anni Lai de Generative AI Commons, avec une préface de Brian Proffitt de Red Hat. L’entreprise a d’ailleurs financé le travail.

Un effet direct sur la production

Au cœur du rapport, on trouve un constat significatif : les effets de l’IA dépendent de la taille du projet. Ainsi, 59 % des mainteneurs ont observé une hausse du volume des contributions, le chiffre passant à 69 % dans les projets d’au moins 50 contributeurs. Un quart environ des demandes de fusion reçues sont jugées de faible qualité, 31 % dans les grands projets. C’est le fameux « slop » (ou bouillie) tant décrié, notamment par l’équipe de FFmpeg.

Sans trop de surprise, 52 % des mainteneurs indiquent que leur temps de relecture a augmenté, le chiffre passant à 64 % dans les grands projets. Dans ces derniers, l’épuisement est d’ailleurs devenu la première préoccupation, devant la qualité des contributions. Une nouvelle manifestation de la « taxe de vérification ». La vérification, justement, repose largement sur la confiance et l’inspection mutuelle, les attestations formelles se développant avec la taille du projet : 20 % dans les petits, 41 % dans les grands. Signe des temps : les trois quarts des mainteneurs interrogés ont indiqué recourir au moins partiellement à l’IA pour examiner les contributions reçues.

Source : Linux Foundation

Une barrière d’entrée plus basse, mais une confiance dégradée

L’utilisation de l’IA au sein des projets est cependant très variable. 35 % seulement ont une politique écrite autorisant l’IA, 10 % l’interdisent, 23 % comptent en adopter une et le tiers restant n’a encore rien de prévu. Les politiques existantes portent surtout sur la divulgation et la responsabilité du contributeur (76 % chacune), beaucoup moins sur les licences (39 %). Les chiffres reflètent un paysage contrasté que nous avons pu voir à plusieurs reprises. Certains projets, dont Debian et le noyau Linux lui-même, n’ont plus aucun problème avec les contributions générées par IA, à condition que la personne qui les soumet soit en mesure de les expliquer. D’autres, comme Zig, Servo, Gentoo ou encore QEMU interdisent toute contribution générée par IA.

D’autres données intéressantes sont présentes dans le rapport. Par exemple, l’IA est utilisée dans toutes les étapes du développement : nouvelles fonctionnalités (83 %), débogage et tests (78 %), refactorisation (71 %), ou encore documentation (69 %). Sans surprise une fois de plus, les principaux gains de temps observés sont à 52 % sur l’écriture du code, mais les mainteneurs évoquent des gains se réduisant avec la complexité du projet. Sur les tâches complexes, 21 % indiquent même mettre plus de temps qu’avant.

Si les mainteneurs estiment à 71 % que l’IA abaisse la barrière d’entrée, elle dégrade aussi la confiance au sein de la communauté pour 53 % d’entre eux, quand 13 % seulement y voient une amélioration. Dans le même domaine, 46 % pensent que le besoin d’accompagnement des nouveaux venus dans un projet est supérieur.

Source : Linux Foundation

La Linux Foundation avance ses recommandations

Le rapport, fourni très officiellement par la fondation, comporte huit recommandations applicables à tout projet libre. On y retrouve des prises de position déjà observées dans certains projets, qui sont également autant de constats faits par le rapport auprès des mainteneneurs :

  • établir une politique claire et écrite sur les contributions assistées par IA et sur le signalement des vulnérabilités ;
  • donner la priorité, dans cette politique, aux exigences de transparence et de divulgation. Les contributeurs doivent indiquer clairement et de façon constante aux mainteneurs les outils d’IA générative utilisés ;
  • reporter la charge de la vérification sur les contributeurs, en exigeant une attestation sur l’honneur, des tests et une documentation des modifications assistées par IA avant leur soumission ;
  • normaliser les pratiques d’attribution des contributions assistées par IA, afin que la divulgation ne reste pas laissée à l’appréciation de chacun. Une solution serait d’adopter et d’imposer le format « Assisted-by: » dans les commits ;
  • utiliser l’IA comme outil de maintenance : les outils d’IA peuvent servir à trier, résumer et signaler les problèmes dans les contributions reçues, pour alléger la relecture et réduire l’épuisement des mainteneurs ;
  • continuer d’investir dans l’accompagnement humain des nouveaux contributeurs : l’IA générative abaisse la barrière d’entrée, mais elle augmente le besoin d’encadrement une fois ces contributeurs arrivés, au lieu de le réduire ;
  • mettre en balance les gains d’accessibilité apportés par l’IA générative et son coût pour la confiance au sein de la communauté, et concevoir des règles de contribution qui accueillent les nouveaux venus sans sacrifier la qualité ni la confiance ;
  • une gouvernance de qualité et la confiance comptent davantage que l’amélioration des performances techniques.

En somme, chaque projet devra faire ses propres choix, car ces propositions ne sont pas des obligations. La Linux Foundation n’a d’ailleurs aucun pouvoir en la matière, l’un des principaux buts de la structure étant d’aider et de fournir des ressources, en plus de son effet structurant.

Entre conseils déclaratifs et « combattre le feu par le feu »

Certains points peuvent d’ailleurs faire hausser quelques sourcils. Par exemple, la recommandation d’utiliser le format « Assisted-by: » dans les commits est fait en référence directe au noyau Linux. Or, les mainteneurs de ce dernier ont récemment décidé de ne plus le rendre obligatoire. Linus Torvalds, en particulier, s’est montré très clair sur la question, avec une certaine véhémence face à un mainteneur du noyau qui militait pour préserver cette obligation. Même si le rapport a été clos en juin dernier, il ne tient pas compte de ce changement, qui reste antérieur à la publication de la Linux Foundation.

Cette synthèse affiche également plusieurs faiblesses. Outre son aspect purement déclaratif, le profil des mainteneurs interrogés est particulier, les répondants ayant été recrutés via les canaux de la fondation. 52 % des interrogés ont ainsi 11 ans ou plus d’ancienneté comme contributeurs et 75 % utilisent l’IA quotidiennement, tous usages confondus. En outre, les secteurs d’activité dominants sont les systèmes d’exploitation et l’infrastructure. On est donc plutôt face à un groupe de développeurs expérimentés, loin des contributeurs occasionnels, ce qui éloigne d’autant la vue de synthèse du paysage open source.

Le rapport apporte néanmoins plusieurs bénéfices, notamment des données chiffrées sur un sujet jusqu’ici traité surtout à travers quelques incidents et prises de position. Il montre aussi que la charge se concentre sur les grands projets et les équipes de mainteneurs, qu’il existe un retard manifeste sur la gouvernance des projets, ou encore que les tâches complexes n’affichent aucun gain voire prennent plus de temps.

Surtout, le rapport enfonce un peu plus le clou sur le glissement des coûts de la production de code vers sa vérification. Mais il pose aussi une question sans la trancher : comment préserver la confiance si l’IA élargit le vivier de contributeurs tout en affaiblissant les signaux qui permettaient de juger une contribution avant de la lire en détail ? Le libre se retrouve dans une position inconfortable, assis entre deux chaises, entre relecture systématique et filtrage à l’entrée pour les nouveaux venus.

Enfin, le rapport évoque dans son résumé du début une recommandation qu’il ne reconduit pas dans sa liste finale : « combattre le feu par le feu ». En d’autres termes, les mainteneurs devraient eux aussi utiliser l’IA comme premier maillon de la chaine de vérification, afin de retrouver du temps.

  •  

☕️ OBS Studio 33 revoit complètement sa gestion des plugins


Nouvelle mouture pour le logiciel open source d’enregistrement vidéo et de streaming en direct, avec bon nombre de nouveautés à la clé. L’un des plus gros changements se situe sous le capot, avec la mise à jour de CEF (Chromium Embedded Framework), le composant utilisé pour les sources navigateur et les panneaux ancrables. Il passe de la version 127/6533 à la 150/7871, soit un cumul de plus de deux ans de modifications.

On reste sous le capot avec une série d’améliorations, comme l’activation par défaut de NVENC (NVIDIA Encoder) sur ARM64, la présence des derniers SDK NVIDIA Broadcast pour les effets audio et vidéo, une meilleure détection des jeux en plein écran, une gestion améliorée de la transparence de la capture d’écran sur macOS, un découpage amélioré des fichiers MP4/MOV hybrides, ou encore une mise à l’échelle du débit audio selon le nombre de canaux pendant un enregistrement simple.

Côté interface, la nouveauté majeure est la nouvelle gestion des plugins. Les extensions natives sont ainsi regroupées dans un nouveau dossier core, tandis que les plugins tiers ont un nouvel emplacement et une nouvelle arborescence. Attention, les extensions tierces existantes sont encore chargées depuis les anciens emplacements, mais uniquement jusqu’à la prochaine version 34, qui bloquera ce scénario. L’équipe d’OBS a mis à disposition une page explicative à ce sujet, avertissant les développeurs qu’ils doivent mettre à jour leur code pendant l’intervalle, sans quoi leurs plugins ne seront plus chargés.

Parmi les autres améliorations, signalons-en plusieurs pour l’interface. Par exemple, pour l’accrochage des sources dans l’aperçu, un indicateur visuel a été ajouté. L’accrochage se fait désormais sur l’ensemble de l’axe et plus seulement au contact, tandis que les sources masquées sont ignorées. On remarque aussi l’apparition de raccourcis clavier pour l’écoute audio, l’ajout d’une vérification des codeurs manquants au chargement des profils, ou encore des soucis corrigés avec les champs numériques à incrément, dont la saison pouvait parfois se bloquer ou les nombres se tronquer.

Dans les notes de version, on peut également voir un « nettoyage » assez prononcé pour cette version, qui abandonne de nombreux composants, voire plateformes. Ubuntu 24.04 n’est ainsi plus pris en charge. Pour les utilisateurs concernés, il est donc nécessaire de migrer vers la version 26.04, dont le chemin de migration s’est ouvert il y a moins d’un mois. L’utilisation de la version Flatpak permet de contourner ce problème. OBS Studio 33 écarte en outre toutes les versions 6.X et 7.X de FFmpeg, ainsi que toutes les moutures de Qt entre la 6.4 et la 6.9.

À noter que la nouvelle mouture est présente sur le dépôt GitHub du projet depuis trois jours mais n’a pas encore été répercutée sur le site officiel au moment où nous publions cet article.

  •  

Windows 11 supporte désormais les instructions APX, dont personne ne peut profiter

Il suffira de changer de matériel
Windows 11 supporte désormais les instructions APX, dont personne ne peut profiter

Windows 11 introduit la prise en charge d’instructions matérielles qui promettent une hausse générale des performances. Ces instructions, APX, n’équipent cependant aucun processeur aujourd’hui.

Le 23 octobre, Microsoft a publié la build 29695 dans le canal Expérimental de son programme Windows Insider. Si cette préversion contient bon nombre d’améliorations en lien avec l’accessibilité et le contrôle parental, elle présente une nouveauté nettement plus discrète, presque cachée dans les options pour développeurs : le support des instructions APX.

APX double les registres généraux

Un peu de contexte. En 2024, Intel et AMD ont formé le x86 Ecosystem Advisory Group (x86 EAG), dont l’objectif est faire évoluer le jeu d’instructions x86-64 de manière concertée, afin d’établir une plateforme matérielle cohérente. C’est d’ailleurs dans ce cadre qu’Intel avait abandonné son projet de x86S.

Le 27 août 2025, Robert Hormuth, vice-président d’AMD, publie un message sur LinkedIn pour informer que l’EAG a déjà produit ses premières technologies : le nouveau modèle d’interruption FRED (Flexible Return and Event Delivery), ainsi que les instructions AVX10 et APX.

Si les différentes variantes d’AVX sont orientées vers le calcul vectoriel, l’objectif d’APX est au contraire d’augmenter les performances du code général. APX n’est pas directement issu de l’EAG puisqu’Intel avait présenté ces instructions en juillet 2023. Un processeur compatible APX dispose de 32 registres généraux, contre 16 aujourd’hui.

Selon Intel, un code compilé avec APX permet de réduire les lectures de 10 % en mémoire et les écritures d’au moins 20 %, comparé à un code compilé x86_64 standard. En outre, les instructions entières peuvent désigner un registre de destination distinct via un format à trois opérandes qu’Intel nomme NDD dans sa documentation. Cet ajout permet d’éviter l’écrasement d’une des sources et de réduire les copies de registres.

En outre, le code APX compte environ 10 % d’instructions en moins, la densité du code étant similaire malgré des préfixes plus longs. Notons aussi qu’APX élargit le jeu d’instructions conditionnelles de x86 pour limiter le coût des erreurs dans la prédiction de branchement.

Retour à Windows

C’est le support de ces instructions que Microsoft vient d’ajouter à sa dernière build dans le canal Expérimental. Ce qui veut dire que la firme commence effectivement à compiler le code du système avec APX. On peut activer ce support dans les options pour développeurs, laissant une interrogation en suspens : pourquoi passer par un paramètre si le code est prêt ?

Bien que l’on puisse se réjouir d’un tel support, l’enthousiasme fait face à une barrière matérielle : aucun processeur actuel ne supporte les instructions APX.

Chez Intel, il va falloir attendre en effet la génération Nova Lake, toujours censée arriver fin 2026 (avec le nouveau socket LGA 1954). Tom’s Hardware indiquait cependant en juin dernier que, selon plusieurs sources, un lancement au premier trimestre 2027 était plus probable, via la série Core Ultra 400. Côté AMD, on ignore encore quand arrivera le support d’APX. Peut-on l’espérer pour les processeurs de bureau Zen6 ? Dans l’absolu oui, mais avec de grosses pincettes : AMD respecte habituellement la parité sur les instructions entre ses puces EPYC et Ryzen, et les puces EPYC Zen6 (Venice) ne possèdent pas (a priori) les instructions APX.

En d’autres termes, si les instructions promettent une hausse générale des performances (sans doute très variable selon les scénarios), Microsoft ne fait que préparer le terrain. On peut imaginer que le lancement des processeurs Nova Lake s’accompagnera d’une campagne marketing pour encourager le grand public (ou les entreprises) à se tourner vers de nouveaux achats, en misant sur ces améliorations.

Notez enfin que Microsoft n’est pas le premier acteur à réagir sur les instructions APX. Leur prise en charge initiale a commencé en effet dans le noyau Linux à partir de sa version 6.16.

  •  

☕️ Après 17 ans, Microsoft ferme son Garage


En 2009, Microsoft lance The Garage, un drôle d’ovni. L’idée est simple : les employés devraient pouvoir développer leurs projets personnels, tout en profitant des conseils et infrastructures de l’entreprise. Un groupe expérimental d’où de nombreuses idées vont fuser.

En 2014, The Garage prend une tout autre dimension. Le nouveau CEO de Microsoft, Satya Nadella, considère alors le groupe comme une très bonne initiative. Cette année, Microsoft organise ainsi, pour la première fois de son histoire, un hackathon. 11 000 personnes de 80 pays vont y participer, consacrant le succès de l’opération.

En 17 ans d’existence, The Garage a vu fleurir de nombreuses idées, dont plusieurs ont finalement été intégrées à des offres commerciales ou endossées très officiellement par Microsoft. C’est par exemple de ce groupe expérimental qu’est issu Arrow Launcher pour Android, qui finira par devenir Microsoft Launcher. Autre outil qui a connu une belle histoire, Mouse without Borders, qui permet de contrôler plusieurs PC depuis un seul duo clavier/souris, et intégré aux PowerToys depuis 2023.

On pourrait aussi citer Journal, le clavier pour iOS Word Flow, ou encore l’application de prise de notes Plumbago, autant de projets depuis arrêtés ou intégrés sous une autre forme. D’autres sont devenus des produits à part entière, comme Azure Quickstart Center, Azure Resource Graph, Microsoft Health Bot Service ou Video Indexer.

Pourquoi fermer aujourd’hui The Garage ? Selon GeekWire, qui dit avoir eu accès à la FAQ interne sur le sujet, Microsoft estimerait que l’innovation n’est aujourd’hui plus limitée à ce type de groupe, mais survient « chaque jour au sein de chacune de nos équipes ». Les espaces physiques dédiés au Garage commencent ainsi à être fermés dans les locaux qui en avaient développés, les employés ne pouvant emporter aucun équipement présent sur place.

Si l’on en croit GeekWire, la décision est bien sûr controversée. Sur le service Blind, qui sert à commenter anonymement les conditions de travail dans une entreprise, un billet était ainsi intitulé « Amy kills the Garage », en référence à Amy Hood, directrice financière de Microsoft. Sur cette publication depuis supprimée, certains commentaires faisaient l’éloge de ces structures, qui permettaient notamment de rencontrer du monde et de créer des connexions professionnelles. Toujours selon nos confrères, un commentaire indiquait : « Les espaces Garage étaient l’un des derniers trucs cools chez Microsoft ».

  •  

Un premier jailbreak fait sauter les verrous de la Switch 2

Une faille BASIC
Un premier jailbreak fait sauter les verrous de la Switch 2

Un jailbreak de la Switch 2 est en approche. En exploitant une série de failles, un bidouilleur est parvenu à exécuter du code dans le système de la console de Nintendo. Voilà qui ouvre la porte aux homebrews et à la modification de jeux, même si l’opération demeure complexe et que Nintendo veille au grain.

16 mois après son lancement, voici que déboule ce qui ressemble fort au premier jailbreak de la Switch 2. Sammy Hajhamid est parvenu à modifier Mario Kart World en y intégrant des pilotes inédits comme Peter Griffin, le patriarche de la série animée Family Guy, Red d’Angry Birds ou encore Hatsune Miku. Un exploit rendu possible par une bidouille qu’il décrit sur son blog.

Sonic, Steve de Minecraft, Walter White de Breaking Bad… Des pilotes jamais vus dans Mario Kart World. Image : Sammy Hajhamid

Le maillon faible

Le jailbreak passe par l’application SmileBASIC, qui permet d’exécuter des programmes BASIC sur la Switch 2 en tout bien tout honneur. Mais une erreur de calcul sur des entiers de 32 bits dans une commande permet de lire et de modifier de la mémoire en dehors des limites prévues.

Sammy Hajhamid a ensuite tiré partie d’une erreur dans le traitement des chemins du service qui s’occupe des systèmes de fichiers de la console. En l’occurrence, il s’agit d’un tampon temporaire trop petit permettant de lire et d’écrire dans la mémoire du service en question. Ça ne suffit pas pour exécuter de nouvelles instructions, mais on s’en approche.

En modifiant la mémoire de ce service, il devient possible de lui faire fournir un autre exécutable que celui attendu, tout en conservant les métadonnées authentiques du programme d’origine. Les vérifications de signature passent donc, mais le code chargé a été remplacé : le mécanisme de confiance est contourné. Le bidouilleur peut désormais exécuter son propre code avec les permissions d’un service système, puis s’en servir pour modifier le code du service de fichiers lui-même.

Un jailbreak sous contraintes

Le dépôt GitLab du bidouilleur permet de tester soi-même l’opération, pour peu qu’on dispose de SmileBASIC… qui n’est plus distribué dans l’eShop. Rien n’a été confirmé, mais il n’est pas interdit de penser que Nintendo est derrière le retrait précipité de cette application. L’histoire repasse ici les plats, puisque SmileBASIC avait déjà été utilisé pour des homebrews sur la 3DS.

Le tout a demandé deux semaines de travail au hacker, armé de Codex et d’un actionneur Bluetooth faisant office d’interrupteur : il appuyait sur le bouton d’alimentation de la console quand c’était nécessaire ! Ce jailbreak fonctionne avec la dernière version du système d’exploitation de la Switch 2 (23.0.1), mais il a une limite importante : il nécessite un ordinateur pour l’installer, et il doit être relancé après le redémarrage de l’appareil.

Malgré tout, c’est une première brèche qui pourrait ouvrir la voie à tout un monde de possibilités : des programmes homebrew, des mods, de l’ingénierie inverse et bien évidemment, des jeux piratés.

Il ne fait guère de doute que Nintendo regarde tout cela de très près, en ayant en tête ce qui s’était passé avec la Switch première du nom. Les premiers outils permettant d’exécuter des homebrews étaient apparus moins d’un an après son lancement, avant qu’une faille bien plus profonde ne facilite le développement des firmwares personnalisés et le piratage de jeux.

  •  

Bureautique, collaboration : la Cour des comptes fait ses calculs et étrille la DINUM

La Cour décompte
Bureautique, collaboration : la Cour des comptes fait ses calculs et étrille la DINUM

La Cour des comptes vient de publier un rapport sur l’usage des outils bureautiques et collaboratifs au sein de l’État. Les constats y sont nombreux et pour la plupart négatifs. La Cour préconise donc un plan homogène de modernisation avec un passage plus poussé au libre. Des recommandations accueillies « favorablement » par le Premier ministre.

La Cour des comptes a publié le 20 octobre trois documents liés : un rapport complet sur les outils bureautiques et collaboratifs au sein de l’État, sa synthèse et la réponse du Premier ministre. Ce rapport fait suite à une enquête, qui répondait elle-même à une saisine citoyenne.

Le rapport couvre les administrations centrales et les services déconcentrés des ministères. Même si les opérateurs, la Sécurité sociale, les hôpitaux et les collectivités en sont exclus, le parc ainsi analysé compte tout de même 860 000 postes. Quatre ministères concentrent près de 90 % de ce nombre imposant : Intérieur (34 %), Armées (23 %), Économie et finances (18 %), Justice (11 %).

La Cour des comptes s’est donné la mission de répondre essentiellement à deux questions : Comment les outils bureautiques et collaboratifs sont utilisés ? Peut-on faire mieux ?

Un parc très hétérogène

Cela ne surprendra personne, mais le premier constat est que les différents parcs informatiques sont très hétérogènes. La doctrine qui a toujours prévalu jusqu’à récemment est que les ministères sont libres de leurs choix. D’un côté, cela permet une adaptation simple aux spécificités et donc aux besoins de chacun. De l’autre côté, chacun fait à sa manière, avec les fortes disparités qui en découlent.

Malgré cette grande hétérogénéité, la suite Office de Microsoft est utilisée presque partout. Deux grandes exceptions sont signalées : la direction générale de la gendarmerie nationale (DGGN) et la direction générale des finances publiques (DGFiP), qui recourent massivement aux solutions libres. Dans le cas de la gendarmerie, même le système d’exploitation a été remplacé il y a longtemps (Gendbuntu), mais elle garde environ 2 500 postes avec Office. La Cour note également que quelle que soit la configuration choisie, le taux général de satisfaction est à peu près le même partout.

Cependant, le cadre a changé. « Face aux enjeux renouvelés de coordination et de souveraineté numérique, l’État a cherché à rationaliser les pratiques en place par des directives plus contraignantes, parmi lesquelles l’interdiction en 2021 du recours à la solution Microsoft 365, l’encadrement à partir de 2023 des outils de visioconférence et des messageries instantanées ou, en 2025 et 2026, le contrôle des achats numériques », indique ainsi la Cour des comptes.

La DINUM épinglée pour suivi peu rigoureux

Signe des temps, le rapport note l’utilisation croissante dans les ministères des outils rassemblés dans La Suite, développée par la DINUM. Si la Cour des comptes loue la création d’outils sur la base de logiciels libres respectant les exigences de souveraineté et d’interopérabilité, elle égratigne le recours aux startups d’État, modèle justement retenu par la DINUM, car il est souple et permet un financement rapide. En revanche, « il n’est pas adapté à l’édition logicielle professionnelle, qui suppose une vision du produit sur plusieurs années, une feuille de route technique robuste et un haut niveau de support, documentation et maintenance ».

La Cour se montre globalement critique face à la DINUM. La Direction n’a ainsi « pas fourni à la Cour de tableau de bord permettant un suivi précis des prestations réalisées, par module ou par intervenant ». Le seul suivi communiqué est comptable et qualifié de « parfois approximatif ». « Ce n’est pas du niveau attendu pour des solutions numériques ayant vocation à être opérées dans l’ensemble des administrations de l’État », fustige la Cour, qui épinglait déjà ce manque de rigueur en 2024. Selon le rapport, la DINUM a convenu de la nécessité de renforcer son suivi.

La DINUM en prend pour son grade sur un autre sujet. Elle est accusée de développer elle-même des logiciels, plutôt que de faire vivre l’écosystème d’entreprises françaises du libre. Interrogé dans le cadre de l’enquête, le CNLL (qui représente une partie des éditeurs de logiciels libres en France) a cité l’entreprise publique allemande ZenDiS comme référence, car elle assemble des briques libres en sous-traitant à sept entreprises pour produire openDesk. Là encore, le constat était sensiblement le même en 2024.

Malgré les critiques, le rapport estime que les résultats de La Suite sont « probants ». Tchap compte ainsi 368 000 utilisateurs actifs fin 2025 et ProConnect 930 000 connexions mensuelles. Cependant, La Suite a des limites connues et ne peut pas remplacer une suite bureautique, notamment car elle n’a ni tableur, ni outil de présentation, ni agenda. En outre, elle ne fonctionne qu’en ligne, la Messagerie n’est pas déployable à grande échelle à court terme et Docs assure surtout de la prise de notes collaborative.

Un coût en forte progression mais qui reste limité

La Cour relève une facture générale d’environ 100 millions d’euros pour l’année 2025 sur l’ensemble du parc analysé. Ce chiffre est en forte augmentation, avec + 50 % depuis 2021, contre + 16 % pour les dépenses de fonctionnement de l’État. Cependant, le même chiffre reste contenu, car il représente moins de 2 % du budget numérique total, estimé à 5,5 milliards d’euros.

Le coût moyen est de 87 euros par poste et par an, mais avec des écarts extrêmes : 20 euros à l’Intérieur et 378 euros à la Culture. Ce montant tient à de multiples facteurs, dont l’un des plus importants est l’utilisation de Microsoft 365. Contrairement à la suite Office, Microsoft 365 est un abonnement donnant accès à plus ou moins d’outils et d’espace de stockage selon le niveau choisi. Or, même si Microsoft 365 est interdit, certains ministères disposent d’une dérogation, dont la Culture.

Cette facture de 100 millions fait pourtant grincer la Cour, car il n’est pas issu d’un chiffrage précis : « Ce montant a été reconstitué par la Cour, qui a constaté que dans plusieurs ministères le suivi était lacunaire aussi bien pour ces dépenses – du fait d’une comptabilité analytique défaillante – que pour le parc informatique lui-même ».

Toujours sur cette année 2025, 61 millions d’euros étaient consacrés aux licences logicielles bureautiques et collaboratives, dont les quatre cinquièmes pour Microsoft, « sans compter les autres logiciels tels que le système d’exploitation Windows ». Le rapport liste également 26 millions d’euros pour les prestations et 13 millions alloués à la masse salariale des postes de maintenance et de support sur ces outils.

Quant à La Suite, son coût total depuis 2021 est d’environ 40 millions d’euros, en augmentation moyenne de 40 % par an. Cependant, et encore une fois, les « investigations menées à l’occasion de cette enquête montrent également que le suivi administratif et financier par la DINUM des prestations réalisées par les freelances aurait dû être plus rigoureux pour s’assurer de la juste adéquation entre les ressources allouées et les travaux réalisés ».

Il faut accentuer le passage au libre

Bien que la Direction interministérielle soit copieusement critiquée, ses développements ont quand même de quoi satisfaire et « suivent une trajectoire solide », note la Cour des comptes.

Le rapport insiste sur la nécessité de développer l’usage des logiciels libres, car ils sont « un gage d’indépendance des administrations publiques » et « économiquement plus vertueux ». En se basant sur les données recueillies, la Cour chiffre entre 30 et 65 millions d’euros les économies qui seraient réalisées dans l’ensemble des ministères par l’utilisation « plus systématique de logiciels libres bureautiques on-premises », c’est-à-dire sur site.

La Cour indique que les ministères souhaitent en majorité continuer à utiliser Office. Ils envisagent même de migrer sur les infrastructures de Bleu « lorsque les logiciels de Microsoft pourront y être exploités sous la qualification souveraine SecNumCloud ». Cependant, pour les mêmes motifs que précédemment, « il conviendrait plutôt de travailler à ce qu’une solution bureautique libre en mode cloud (interne à l’État ou qualifié SecNumCloud) puisse être proposée en alternative et devienne, à terme, la norme au sein des administrations de l’État ».

Quatre recommandations, accueillies favorablement

Le rapport de la Cour des comptes se termine par quatre recommandations, qui devraient toutes êtes engagées dès 2027 :

  1. Associer plus fortement les ministères à la conception de la feuille de route de La Suite ainsi qu’à sa gouvernance ;
  2. Intégrer les outils collaboratifs et bureautiques dans le périmètre de gouvernance de la DINUM ;
  3. Faire évoluer le modèle de développement de la Suite pour mieux s’appuyer sur des entreprises disposant d’une expertise en matière de logiciels libres ;
  4. Engager la convergence vers « des outils en mode cloud » et prévoir un plan de migration, « sur trois à quatre années au maximum », pour orienter les stratégies numériques des ministères et de leurs opérateurs.

Ces quatre recommandations ont été accueillies favorablement par le Premier ministre, Sébastien Lecornu. Dans sa réponse, celui-ci indique d’ailleurs que la création d’ARIANE (Autorité référente pour l’intelligence artificielle et le numérique de l’État) au 1ᵉʳ janvier 2027 permettra d’accélérer les travaux, puisqu’elle aura « notamment vocation à renforcer la cohérence des choix technologiques de l’État ».

  •  

☕️ OpenBSD 8.0 est disponible avec une foule d’améliorations sur le support matériel


OpenBSD n’est pas un système que l’on croise forcément tous les jours, à moins d’exercer un métier spécifique, notamment dans les réseaux. Ce système Unix s’est fait un nom depuis longtemps dans ce domaine, ses composants étant régulièrement repris dans de nombreux équipements.

Quand une nouvelle version arrive, sa liste de modifications est donc un peu « aride ». On trouve certes une mise à jour générale des applications et composants : Chromium 154, Firefox 157, GNOME 49, KDE Plasma 6.7.5, GCC 16.1.0, LLVM 21.1.8 et 22.1.8, Go 1.27.1, Rust 1.98.1, Python 3.14.7 ou encore PostgreSQL 18.6 dans le cas présent.

Les nouveautés les plus significatives sont cependant sous le capot. Sur l’architecture amd64 (soit l’écrasante majorité des PC aujourd’hui), l’espace d’adressage virtuel du noyau passe ainsi de 4 à 512 Go, augmentant d’autant le mappage de la mémoire vidéo. On note une amélioration des performances de chiffrement sur amd64 et arm64, OpenBSD se servant désormais des instructions AES matérielles du processeur. Sur arm64, l’hibernation fait son entrée.

Nous n’allons pas lister toutes les améliorations, mais en voici plusieurs : un pilote drm resynchronisé avec le noyau Linux 6.18.53, le support par vmd d’un maximum de 64 processeurs virtuels par machine invitée, les interruptions MSI/MSI-X pour virtio et le déchargement du calcul des sommes de contrôle, l’acceptation des en-têtes HTTP personnalisés par httpd, l’arrivée d’OpenSSH 106 et de LibreSSL 4.4.0, ou encore un grand nombre de correctifs.

L’équipe de contributeurs a également mis en ligne une procédure pour mettre à jour l’actuel OpenBSD 7.9 vers cette nouvelle version 8.0.

  •  
❌