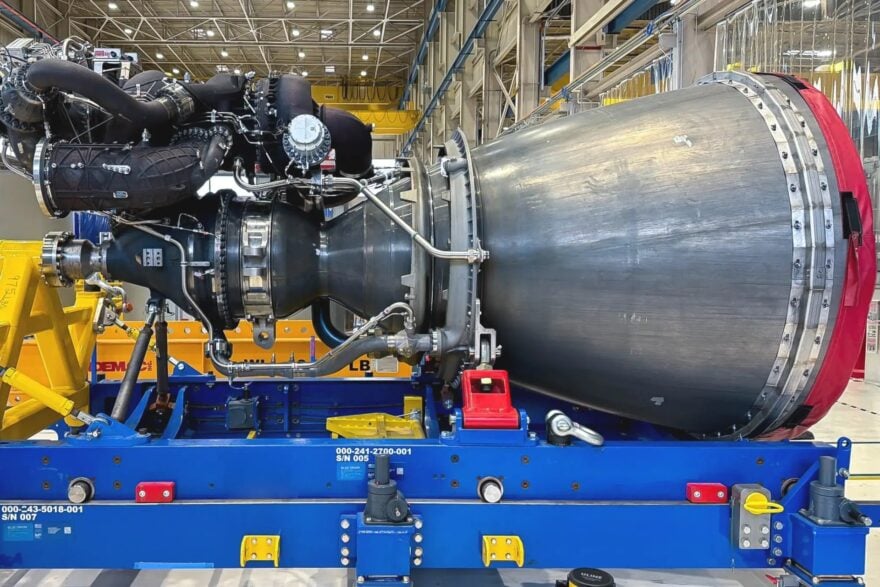
Mise sous pression par les ambitions spatiales de la Chine, l'agence américaine met le pied au plancher pour que les astronautes américains foulent à nouveau le sol lunaire avant les taïkonautes chinois.
Alors qu’OpenAI et Anthropic ont affiché des « découvertes » scientifiques en laissant à la communauté le soin de vérifier les résultats obtenus par leurs IA, les jeunes chercheurs et chercheuses se sentent démotivés, bien qu’ils utilisent énormément ces outils.
Anna Brandenberger, Hannah Mularczyk et Dora Woodruff, trois jeunes chercheuses du département de maths du MIT ont lancé un sondage auprès de leurs jeunes collègues pour savoir quel est leur état d’esprit alors que, depuis plusieurs mois, l’IA générative bouscule la recherche en mathématiques. Il en ressort notamment que plus des trois quarts se disent d’un peu à très démotivés à travailler dans la recherche.
Elles ont mis en ligne le résultat de ce sondage sur la plateforme de prépublication arXiv en fin de semaine dernière. « Nous avons beaucoup entendu parler de l’IA en mathématiques de la part de lauréats de la médaille Fields, de laboratoires spécialisés dans l’IA et de professeurs reconnus », expliquent-elles. En effet, 25 lauréats de la médaille considérée comme le prix le plus prestigieux dans cette discipline ont publié un texte sur le sujet. « Cependant, ce sont les chercheurs en début de carrière qui ont le plus à y gagner ou à y perdre », ajoutent-elles.
Au final, elles ont pu obtenir les réponses de 268 jeunes chercheuses et chercheurs en mathématiques, soit en thèse soit postdocs et travaillant dans une soixantaine d’universités (une majorité venant des États-Unis, mais elles ont reçu aussi des réponses du Canada, d’Inde, des Pays-Bas, d’Allemagne, d’Angleterre et de France). Une grande partie des personnes qui ont répondu fait de la recherche en maths fondamentales (165).
Elles signalent que la plupart des réponses ont été données avant qu’OpenAI inonde la recherche, en début octobre, avec 722 « prépublications » de mathématiques générées par IA. Et évidemment, comme elles le soulignent, cet événement a sans doute encore fait évoluer les rapports des jeunes chercheuses et chercheurs face à l’IA générative. Mais leurs résultats restent intéressants pour comprendre comment cette technologie touche ce milieu.
Trois quarts des jeunes mathématiciens démotivés par les effets de l’IA sur leur discipline
Il reste 72% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Mais une goutte d'eau dans l'océan de conférences douteuses publiées
Il y a six mois, des chercheuses et chercheurs signalaient avoir détecté plus de 1 800 actes de conférences scientifiques bidons dont les signatures avaient été achetées. L’un des principaux éditeurs, l’IEEE, vient d’annoncer la rétractation de plus de 1400 d’entre eux.
Fin avril, Next vous racontait l’histoire de chercheurs peu scrupuleux qui payaient des tiers pour publier des actes de conférences sans aucun sens dans des revues d’éditeurs parfois reconnus. Une bonne partie de ces articles viennent d’être rétractés par le principal éditeur en cause : l’Institute of Electrical and Electronics Engineers (IEEE). Cette association d’ingénieurs joue un rôle important dans l’élaboration de normes et publie chaque année plus de 200 autres revues scientifiques et actes de conférence. Les chercheuses et chercheurs qui ont fait le signalement il y a six mois se disent cependant contrariés par la manière dont l’association présente les choses.
Celle-ci a publié un communiqué la semaine dernière annonçant la rétractation d’ « environ 1 400 articles issus de la bibliothèque numérique IEEE Xplore, à l’issue d’une analyse approfondie ». « Les articles enfreignaient les principes de publication de l’IEEE, qui garantissent les normes les plus élevées en matière de qualité, de fiabilité et d’exactitude des publications scientifiques », ajoute l’éditeur qui affirme avoir mené une enquête après l’identification d’« irrégularités» par « une étude externe » dont il ne donne pas de détails.
1 417 rétractés en un jour, 1 622 rétractés en tout sur les 2 062 signalés
Selon le décompte de Miryam Naddaf, journaliste de la revue scientifique Nature, c’est plus précisément 1 417 actes de conférences qui ont été rétractés par l’IEEE le 23 octobre dernier. Et ceux-ci avaient tous été identifiés dans un article mis en ligne par les chercheuses et chercheurs Anna Abalkina, Marie Kunešová, Yagmur Ozturk et Solal Pirelli en avril dernier et que Next vous avait relayé. Leur article expliquait que certains chercheurs achetaient via des pubs sur Telegram ou LinkedIn la possibilité de signer ces actes de conférences, ce qui faisait augmenter leurs statistiques de publication.
De 1 800 faux actes détectés à l’époque, ces chercheuses et chercheurs en ont dénombré plus de 4 000 depuis, dont 2 062 rien que dans les actes publiés par l’IEEE. « Ces articles problématiques ont été co-signés par plus de 7 500 chercheurs issus de plus de 4 000 institutions réparties dans 56 pays », soulignent-ils dans la version de leur article mis à jour le 11 aout dernier.
Et si l’IEEE en a rétracté 1 417 le 23 octobre, en tout, l’éditeur a rétracté 1 622 des 2 062 signalés par Anna Abalkina et ses collègues, selon Nature qui a vérifié avec l’outil Problematic Paper Screener du chercheur toulousain Guillaume Cabanac, dont on vous parlait en 2022.
« Une goutte d’eau dans l’océan des conférences douteuses »
Pour Solal Pirelli, l’un des auteurs du signalement, « c’est un bon début, mais ce n’est qu’une goutte d’eau dans l’océan des conférences douteuses qu’ils publient chaque année », explique-t-il sur Bluesky. Il ajoute : « Ils doivent rétracter l’intégralité des actes dont le processus d’évaluation par les pairs a manifestement échoué, car les articles qui en résultent ne peuvent pas être qualifiés d’« évalués par les pairs ».
« Même si je me réjouis que l’IEEE ait commencé à retirer les articles que nous avions signalés, je suis un peu contrariée par leur communiqué officiel », affirme quant à elle Marie Kunešová, une autre chercheuse qui a participé au signalement. Elle se moque de la façon dont l’éditeur présente comment il a procédé pour filtrer les articles à rétracter :
« « Un éditeur de premier plan s’appuie sur une technologie de filtrage innovante et l’avis d’experts » ? C’est drôle, cette technologie ressemble beaucoup à : « si le titre correspond exactement à l’annonce, retirer ; sinon, ne pas retirer » ».
Dans un procès concernant la mise en place de mécanismes d’addiction visant les ados sur ses plateformes, des documents révèlent que Meta a réfléchi à un plan pour discréditer Jonathan Haidt, un des psychologues les plus critiques de l’entreprise.
À la fin de l’été dernier, Meta a accepté de verser 18 milliards de dollars pour mettre fin aux plaintes de quatre États américains l’accusant d’avoir rendu Facebook et Instagram addictifs pour les mineurs. Mais l’entreprise de Mark Zuckerberg n’en a pas pour autant fini avec ce sujet devant les tribunaux. Un des procès encore en cours montre que l’entreprise a essayé de contrôler le discours scientifique sur ses produits.
En effet, des documents montrent, comme l’a remarqué le média Law 360, qu’en 2023 l’entreprise avait en tête de cibler Jonathan Haidt, chercheur et enseignant à la Stern School of Business de l’université de New York. Celui-ci a écrit le livre Génération anxieuse (publié en anglais en 2024 et en français en 2025) et a ainsi fourni, selon le New York Times, « un texte de référence à une coalition en cours de formation visant à protéger les enfants contre les géants de la technologie, un collectif informel composé de parents soucieux de la sécurité de leurs enfants, d’adolescents exaspérés, de candidats potentiels à la présidence et de célébrités en quête d’une cause sociale « non controversée » ».
Une « Mission Haidt » au sein de Meta
Des notes prises durant une réunion de l’entreprise [PDF] montrent qu’une « mission Haidt » a été créée. Selon ces notes, le but d’un certain Curtiss (sans doute le vice-président « Recherche fondamentale et sciences appliquées » de Meta, Curtiss Cobb) est de trouver « Comment amener la communauté universitaire à désavouer Haidt ? ».
Après cette question, les notes prises dans cette réunion décrivent le fait que l’entreprise « ne peut pas les rallier à [sa] cause » et posent la question : « Alors comment faire pour les mettre en rage ? ». Elles continuent en expliquant que ce que l’entreprise essaye d’accomplir est plus une « campagne discrète » qu’une campagne médiatique. Et y est suggéré d’« amener Gellman à rédiger un article de démolition ».
Le nom de Gellman avec deux l ne correspond à personne de connu sur ce genre de sujets de recherche. Mais un autre chercheur au nom d’Andrew Gelman (avec un seul l) est un statisticien qui travaille aussi sur les sciences politiques à l’université de Columbia.
Andrew Gelman embarqué dans l’histoire à l’insu de son plein gré ?
Celui-ci avait publié en 2012 deux billets de blog (ici et là) critiquant le travail de Jonathan Haidt. Dans un nouveau billet de blog, Andrew Gelman a réagi à la publication de ces notes en affirmant : « Moi non plus, je ne sais pas vraiment qui est Gellman ! Mais je vais vous dire une chose : je n’ai jamais été contacté par qui que ce soit chez Facebook ou Meta au sujet de Jonathan Haidt ou de ses travaux ».
Tout en reconnaissant avoir reçu des financements de la part de Facebook (mais pas dans le cadre de ce sujet), il ajoute : « En toute sincérité, cette révélation concernant l’équipe de relations publiques de Facebook est tout simplement effroyable — il s’agit là de certaines des personnes les plus riches et les plus puissantes au monde qui s’entendent pour entraver le bon déroulement des processus scientifiques, journalistiques et juridiques — mais elle n’a rien de surprenant, compte tenu de ce que nous avons appris grâce à des témoignages d’initiés tels que Careless People ».
Selon Gizmodo, le livre Restoring Childhood du chercheur en psychologie au Boston College, Peter Gray, sorti en anglais en septembre dernier, s’emploie à réfuter la théorie de Jonathan Haidt sans qu’il n’ait besoin que Meta le pousse.
« La tech est le nouveau tabac »
Cailin O’Connor, chercheuse en philosophie des sciences à l’université de Californie à Irvine, en profite pour pointer à nouveau du doigt les méthodes de l’industrie du numérique par rapport à la recherche sur ses produits. Dans un billet titré « c’est désormais officiel : la tech est le nouveau tabac », elle estime que les procès comme celui dont il est question ici « soulèvent également des questions importantes et difficiles à trancher concernant la causalité. La santé mentale des jeunes est peut-être affectée, mais il est délicat de prouver que c’est l’utilisation des réseaux sociaux qui en est la cause ».
Elle ajoute que c’est pour ça que la science « revêt une importance capitale dans ces affaires ». Mais elle remarque que « c’est également la raison pour laquelle les industries qui fabriquent des produits nocifs ont tout intérêt à aider la science à répondre aux questions concernant ces produits ».
Et elle n’hésite pas à faire le lien entre cette affaire et les stratégies des industries du tabac et du pétrole pour nier la nuisance de leurs produits : « Nous savons tous comment l’industrie du tabac a réussi à retarder pendant des décennies l’émergence d’un consensus et la mise en place d’une réglementation sur les cigarettes. Nous savons également comment les secteurs du pétrole et du gaz continuent de se battre désespérément pour empêcher toute réglementation des combustibles fossiles ».
La chercheuse avait déjà participé à une étude qui dénonçait le problème du financement de la recherche sur le numérique en montrant que, dans près d’un tiers des articles scientifiques à propos des réseaux sociaux, l’information sur les liens d’intérêt n’est pas indiquée.
L’entreprise de Sam Altman continue de promouvoir la puissance de ses outils en les employant sur divers problèmes de recherche scientifique. Mais n’ayant pas les compétences en interne, elle cherche toujours à savoir comment rendre publique cette production sans trop fâcher la communauté scientifique.
Depuis le printemps, OpenAI comme Anthropic bandent les muscles en annonçant régulièrement des « découvertes » scientifiques. Ainsi, fin septembre, l’entreprise de Dario Amodei affirmait, elle, avoir découvert un nouveau système enzymatique, « dont la structure rappelle celle du système CRISPR » alors que tout le travail de recherche en biologie reste à faire pour démontrer ce qui n’est pour l’instant qu’une hypothèse.
Après avoir inondé la recherche avec 722 « prépublications » de mathématiques générées par IA, OpenAI vient encore d’annoncer sans prendre de pincettes « trois nouvelles découvertes en mathématiques, en informatique et en physique, portant respectivement sur l’analyse harmonique, la théorie de la complexité et la théorie quantique des champs ». Mais, encore une fois, les résultats n’ont pas été relus par des chercheurs.
Comme ces entreprises d’IA générative en ont pris l’habitude, c’est dans un billet de blog qu’OpenAI a fait l’annonce de ces « découvertes » scientifiques. Mais l’entreprise patauge encore dans sa façon de gérer le partage de ses résultats aux communautés de chercheuses et chercheurs qui travaillent parfois depuis des années sur les sujets auxquels elle s’attaque. Car, n’ayant pas d’employés capables de s’attaquer à tous ces sujets, elle se retrouve avec des problèmes qu’elle ne peut maitriser en interne. Ainsi, comme différents chercheurs nous l’ont souligné, ces résultats restent « la première étape d’une découverte scientifique, pas la dernière ».
Consultations de « guides » pour savoir quoi faire de ces « résultats »
La mise en ligne des 722 « prépublications » à différents stades de vérification ne semble pas être la solution miracle pour un partage serein avec les chercheurs. OpenAI tente donc encore une autre méthode. Elle indique faire appel à des experts externes qu’elle qualifie de « guides » (shepherds, en anglais), mais dont elle ne donne pas les noms.
Concernant le problème de maths dont elle affirme que ses modèles ont produit une preuve de sa résolution, OpenAI n’a contacté un expert que pour « discuter de la mise en place d’une collaboration autour de ce résultat », pas pour être conseillée sur la méthode de publication. Cet expert lui aurait recommandé de rendre publique sa production, comme avec les 722 « prépublications ».
OpenAI affirme que ses modèles ont « établi une preuve de la conjecture de lissage local dans toutes les dimensions et ont ainsi également résolu la conjecture de Kakeya et la conjecture de restriction de Stein dans toutes les dimensions ». En juillet dernier, la mathématicienne Hong Wang venait de se voir attribuer la médaille Fields notamment pour cette conjecture de Kakeya en dimension trois, comme l’expliquait le Journal du CNRS.
En informatique théorique et physique, des collaborations initiées avec certains chercheurs
En informatique, les travaux générés par OpenAI concernent une hypothèse de difficulté calculatoire : l’Exponential Time Hypothesis. L’entreprise soutient que cette hypothèse est « fausse ». Cette fois, un groupe d’experts (Russell Impagliazzo de l’UC San Diego, Ramamohan Paturi de l’UC San Diego et Ryan Williams du MIT) a accepté d’accompagner OpenAI dans la vérification de ces travaux, mis en ligne sur GitHub.
Ces trois chercheurs ont aussi publié une lettre adressée à leur communauté : « Notre implication ne doit pas être interprétée comme une validation de cette affirmation. Un résultat d’une telle importance nécessite un examen minutieux et indépendant, ainsi qu’une compréhension que d’autres puissent reproduire, remettre en question et développer ».
Sur la publication de ces travaux, OpenAI est cependant accusée – une nouvelle fois – de mauvaises pratiques scientifiques en s’appuyant sur des travaux d’autres chercheurs sans les citer et en les prenant de vitesse sans réellement maitriser ce qu’elle fait.
Le mathématicien Levent Alpöge, qui travaille pour Anthropic et qui avait déjà pointé ce genre de problèmes concernant OpenAI et les maths, a expliqué sur X que son confrère Ethan Sussman de l’université Northwestern avait beaucoup avancé sur le sujet et partagé ses résultats avec la communauté. « Je n’ai cessé de lui répéter de ne pas se montrer trop déférent et modeste, car on lui volerait la vedette à la première occasion. Au lieu de le contacter pour collaborer avec lui, comme cela a été suggéré publiquement à maintes reprises, les responsables d’OpenAI ont choisi de procéder ainsi », explique-t-il. Anthropic a depuis mis en ligne les travaux sur le sujet générés avec ses modèles.
Enfin, du côté de la physique, les documents générés n’ont pas été rendus publics. L’entreprise affirme, par contre, que ce serait « une démonstration mathématiquement rigoureuse de l’existence de certaines théories quantiques des champs en interaction, comprenant des champs de jauge et des fermions en quatre dimensions, notamment la chromodynamique quantique (QCD) et une formulation unifiée du Modèle standard de la physique des particules ». Ici aussi, OpenAI a listé les chercheurs avec lesquels elle allait collaborer : David Gross (prix Nobel 2004), Michael Douglas, Arthur Jaffe, Igor Klebanov et Nikita Nekrasov.
Comme elle le souligne, ces annonces s’ajoutent à sa volonté, ainsi que celle d’Anthropic, de s’afficher comme les futurs financeurs de la recherche mondiale, alors que ces entreprises sont encore loin d’être seulement à l’équilibre.
Avec la mise en place de « mémoires » pour que leurs systèmes donnent des réponses plus proches de la réalité, les entreprises d’IA génératives ont mis en place ce que des chercheuses et chercheurs appellent des « autoportraits algorithmiques » des utilisatrices et utilisateurs. Ceux-ci incorporent énormément d’informations (notamment psychologiques) considérées comme des données personnelles par le RGPD.
Les chatbots IA sont entrés dans notre quotidien alors qu’ils ne s’appuyaient que sur des modèles de langage, mais OpenAI et ses concurrents y ont ajouté depuis une mémoire qui permet des réponses plus adaptées et hyperpersonnalisées. Des chercheuses et chercheurs ont montré que cette mémoire posait de nouvelles questions concernant les données personnelles. Cela touche notamment des informations d’ordre psychologique.
C’est une équipe notamment issue du Max Planck Institute for Software Systems qui a travaillé sur cette question. Le chercheur Abhisek Dash et ses collègues ont présenté leurs travaux titrés « The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT » lors d’une conférence scientifique de l’Association for Computing Machinery à Dubaï en avril dernier.
La mémoire est beaucoup plus intrusive que les données récupérées par les autres plateformes
Si, depuis, OpenAI a modifié le fonctionnement de la mémoire de son chatbot, les questions restent pertinentes et les résultats montrent que les entreprises d’IA génératives n’ont pas créé leurs systèmes en y faisant particulièrement attention.
« La mémoire [des chatbots IA] donne naissance à ce que nous appelons l’ « autoportrait algorithmique » – une nouvelle forme de personnalisation issue des informations que les utilisateurs révèlent d’eux-mêmes au cours de conversations privées », expliquent ces chercheurs.
« Si la mémoire permet des échanges plus cohérents, les processus sous-jacents à sa création restent opaques, ce qui soulève des questions cruciales concernant la sensibilité des données, l’autonomie des utilisateurs et la fidélité du portrait qui en résulte », préviennent-ils.
Pour mieux comprendre ces mécanismes, ils ont analysé, en février 2026, 1 058 conversations avec ChatGPT, totalisant 22 971 échanges, dont 2 050 requêtes ont déclenché des mises à jour de la mémoire.
Ils notent déjà que la plupart de ces mises à jour ne sont pas enclenchées par l’utilisateur. Ainsi, « seuls 4 % des souvenirs de notre ensemble de données analysé sont initiés par les participants, tandis que les 96 % restants sont déclenchés unilatéralement par ChatGPT ». « Une telle asymétrie flagrante dans les schémas de mise à jour des souvenirs témoigne d’une capacité d’action supérieure du système d’IA dans la construction de la mémoire conversationnelle, par opposition à un contrôle exercé par l’utilisateur », commentent-ils.
En analysant ces « souvenirs » gardés en mémoire par ChatGPT, les chercheurs ont remarqué que 28 % d’entre eux contiennent des données personnelles comme définies par le RGPD et 7 % appartenant à des catégories particulières de données à caractère personnel. Pour 91 % des utilisateurs, cette mémoire avait recueilli des données personnelles et pour plus de la moitié (54 %) des données sensibles.
Concernant les données psychologiques des utilisateurs, les chercheurs font remarquer une différence entre les plateformes numériques traditionnelles et les chatbots. Ainsi, les premières collectent des données démographiques, le comportement, l’historique des likes et des partages, les commentaires ou encore les interactions pour en déduire les centres d’intérêt des utilisateurs.
« À l’inverse, les systèmes d’IA conversationnelle tels que ChatGPT construisent leur mémoire directement à partir des récits que les utilisateurs leur confient eux-mêmes », remarquent-ils, « ces souvenirs vont souvent au-delà des éléments factuels, reflétant certains aspects de l’univers intérieur de l’utilisateur ».
En mémoire sont aussi intégrés la façon de penser ainsi que les sentiments
Et de fait, ils ajoutent que les « souvenirs » du chatbot concernant ses utilisateurs montrent qu’elle peut « non seulement enregistrer l’identité de l’utilisateur, mais aussi sa façon de penser et ses sentiments ».
Pour analyser ces nouvelles données collectées par les plateformes comme ChatGPT, cette équipe de chercheurs s’est appuyée sur le concept de théorie de l’esprit (Theory of Mind, en anglais, ToM), utilisé en psychologie. Ce concept correspond à la capacité à inférer des états mentaux à autrui, comme des croyances, des désirs, ou des intentions, comme l’expliquent [PDF] les chercheuses et chercheurs en neurosciences et neuropsychologie.
En classifiant avec GPT-4o les « souvenirs » enregistrés par ChatGPT, ils se sont ainsi aperçus, par exemple, que 73 % d’entre eux exprimaient un désir et 16 % une intention. Dans les données qu’ils ont analysées, les « souvenirs » retenus par ChatGPT de 97 % des utilisateurs comprenaient des informations sur leurs désirs, 68 % sur leurs intentions et 52 % sur leurs connaissances.
En utilisant leurs données, les plateformes traditionnelles peuvent répondre à la question « de quel genre de personne s’agit-il ? ». Mais ChatGPT et les services du même genre, avec leur mémoire, pourraient se rapprocher encore plus de la réponse à la question « qui est cette personne ? ».
Abhisek Dash et ses collègues soulignent que cela « soulève de graves préoccupations en matière de sécurité et de vie privée ». Ils expliquent travailler sur un outil appelé « Attribution Shield » qui alerterait les utilisateurs de la présence éventuelle de souvenirs sensibles et leur proposerait des prompts alternatifs pour protéger l’anonymat des personnes concernées tout en préservant leur utilité.
Depuis la publication de leur recherche, OpenAI a modifié la façon dont fonctionne la mémoire de ChatGPT. Depuis juin, celle-ci synthétise les informations collectées petit à petit et les met à jour de façon continue plutôt que de compiler les « souvenirs » de manière individuelle. Et les utilisateurs peuvent accéder à un résumé, mais OpenAI souligne dans sa FAQ sur l’outil que « cela n’inclut pas nécessairement tous les détails ou toutes les sources » auxquels son outil de mémoire peut avoir accès. Il n’en reste pas moins que les informations qui peuvent y être stockées restent les mêmes que celles analysées par les chercheurs dans cette étude.
La mission spatiale japonaise Martian Moons eXploration doit décoller ce soir du Japon en direction de deux satellites de Mars : Phobos et Déimos. Elle doit déposer sur le premier le rover Idefix développé notamment par le CNES.
L’agence spatiale japonaise Jaxa s’apprête à lancer, ce soir et depuis l’île de Tanegashima (Japon) sa mission MMX (Martian Moons Exploration) à bord d’une fusée H3. Celle-ci a pour but de connaitre un peu mieux la planète rouge en allant observer ses deux satellites que sont Phobos et Déimos. Et même de rapporter des échantillons provenant du premier !
Une origine mystérieuse de ces satellites
Si elle réussit, ça sera la première mission scientifique à rapporter des échantillons venant de Mars. Rappelons que les États-Unis ont décidé, en début d’année, d’abandonner les échantillons recueillis sur Mars par le rover Perseverance : la mission Mars Sample Return a été tout bonnement annulée.
Concernant MMX, l’avenir du projet reste au beau fixe. La JAXA propose de suivre le lancement ce soir sur sa chaine YouTube. Comme nous l’expliquions déjà il y a 9 ans, l’idée principale est donc de faire un aller-retour vers Mars avec une escale sur Phobos.
Comme le souligne le Journal du CNRS, l’idée d’aller explorer Phobos s’explique aussi parce que l’origine des deux satellites de Mars reste mystérieuse : « Il y a deux théories, résume Patrick Michel, astrophysicien et directeur de recherche CNRS à l’Observatoire de la Côte d’Azur. Phobos et Déimos ressemblent à des astéroïdes, et auraient ainsi pu être capturés par la force d’attraction gravitationnelle de Mars. Mais leur trajectoire paraît bien étrange. Il pourrait donc s’agir du résultat d’un impact géant, mais ce n’est pas ce que nous montrent les observations sur sa composition pour l’instant. »
L’agence spatiale japonaise prévoit d’abord un voyage d’une année pour arriver aux alentours de Mars. Sa sonde amène avec elle neuf instruments, dont le spectromètre à neutrons et rayons gamma baptisé MEGANE développé par la NASA et MIRS, un spectromètre imageur infrarouge développé par le Laboratoire d’Etudes Spatiales et d’Instrumentation en Astrophysique (LESIA) en partenariat avec le CNES. MIRS doit « permettre de caractériser la composition minéralogique de la surface des lunes de Mars et l’analyse de l’atmosphère martienne. Il va permettre de participer à la sélection des sites d’atterrissage de MMX », explique le CNES.
Observer, récupérer 10 g et revenir
Car l’idée est ensuite de récupérer des informations sur Phobos pour connaître sa topologie et chercher des dizaines de sites d’atterrissage potentiels pour déterminer le meilleur endroit pour s’y poser.
Ensuite, la mission doit envoyer son rover pour observer la surface du satellite de Mars. Ce rover s’appelle Idefix. Il a été développé par le CNES en collaboration avec le Centre allemand pour l’aéronautique et l’astronautique (Deutsches Zentrum für Luft- und Raumfahrt, DLR). Si vous voulez vous amuser à en imprimer une copie, le CNES a même partagé les plans.
Si tout va bien, Idefix pourra ensuite donner des indications à la sonde principale de la mission pour qu’elle puisse à son tour atterrir sur Phobos. Elle y collectera 10 g d’échantillons pour qu’ils soient analysés plus tard sur Terre. Après quelques observations supplémentaires sur Phobos, MMX passera par le deuxième satellite de Mars, Deimos, pour l’observer aussi, puis repartira des environs de Mars en 2030. La JAXA espère récupérer tout ce beau monde en 2031.
Après la baisse des budgets de la recherche en France, la Cour des comptes plaide pour une baisse du nombre d’unités mixtes de recherche (UMR), ces laboratoires dans lesquels organismes de recherche et universités mettent des moyens en commun au service d’un même projet scientifique. Au risque de raviver la colère dans le milieu contre ce que l’ancien PDG du CNRS avait appelé les « key labs ».
La Cour des comptes acte que les gouvernements successifs français n’ont pas augmenté le budget de la recherche en France (public et privé) de manière à ce qu’il atteigne l’objectif longtemps planifié de 3 % de PIB. Dans un rapport sur les unités mixtes de recherche (UMR), la juridiction administrative en profite pour remettre sur l’établi le projet des « key labs » que le gouvernement et le PDG du CNRS de l’époque, Antoine Petit, avaient abandonné début 2025 après le mouvement de défiance qu’il avait suscité au sein de l’organisme.
La juridiction administrative, dirigée depuis février par l’ancienne ministre de l’Action et des Comptes publics Amélie de Montchalin, a publié récemment un rapport [PDF] sur les unités mixtes de recherche (UMR), une organisation « sans équivalent au monde » mise en place en France dans les années 1960 pour créer des laboratoires communs entre universités et organismes de recherche comme le CNRS (l’organisme qui y est de fait le plus impliqué), l’Inria, l’Inserm ou encore le CNES, par exemple.
L’exécutif a abandonné l’ambition d’un budget de la recherche important
La Cour des comptes y constate que la France « ne consacre que 2,18 % [chiffre 2023] de son PIB à la recherche, alors que six États de l’Union européenne, dont l’Allemagne, atteignent l’objectif de 3 % fixé dans le cadre de la stratégie de Lisbonne ».
Il reste 71% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.