❌

Vue lecture

Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Lumière !
Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Microsoft a publié les préversions de deux nouvelles technologies liées au ray tracing : Clustered Geometry et PTLAS. Elles promettent l’allègement des calculs liés à la lumière dans bon nombre de scénarios, avec des gains parfois significatifs.

Pour comprendre les améliorations proposées, il faut d’abord parler du ray tracing – ou lancer de rayons – pour comprendre le problème.

Ce lancer de rayons simule le trajet de la lumière. Pour chaque pixel, le GPU envoie des rayons et cherche ce qu’ils touchent dans la scène. Cette technique permet de produire des reflets, ombres et éclairages nettement plus réalistes que les méthodes précédentes. Les jeux compatibles avec le ray tracing ont souvent mis en avant cette fonction, dont on sait qu’elle est vorace en puissance de calcul.

La difficulté, en effet, est que la scène contient généralement des millions de triangles, utilisés pour la composition des objets 3D. Tester chaque rayon émis sur chaque triangle en temps réel est impossible.

La carte graphique s’appuie donc sur un résumé de la scène, que l’on nomme « structure d’accélération », dans laquelle les objets sont rangés dans des boites, elles-mêmes rangées dans d’autres boites. Par exemple, une fenêtre appartient à une maison, qui appartient à un quartier, qui appartient à une ville. Ce classement est important, car il permet d’écarter d’un coup tout ce qu’un rayon ne peut pas toucher. Le résumé dispose en outre de deux étages : le bas décrit chaque objet en détail, tandis que le haut décrit la scène complète, donc où se trouve chaque objet.

Où se situe le problème alors ? Dans le mouvement ! Dès que la scène bouge, tout se complique. Un personnage qui marche, un arbre agité par le vent ou autre oblige à recalculer une partie du résumé, parfois à chaque image. Dès qu’une scène devient très détaillée, ce travail de réorganisation peut couter plus cher en calculs que le lancer de rayons lui-même. Pour éviter que les GPU n’arrivent plus à suivre la cadence (donnant des performances exécrables), de nombreux jeux calculent les reflets et autres éléments sur la base d’objets simplifiés.

Ce que Microsoft a présenté

Le 28 octobre, Microsoft a donc lancé deux nouvelles technologies en préversions. L’entreprise présente ces évolutions comme les plus importantes pour DXR (DirectX Raytracing) depuis son lancement en 2018.

La première se nomme Clustered Geometry. Au lieu de construire d’une traite le résumé d’un objet, on le découpe en paquets contenant un maximum de 256 triangles, à la manière de briques de construction. Chacune est préparée une seule fois, puis réutilisée et assemblée selon les besoins. Quand un objet change de niveau de détail (par exemple quand le personnage s’approche), il n’y a pas de reconstruction, le GPU assemblant d’autres briques déjà prêtes. Et pour les objets qui se déforment, comme des personnages animés ? Microsoft prévoit des gabarits, selon le même fonctionnement : la forme des briques est préparée à l’avance, seule leur position étant mise à jour.

La seconde est appelée PTLAS, pour Partitioned Top-Level Acceleration Structures. Pour l’étage haut (donc le descriptif de la scène complète), la scène est découpée en zones. Dans une scène 3D, si une caisse tombe par exemple dans un coin, seule cette zone est mise à jour, le reste étant conservé à l’identique d’une image à l’autre. Les objets qui bougent sans arrêt peuvent être mis à part pour ne pas forcer l’actualisation de toute leur zone.

Dans les deux cas, une autre amélioration est liée : le GPU peut décider de lui-même de ce qu’il faut reconstruire. Un changement de taille, car c’est le CPU qui s’occupe aujourd’hui de préparer une bonne partie de ces opérations. Avec Clustered Geometry et PTLAS, il n’y a presque plus d’allers-retours entre le GPU et le CPU, soulageant d’autant ce dernier.

Précisons quand même que l’idée n’est pas nouvelle : elle vient de NVIDIA. La firme au caméléon propose actuellement ces techniques sous l’appellation RTX Mega Geometry. Gears of War: E-Day est d’ailleurs le premier jeu à l’exploiter. Cependant, sa « standardisation » (en quelque sorte) dans DirectX rend ces techniques utilisables par les autres GPU, ce qui change la donne.

Pour qui ?

L’un des avantages de cette approche est que ces techologies ne réclament aucun nouveau matériel. En théorie, Clustered Geometry et PTLAS sont compatibles avec un très grand nombre de GPU existants.

En résumé, pour l’instant :

  • NVIDIA : toutes les cartes GeForce RTX
  • AMD : les Radeon RX 9000
  • Intel : les Arc série B et certains processeurs Core Ultra récents
  • Qualcomm : les Snapdragon X2 (pilotes attendus au premier semestre 2027)

Techniquement, il suffit que les entreprises concernées mettent à jour leurs pilotes pour profiter de ces améliorations. Chacune devra déterminer quelles cartes seront compatibles. Par exemple, il n’y a aucune information sur le support des Radeon RX 7000, il faudra donc attendre pour en savoir bien.

Bon, et les performances alors ?

Commençons par la mauvaise nouvelle : oui, il est nécessaire que les éditeurs de jeux rendent leurs titres compatibles avec ces techniques pour en profiter. Il n’y a donc aucun jeu prenant en charge Clustered Geometry et PTLAS aujourd’hui, et il faudra attendre que les entreprises concernées s’expriment sur le sujet.

La bonne nouvelle maintenant : le gain peut être significatif, voire… gigantesque. Dans une démonstration de Microsoft sur une Radeon RX 9070, la scène passe de 1,2 à 79 images par seconde, et la mémoire vidéo consacrée au sommaire de la scène tombe d’environ 7,3 Go à 774 Mo.

Cette multiplication des performances par 66 a fait le tour du web ces derniers jours. Et pour cause, on n’a pas souvent l’occasion de voir de tels gains. Mais calmons tout de suite les espoirs, sans les doucher : il s’agit d’un cas extrême, mis en avant par Microsoft pour illustrer le potentiel de ses deux techniques. Ensuite, la comparaison est faite avec le pire scénario possible, c’est-à-dire une reconstruction complète à chaque image. Comme on l’a vu précédemment, les développeurs ont déjà des astuces pour éviter ce type de scénario. Enfin, on n’a rien sans rien : la mémoire de travail nécessaire pendant la reconstruction augmente fortement, mais les autres gains permettent en théorie un bon compromis dans tous les cas.

Microsoft l’indique clairement dans son billet de présentation, il ne faut pas s’attendre à des gains d’une telle ampleur dans tous les jeux. Une démonstration plus réaliste, fournie par NVIDIA, met ainsi en scène des milliers de dominos qui tombent. La mise à jour de la scène passe de 2,88 ms à 0,79 ms par image, alors que le lancer de rayons lui-même devient légèrement plus lent. Le bilan reste positif, mais on est loin d’un facteur 66 (le nombre d’images par seconde passe de 116 à 125).

Même si les gains réels seront plus mesurés et limités aux titres exploitant le ray tracing, une hausse des performances sans changer de matériel est toujours appréciable. Les deux techniques laissent imaginer des mondes ouverts plus denses et plus animés en lancer de rayons, des reflets et des ombres plus fidèles au décor, et une consommation de mémoire vidéo moindre.

Enfin, notez que ces annonces se sont accompagnées d’une autre en parallèle : Advanced Shader Delivery, qui doit réduire les saccades dues à la compilation des shaders en livrant des shaders déjà compilés. La fonction est déjà prise en charge par AMD pour ses Radeon RX 7000 et 9000 dans les derniers pilotes. Chez Intel et NVIDIA, il faudra attendre une nouvelle mouture.

  •  

Google précise les contours de son datacenter à 10 milliards de dollars dans l’Indre

Castelroussis
Google précise les contours de son datacenter à 10 milliards de dollars dans l’Indre

Google et RTE ont ouvert la phase de concertation relative au projet de datacenter prévu sur la ZAC d’Ozans à Étrechet (Indre). Le dossier associé révèle les contours, le calendrier et les zones d’ombre de cette infrastructure censée mobiliser, à terme, 1,2 GW de puissance électrique sur 200 hectares, pour un investissement estimé à 10 milliards de dollars. Google espère démarrer les travaux de la première tranche dès 2028.

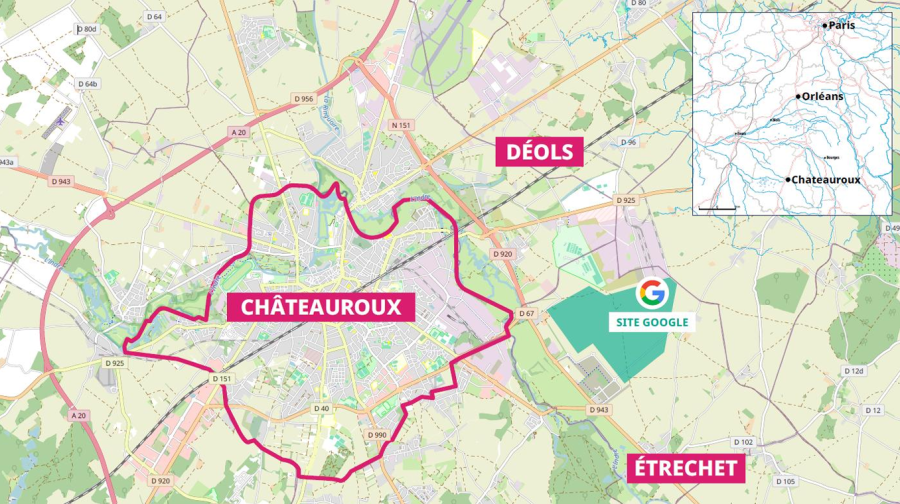
Initialement composée de terres agricoles et complémentaire de l’ancien terrain militaire de La Martinerie, la ZAC d’Ozans dans l’Indre (36) se prépare à accueillir ce qui constituera le premier datacenter opéré en propre par Google en France. Après avoir obtenu l’accord de la métropole de Châteauroux pour la vente d’un terrain de 195 hectares, le moteur de recherche vient, avec RTE, d’engager la phase de concertation publique. Organisée sous l’égide de la Commission nationale du débat public (CNDP), elle doit permettre d’échanger avec les différentes parties prenantes, à commencer par les riverains, pour faire accepter son projet et éventuellement en faire évoluer les contours.

Le site est aux portes de Châteauroux – crédit CNDP

Ouverte depuis le 2 novembre, cette phase de concertation prendra fin le 10 janvier 2027. Elle prévoit plusieurs réunions publiques organisée au cours des prochaines semaines dans les communes voisines du site retenu. Elle s’accompagne aussi, et surtout, de la publication d’un dossier (PDF) qui présente plus en détails les contours du futur datacenter et ses modalités de raccordement électrique.

Le document lève le voile sur le dimensionnement exact du projet, composé dans sa version la plus aboutie de huit bâtiments principaux et visant à terme une alimentation électrique de 1 300 MW. Il révèle aussi ce qu’anticipe, parfois sans le chiffrer précisément, le futur maître d’œuvre en matière d’impacts environnementaux et sociaux.

Visuel indicatif de la forme que pourrait prendre le datacenter de Google dans l’Indre – capture d’écran, dossier de concertation CNDP

L’ouverture de cette concertation intervient dans un contexte local déjà tendu : alors que des contestations s’organisent depuis plusieurs mois, notamment sous l’impulsion du collectif citoyen « Ozans dire non », plusieurs élus de la commune d’Étrechet, dont la maire Florence Laurent, ont démissionné mi-septembre pour dénoncer un projet « hors-norme qui échappe totalement à toute capacité de décision de la commune, tout en faisant peser des risques cumulés lourds sur notre territoire (ressource en eau, tensions sur le réseau électrique, nuisances, opacité des calendriers administratifs) ».

Si le dossier de Google présente des arguments susceptibles de lever certaines craintes exprimées par les opposants, notamment sur la ressource en eau, il risque aussi de donner du grain à moudre aux détracteurs du projet, entre gigantisme annoncé et questions laissées en suspens.

De 120 MW à 1,2 GW

Google justifie son projet par la nécessité d’accompagner le développement et le fonctionnement quotidien de ses services numériques en France et en Europe, évoquant aussi bien Gmail, YouTube ou Google Drive que l’intelligence artificielle, dont Gemini. Le site de la ZAC d’Ozans fait pour mémoire partie des des 55 « sites clés en main » identifiés par le gouvernement en 2024 dans le cadre du plan France 2030 comme les plus adaptés à l’implantation de centres de données de grande envergure.

Comme les porteurs du projet Campus IA à Fouju, Google évoque un déploiement par phases : le projet dans son ensemble doit permettre d’accueillir de six à huit bâtiments destinés à l’hébergement de serveurs, mais cet horizon est présenté comme conditionnel, avec un calendrier subordonné à l’évolution du marché et des usages.

Ce phasage est aussi contraint par les capacités actuelles du site. La ZAC d’Ozans est aujourd’hui en mesure de recevoir une alimentation électrique en 225 000 volts réalisée par RTE depuis des lignes à haute tension voisines. Cette dernière, complétée par un nouveau poste électrique public RTE construit dans la ZAC, doit permettre d’alimenter un premier bâtiment avec une puissance de raccordement chiffrée à 120 MW.

Le début de la construction de ce premier bâtiment, « d’environ 12 m de hauteur, 300 m de long et 100 m de large, sur un seul niveau » (soit 30 000 m²) est espéré dès 2028, pour une mise en service en 2030.


Il reste 62% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Nintendo, Sony, Xbox : les consoles ralentissent, les fortunes divergent

En attendant GTA VI
Nintendo, Sony, Xbox : les consoles ralentissent, les fortunes divergent

Les fortunes sont diverses pour les constructeurs de consoles. Les ventes de machines ralentissent, mais les jeux et les services permettent à Nintendo et Sony d’engranger de juteux bénéfices. Xbox est toujours à la peine, et la hausse des prix de la mémoire complique l’équation pour tout le monde à l’approche des fêtes.

Nintendo : les jeux prennent le relais après l’euphorie du lancement de la Switch 2

Après un lancement sur les chapeaux de roue, c’est le retour à une certaine normalité pour la Switch 2. Entre avril et septembre (premier semestre fiscal de Nintendo), 6,49 millions d’unités ont été vendues : c’est 37,4 % de moins par rapport à l’année précédente, alors que le lancement de la nouvelle génération de la console hybride battait son plein (PDF). Que les ventes s’essoufflent ainsi est assez logique, ce d’autant que les prix ont augmenté en septembre.

Durant la même période, la première génération de la Switch a enregistré un recul des ventes de 32,7 %, mais à un étiage encore élevé (1,27 million d’unités). Nintendo cessera de commercialiser ces modèles en Europe à partir du mois de février 2027.

En cumulé, la Switch 2 atteint 26,35 millions, contre 157,20 millions pour la Switch 1 ; le record de la PS2 (160 millions) est à portée. Nintendo maintient son objectif de 16,5 millions de Switch 2 écoulées durant l’exercice fiscal, qui s’achèvera fin mars 2027. Le lancement ce jeudi 5 novembre du remake d’Ocarina of Time devrait aider à vendre plus de consoles. Il le faudra, car cela représente tout de même 10 millions d’unités à vendre en six mois.

Crise de la mémoire aidant, Nintendo accumule les stocks de consoles dans ses entrepôts. Ils représentaient fin septembre 814 milliards de yens (4,5 milliards d’euros), soit 51 % de plus qu’à la fin mars 2026. L’entreprise ne précise pas les parts correspondant aux consoles, aux composants ou aux autres produits. Elle a également intégré à ses prévisions annuelles un surcoût de 100 milliards de yens (560 millions d’euros) pour faire face à la hausse des prix des composants et aux mesures douanières.

Le président de Nintendo, Shuntaro Furukawa, a expliqué que le constructeur était en mesure de s’approvisionner en quantités suffisantes, la situation sur le front de la mémoire n’ayant pas connu de « changement majeur », rapporte Reuters.

Le petit artisan de Kyoto accuse logiquement un recul du chiffre d’affaires de 12,1 % à 966 milliards de yens (environ 5,4 milliards d’euros). Fort heureusement, l’entreprise peut compter sur les ventes de jeux qui progressent sur toutes les consoles :+ 18,8 % pour la Switch 2 (24,49 millions de copies),+ 6,8 % pour la Switch 1 (65,73 millions de copies). À noter : la part du dématérialisé dans les ventes de jeux a augmenté de 6,2 points pour atteindre 60,7 %. Les revenus tirés du numérique ont progressé de 60,5 %.

Nintendo bénéficie d’un mix de ventes plus équilibré : alors que les revenus issus du matériel pesait 73,2 % des revenus l’an dernier, le ratio est aujourd’hui de 54,5 %. Autrement dit, les jeux (sur lesquels les marges sont plus importantes) prennent davantage de place. Durant son premier semestre fiscal, le groupe affiche un bénéfice d’exploitation en forte hausse (+ 49,1 %), à 216,5 milliards de yens, environ 1,2 milliard d’euros. Il ne faudrait toutefois pas oublier les 300 millions de dollars reçus au premier trimestre fiscal au titre du remboursement des tarifs douaniers de Trump.

La situation est moins brillante quand on regarde les chiffres du deuxième trimestre : le bénéfice d’exploitation recule en effet de 16 % à 73,9 milliards de yens (410 millions d’euros).

Sony : moins de PS5, mais davantage de bénéfices

Malgré les polémiques, Sony a enregistré un très bon deuxième trimestre fiscal (de juillet à fin septembre). Le groupe a en effet écoulé 2,6 millions de PS5 (PDF), un volume en retrait de 35 % par rapport à l’an dernier… mais avec des prix toujours plus élevés, cela reste une performance.

Le constructeur peut remercier GTA VI dont le lancement le 19 novembre pousse de nombreux joueurs à finalement investir dans une console. Sony se rapproche du seuil psychologique des 100 millions de PS5 vendues depuis le lancement de la console (97,9 millions fin septembre). L’effet GTA combiné aux fêtes de fin d’année devrait donner un sérieux coup de pouce à l’entreprise.

Les ventes de consoles ont donc reculé, ce qui n’empêche pas une forte progression (+ 83 %) du bénéfice d’exploitation de l’activité « Jeux et services réseau » de PlayStation à 220,1 milliards de yens (environ 1,2 milliard d’euros). Attention, la comparaison avec l’année précédente est en trompe l’œil : Sony avait alors enregistré des charges exceptionnelles, notamment liées à la dépréciation de la valeur du studio Bungie. Sans ces charges, le bénéfice d’exploitation n’augmente « que » de 29 %, ce qui reste évidemment très solide.

Le chiffre d’affaires de cette activité s’établit à 1 208 milliards de yens (6,8 milliards d’euros,+ 9 %), soit 35 % des revenus totaux de Sony. En tout, l’entreprise a enregistré des revenus de 3 429 milliards de yens (19,3 milliards d’euros), en progression de 10 %, pour un bénéfice d’exploitation de 622 milliards de yens, soit 3,5 milliards d’euros (+ 45 %). Sony a d’ailleurs relevé de 6 % ses prévisions pour PlayStation, signe que le groupe voit l’avenir en rose.

Comme Nintendo, Sony est évidemment touchée de plein fouet par la crise de la mémoire. L’entreprise s’est voulue rassurante : « pour le prochain exercice fiscal, les discussions menées jusqu’à présent avec différents fournisseurs nous ont permis de nous accorder sur les quantités nécessaires pour couvrir nos prévisions de ventes de consoles. » Elle compense la hausse des prix par des ajustements sur les promotions et les tarifs, ainsi que par des réductions de coûts. Sony prévoit ainsi de maintenir, sur l’exercice en cours, une rentabilité du matériel comparable à celle de l’exercice précédent.

Xbox limité par l’approvisionnement

Du côté de Microsoft, bon dernier sur le marché des consoles de salon, les résultats de la division Xbox pour le premier trimestre fiscal de l’entreprise ne sont guère reluisants. Le chiffre d’affaires, à 5,3 milliards de dollars, recule en effet de 2 % par rapport à l’an dernier.

Le constructeur américain ne donne plus depuis longtemps le nombre total d’unités vendues. Microsoft ne détaille pas non plus les montants des revenus pour les activités « contenus et services » et pour le matériel, mais indique tout de même qu’elles reculent de respectivement 2 % et 14 %.

Tout cela n’est guère glorieux, mais Asha Sharma, la directrice générale de Xbox, veut voir le verre à moitié plein. Elle rappelle ainsi que le chiffre d’affaires de sa division avait reculé de 10 % au précédent trimestre. Surtout, « les ventes de consoles restent limitées par l’approvisionnement : la demande dépasse les quantités disponibles », affirme-t-elle.

  •  

Compression lz4 1.11 : nous avons testé les performances de cette version « majeure »

Plus on est de threads, plus on rit
Compression lz4 1.11 : nous avons testé les performances de cette version « majeure »

lz4 1.11 permet de paralléliser le traitement des données pour augmenter les performances. La 1.10 le permettait déjà, dans certains cas. Quels gains ? Quelles différences entre les deux versions ? Next vous explique tout, tests et chiffres à l’appui.

Le dépôt GitHub officiel de cet algorithme de compression présente cette mise à jour 1.11 comme « majeure » avec l’intégration de plus de 850 commits. « Sa fonctionnalité principale est la compression multithread, désormais directement intégrée à la bibliothèque. Cette version est également nettement plus rapide sur les petites données, notamment avec des dictionnaires, et inclut un grand nombre de corrections pour certains scénarios ».

lz4 vs liblz4 : les différences, les changements dans la 1.11

Si vous avez un peu suivi lz4, vous avez certainement déjà remarqué que la version 1.10, disponible depuis juillet 2024, prenait déjà en charge les multicœurs pour optimiser les performances. Quoi de neuf alors dans la 1.11 mise en ligne plus de deux ans après la précédente mouture ?

Les développeurs en charge du projet rappellent que, en effet, « la version 1.10.0 a introduit la compression multithread dans la ligne de commande lz4, mais les applications utilisant liblz4 n’en bénéficiaient pas ». Désormais, l’API lz4frame de liblz4 peut aussi profiter du multithreading (via le paramètre LZ4F_preferences_t.nbWorkers), bien qu’en mode expérimental pour le moment. Cette API est notamment utilisée pour des intégrations de lz4 dans des applications.

Des gains réels avec la version 1.11

Afin de voir les différences, de comprendre le fonctionnement et de tester plus largement les optimisations de lz4 1.11, nous avons relancé une série de tests sur notre protocole maison. Il comporte pour rappel 11 catégories de données, allant des images aux fichiers CSV en passant par des MP3, des PDF, du « vrac », etc. Les fichiers sont compressés individuellement avec un traitement depuis un disque virtuel créé en mémoire vive pour ne pas dépendre des performances du stockage.

Avant d’entrer dans les détails, voici les grandes lignes de la conclusion de nos tests. lz4 en version 1.11 avec sa commande de base permet de gagner jusqu’à 15 % de vitesse. Mais c’est évidemment l’API lz4frame (via liblz4) qui profite pleinement de la version 1.11 avec des performances multipliées jusqu’à x9 grâce au multithreading.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Les Big Tech’ sacrifient leurs employés humains pour investir dans les infrastructures IA

Une telle engeance sacrificielle...
Les Big Tech’ sacrifient leurs employés humains pour investir dans les infrastructures IA

Les entreprises états-uniennes de la tech’ ont licencié plus de 230 000 personnes en 10 mois, contre un peu plus de 200 000 pour tout 2025. Nombre d’entre elles ne le sont pas tant parce qu’elles seraient remplaçables par des IA, mais parce que leurs employeurs sont désespérément en quête de cash, et donc d’économies, pour trouver les milliards de dollars requis par leur course à l’IA.

« On ne peut pas construire l’avenir de l’IA sans les scientifiques et les ingénieurs qui travaillent sur ces technologies fondamentales », déplore Jay Sujay Bagi auprès du Figaro. Titulaire d’un doctorat obtenu au MIT, il fait partie des milliers d’employés à avoir récemment été licenciés dans la Silicon Valley. Pas parce qu’il aurait été remplacé par une IA, mais parce qu’elle a siphonné ses budgets de recherche :

« J’ai le sentiment d’avoir été touché indirectement par l’IA, sans que l’IA ait remplacé mon travail. En clair, je suis un dommage collatéral. »

Il fait partie d’un groupe Discord de 1 700 membres surnommé (un)PTO, pour « unpaid time off » (congés non payés), où ils échangent offres d’emplois, recommandations et conseils et qui se retrouvent aussi à randonner sur les collines de Berkeley. « La plupart des gens pensent que l’IA nous prend nos emplois. Je ne crois pas que ce soit ça », plussoie Basem Istanbouli, remercié par Google en janvier 2025 et inventeur de ces randonnées :

« Pour rester dans la course à l’IA, les entreprises dépensent des milliards de dollars par an. Où trouver cet argent ? Il faut supprimer de la masse salariale. »

Dans un second article, Le Figaro revient sur l’impact macroscopique de l’IA dans cette « annus horribilis » pour l’emploi dans la tech américaine : Microsoft (un plan de 60 000 départs volontaires, soit 1 salarié sur 4 !), Oracle (près de 30 000, 18 % de ses employés), Amazon (19 800), Dell (16 000), Block (4 000)…

En 2026, le tracker de licenciements de skillssyncer.com a dénombré au total 567 plans de licenciements touchant 232 946 personnes, soit en moyenne environ 756 suppressions d’emplois par jour. À titre de comparaison, pour l’ensemble de l’année 2025, il avait dénombré 338 licenciements touchant 205 773 personnes, soit une moyenne de 564 suppressions d’emplois par jour.

Les grandes entreprises tech se retrouvent en première ligne des bouleversements qu’entraînent l’IA sur l’emploi. D’une part parce qu’elles en sont les premières utilisatrices et qu’elles les intègrent plus tôt que les autres.

233 000 licenciements en 10 mois, contre 206 000 pour tout 2025

D’autre part parce que « ces départs traduisent un arbitrage devenu central : financer des investissements massifs, notamment dans les centres de données et la puissance de calcul, tout en maintenant la discipline sur les coûts », explique à nos confrères Diego Ferri, associé IA chez EY.

Les investissements sont tels que la trésorerie disponible chez Google, Meta et Amazon ne suffit plus, et qu’ils ont dû commencer à s’endetter et à lever de nouveaux capitaux sur les marchés. Or, ces levées de fonds ne suffisent pas non plus à réunir les centaines de milliards de dollars nécessaires, ce qui explique aussi ces licenciements. Mark Zuckerberg a d’ailleurs reconnu avoir coupé dans les effectifs pour financer ces investissements.

« Son plan de départs volontaires est une décision très calculée et une façon de faire un peu nouvelle », souligne Stéphane Roder, associé chez Wavestone, au Figaro : « Il s’allège d’une partie de ses dépenses opérationnelles pour les transformer en dépenses d’investissement. Il est tellement certain que l’IA va transformer son modèle qu’il se donne les moyens d’y aller à fond ».

Le gouverneur de Californie, Gavin Newsom, a quant à lui promulgué le 30 septembre deux lois inédites : l’une interdit de licencier sur la seule foi d’un algorithme, l’autre oblige à signaler dans les préavis les suppressions de postes dues à l’IA.

  •  

☕️ Discord travaille sur des clients natifs pour les ordinateurs


Discord travaille à se débarrasser d’Electron pour son client « desktop », à destination de Windows, macOS et Linux. La rumeur courait depuis un moment, mais Stanislav Vishnevskiy en personne, cofondateur et directeur technique de l’entreprise, l’a confirmé sur X.

Son message s’accompagne d’ailleurs d’une capture, montrant le processus « Discord Phoenix » (nom de code de cette future mouture) et sa consommation de 290 Mo de mémoire vive. On remarque d’autres éléments, dont probablement un clin d’œil à Steam et ses 856 Mo consommés, l’application de Valve utilisant des technologies web.

Ce changement est attendu de pied ferme, car Discord peut consommer jusqu’à plusieurs Go de mémoire. Nous l’évoquions fin septembre, quand l’arrivée d’un mode jeu avait été révélée par le compte Discord Previews. La différence pourrait donc s’avérer énorme, libérant une grande quantité de RAM au profit des jeux, Discord étant souvent associé aux plaisirs vidéoludiques.

Dans son message, Stanislav Vishnevskiy indique que la nouvelle application sera intégralement en Rust, langage que l’entreprise utilise déjà pour différents composants. L’interface sera bâtie avec GPUI, un framework accéléré matériellement par le GPU pour Rust. Dans des réponses données sous son tweet d’origine, on apprend également que l’application aura exactement la même apparence qu’aujourd’hui, que le support de Linux devrait en être amélioré et qu’une version web continuera d’exister, Discord abandonnant l’actuel JavaScript pour du WebAssembly (Wasm).

Enfin, Stanislav Vishnevskiy espère que cette nouvelle version sera « bientôt » proposée en test aux utilisateurs. Le responsable n’en parle pas, mais il s’agira probablement du canal Canary de l’application.

  •  

Microsoft veut décidément convaincre sur les performances de Windows 11

Ram, ram, rameurs ramez...
Microsoft veut décidément convaincre sur les performances de Windows 11

Microsoft l’assure encore : Windows 11 consomme moins de mémoire vive. Ce serait surtout le cas pour les machines dotées de 8 Go de RAM, dans un contexte toujours plus tendu de pénurie et d’explosion des prix. Bien que la communication ait une visée marketing, l’entreprise assure que les efforts se poursuivent.

2026 doit marquer un tournant dans l’histoire de Windows 11. Microsoft communique abondamment depuis le début de l’année sur un effort général et profond autour de son système, afin de répondre aux critiques. L’éditeur aura pris le temps de la réflexion, depuis la commercialisation de son produit en octobre 2021.

Comme le rappelle notamment Windows Central, la sortie du MacBook Neo et de ses 8 Go de mémoire a mis en lumière les défaillances de Windows dans ce domaine. Le système est accusé d’être lent, peu réactif, un ogre vorace en mémoire aux interfaces bâties sur des technologies web et pénible à utiliser. Avec les tensions croissantes sur la mémoire vive et la NAND (dans les SSD), et probablement sous pression des constructeurs qui aimeraient lancer des configurations plus chichement équipées, Microsoft devait réagir. D’autant que Windows 11 demande officiellement 4 Go de mémoire pour fonctionner.

Trois axes d’amélioration

Dans son billet du 3 novembre, Microsoft commence par indiquer qu’une mémoire pleine n’est pas en soi un problème : les données et applications se tiennent prêtes dans un certain contexte, qui peut évoluer à mesure que les besoins changent au cours de la session. « Le vrai test est de savoir si votre PC reste réactif, pas de la quantité de mémoire inutilisée », affirme l’entreprise.

Trois leviers sont quand même mentionnés pour les améliorations de ce mécanisme. La compression des données d’abord, pour réduire la taille des informations moins utilisées. La fonction existe depuis des années, mais elle a été retravaillée pour les configurations à 8 Go, a priori pour être plus agressive. En conséquence, Windows 11 peut garder jusqu’à 2 Go de données actives supplémentaires en mémoire, réduisant les chances qu’un onglet ou une application ait besoin d’être complètement rechargé.

Microsoft indique ensuite avoir donné la priorité aux interactions, surtout les principales comme le menu Démarrer, le clic droit, la recherche, les paramètres, l’Explorateur ou encore l’outil Capture d’écran. Autant de composants qui répondraient jusqu’à 20 % plus vite, sans que Microsoft ne détaille sa méthode de calcul. Le système sait mieux suspendre certaines activités quand la machine est sollicitée par l’utilisateur, par exemple l’indexation.

Un mécanisme de lancement accéléré a également été mis en place, dont Edge est la première application à profiter. Le gain de temps peut grimper jusqu’à 33 %, mais il est de 15 % en moyenne. Microsoft ajoute que ce mécanisme est ouvert aux applications tierces. À propos d’Edge, le navigateur met désormais en veille les onglets après 15 min par défaut, contre 2 heures jusqu’à présent.

Enfin, Microsoft travaille sur les applications courantes. Dans des scénarios multitâches impliquant Windows, Edge et la suite Office, les gains observés grimpaient jusqu’à 900 Mo, dont jusqu’à 360 Mo pour Office. L’éditeur explique que les améliorations viennent aussi bien de la manière dont la mémoire est gérée et de comment elle est utilisée par les applications, mais sans donner plus de détails.

Les éditeurs tiers doivent eux aussi profiter de ces améliorations, en théorie. Microsoft cite l’exemple du client WhatsApp pour Windows, qui aurait constaté un gain à deux chiffres, là encore sans plus de précision. Drôle de choix d’ailleurs, car cette application est probablement l’une des pires en matière d’efficacité : WhatsApp a mis fin à son application native et a basculé sur des technologies web, avec une consommation oscillant entre 1 et 3 Go de mémoire. À moins de besoins spécifiques, la version web du service fera largement l’affaire.

La route sera longue

La fin du billet mentionne plusieurs autres améliorations en préparation. Par exemple, une compression des données en mémoire « encore plus intelligente et efficace ». Plus intéressant, il y a un travail en cours pour qu’un plus grand nombre de fonctions et d’applications partagent des éléments communs, avec moins de chargements en mémoire à la clé. La recherche et les widgets devraient ainsi partager un seul moteur web. Idem pour OneDrive et Photos, même si on ignore s’il s’agit là encore d’un moteur web ou d’autres composants.

D’autres chantiers sont en cours, dont la progression du framework natif WinUI 3 pour un nombre croissant d’applications. Microsoft dit également être en discussion avec les fabricants de PC et de puces pour « optimiser » la quantité de mémoire que le matériel réclame pour fonctionner. L’éditeur affirme enfin travailler avec des développeurs tiers pour « aider leurs apps à utiliser plus efficacement la mémoire ».

Toutes ces informations manquent cependant de précision. Les notes en bas de page montrent que les gains observés sont souvent basés sur un faible nombre de machines et dans des cas favorables. Il ne semble pas y avoir pour l’instant de tests indépendants. Si le mouvement de fond va dans le bon sens, il est donc difficile de savoir aujourd’hui dans quelle mesure ces améliorations sont efficaces.

Ce billet comporte en outre une dimension marketing très claire. D’une part, il se termine justement par des offres sur des PC peu onéreux, comme une offre à 429 dollars chez Walmart. D’autre part, il est évident que Microsoft travaille au successeur de Windows 11. Le système ayant agacé par de nombreux aspects depuis sa sortie, l’éditeur doit redorer son image avant d’avoir un nouveau produit à vendre.

Ce point est loin d’être anodin. La fin précipitée de Windows 10 (même si l’Europe a un traitement de « faveur »), le passage forcé à Windows 11, l’expérience utilisateur moyenne, la montée en puissance de Linux ou encore l’agacement engendré par la prolifération des outils IA sont autant de facteurs à prendre en compte. Si « Windows 12 » n’est pas suffisamment attirant, la question d’une bascule vers un autre environnement se posera d’autant. Microsoft a donc tout intérêt à continuer le travail sur ce que l’on attend d’un système d’exploitation : performances, fiabilité et sécurité.

  •  

GTA VI peut-il casser Internet ?

Titre certifié conforme à la loi de Betteridge
GTA VI peut-il casser Internet ?

La question parait certainement saugrenue aux spécialistes, mais elle se pose néanmoins pour le grand public. Réponse courte et directe : non. Par contre, du côté de Microsoft et de Sony, de grandes manœuvres sont certainement en cours pour se préparer à une déferlante de joueurs.

La franchise a des dizaines de millions de fans, qui attendent avec impatience ce sixième volet. Depuis 2013, date de lancement de GTA V, l’éditeur Take-Two a écoulé plus de 225 millions d’exemplaires du jeu sur pas moins de trois générations de consoles. Au total, la franchise s’approche des 500 millions.

Notre scénario : le pire du pire

Grand Theft Auto VI promet d’exploser les compteurs. Vous allez le voir, nous allons souvent prendre le pire scénario (avec des chiffres ronds pour nous simplifier la vie).

L’éditeur ne communique pas sur le nombre de précommandes, mais elles seraient de plus de six ou sept millions selon les estimations. Selon certains experts repris par des confrères, le jeu pourrait atteindre jusqu’à 50 millions d’exemplaires dès sa première semaine d’exploitation, selon un scénario déjà très optimiste (la fourchette est entre 37 et 51 millions précisément).

Quel rapport avec « casser Internet » ? GTA VI promet d’être un mastodonte : il faut libérer pas moins de 212 Go en prévision du préchargement du jeu, qui n’existe qu’en dématérialisé. Rockstar précise que « les versions boîte avec code pour les deux consoles devraient être disponibles au retrait auprès des revendeurs à partir du 12 novembre ». La sortie est programmée pour le 19 novembre.

Disons que le jeu fasse 250 Go et prenons une hypothèse tout de même très (très) optimiste de 50 millions de joueurs « day 1 ». Nous prenons le haut de la fourchette et sur un seul jour, soit le pire scénario possible.

Cela donnerait pas moins de 12 500 000 000 Go à télécharger le 19 novembre, soit 12 500 000 To ou encore 12 500 Po. C’est ce chiffre qui pourrait faire « trembler » Internet. Est-ce vraiment le cas ? Calculons !

Trafic mondial annuel d’Internet en 2025 sur le fixe : 7 300 Eo…


Il reste 76% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Mode sombre adaptatif, onglets verticaux, Siri AI : Apple sort Safari de sa torpeur

Dans la jungle, terrible jungle
Mode sombre adaptatif, onglets verticaux, Siri AI : Apple sort Safari de sa torpeur

Avec les prochaines versions d’iOS et de macOS, Safari s’offrira plusieurs nouvelles fonctions importantes : les onglets verticaux, un mode sombre adaptatif qui va mettre à la retraite plusieurs extensions, et une nouvelle dose de Siri AI.

Là où les éditeurs de navigateurs web empilent les nouvelles fonctions et les modifications à toute vitesse, Apple a toujours conservé un train de sénateur pour Safari. La position privilégiée que le logiciel occupe dans les systèmes d’exploitation du constructeur lui permet de vivre une petite vie assez tranquille, loin de la frénésie de la concurrence.

Mais il arrive aussi parfois, au détour d’une mise à jour discrète, qu’Apple décide de faire soudainement un petit effort. La version 27.3 contient non pas une, pas deux mais trois nouveautés importantes ! Pour en profiter, il faudra au préalable télécharger et installer iOS 27.3, iPadOS 27.3 et macOS 27.3 . Oui, chez Apple, pour pouvoir utiliser une poignée de nouveautés dans un navigateur, il faut impérativement lancer les grandes manœuvres sur ses machines et les mettre à jour.

Ces nouvelles versions des systèmes d’exploitation sont actuellement proposées en bêta pour les développeurs. Sur Mac, avec un peu de chance, le constructeur livrera peut-être une version autonome de Safari 27.3 quand la mouture finale de macOS 27.3 sera disponible.

Un mode sombre pour les sites qui n’en ont pas

La première nouveauté est un mode sombre adaptatif, qui bascule la page web en mode sombre lorsque l’affichage du smartphone, de la tablette ou de l’ordinateur est lui-même en mode sombre. Bien sûr, les feuilles de styles des sites web peuvent adapter les couleurs de leurs pages en fonction du mode de la machine.

Mais ce n’est pas le cas de tous : en se basant sur des stats de Google, Apple relève que près de 40 % des pages sont chargées par des internautes ayant activé le mode sombre, mais seuls 10 % des chargements concernent des pages qui le prennent en charge.

Lorsque Safari 27.3 affiche un site web incompatible avec le monde sombre, il affiche en haut de page une invitation à activer le mode adaptatif. Attention, des éléments peuvent alors manquer de contraste, les couleurs peuvent paraître « différentes », et certains sites ne sont pas compatibles.

Apple explique que ce mode inverse la luminosité des couleurs tout en préservant leurs teintes : les fonds clairs deviennent sombres, et les textes foncés s’éclaircissent, avec un contraste d’au moins 4,5:1 pour assurer la meilleure lisibilité possible. Les dégradés clairs sont eux aussi assombris ; la plupart des images restent intactes, mais certaines icônes et logos au format SVG sont adaptés pour rester visibles.

Il n’existe pas d’option dans les réglages de Safari pour activer ou désactiver automatiquement cette nouveauté, il faut se rendre sur un site incompatible avec le mode sombre pour voir la notification. Cela pourra changer dans les prochaines versions.

Cette nouveauté risque de porter un coup fatal à plusieurs extensions qui se chargeaient déjà de la bascule forcée au mode sombre pour les sites web récalcitrants (comme Noir, par exemple).

Les onglets prennent la verticale

Deuxième grosse nouveauté de Safari 27.3 : les onglets verticaux. Sur Mac, iPad et sur l’écran interne de l’iPhone Duo (l’iPhone tout court n’y a pas droit), ces onglets se présentent sous la forme de leurs favicons dans un panneau à droite. Il est possible d’agrandir ce panneau pour révéler les noms des pages web. Les onglets peuvent être déplacés à la main, et supprimés.

Sur Mac, l’activation passe par le menu Présentation > Tab Layout > Vertical. Sur iOS et iPadOS, il faut se rendre dans les réglages de Safari et sélectionner la nouvelle option « Barre d’onglets verticale ».

Siri AI aux commandes

Apple ne pouvait décemment pas passer à côté de l’occasion d’intégrer un peu plus profondément Siri AI dans Safari. La version 27.3 du navigateur permet à l’assistant de gérer les onglets. Siri AI est par exemple capable de montrer tous les onglets (ou uniquement les onglets d’un site web) de fermer un onglet, d’afficher l’onglet qui parle d’un sujet spécifique, de dupliquer ou de fermer un onglet, ou encore d’organiser les onglets (par exemple « place les onglets de Next en premier »).

Siri AI est également en mesure d’effacer les données des sites et de l’historique, d’épingler des articles dans la liste de lecture (et d’afficher cette même liste). Cela fonctionne plutôt bien dans nos tests, et l’assistant demande régulièrement de confirmer une action. Mais malheureusement tout cela reste cantonné au Mac dans l’Union européenne. Siri AI n’est toujours pas disponible sur iPhone ou iPad dans l’UE.

  •  

SpaceX s’allie à Qualcomm pour bâtir le réseau 5G terrestre de Starlink Mobile

Les antennes de la discorde
SpaceX s’allie à Qualcomm pour bâtir le réseau 5G terrestre de Starlink Mobile

SpaceX assemble petit à petit les différents éléments qui permettront à Starlink de concurrencer réellement les opérateurs de téléphonie. L’entreprise a signé un partenariat avec Qualcomm pour équiper son futur réseau mobile terrestre aux États-Unis, dont le déploiement doit commencer en 2027.

SpaceX veut faire de sa filiale Starlink Mobile un véritable opérateur de téléphonie aux États-Unis. Actuellement, les satellites direct-to-cell peuvent transporter des messages et la voix directement aux smartphones compatibles, via des applications dédiées ; mais pour offrir un niveau de services comparable aux autres opérateurs, l’entreprise d’Elon Musk doit aussi s’appuyer sur des réseaux terrestres plus traditionnels – la connexion satellite passe mal à l’intérieur des bâtiments, elle est aussi sous-dimensionnée pour servir efficacement les utilisateurs dans les zones urbaines.

Des fréquences, mais encore un réseau à construire

C’est pourquoi SpaceX a acheté des fréquences auprès d’EchoStar l’an dernier (dans la bande des 2 GHz), puis un portefeuille de basses fréquences début octobre (dans celle des 800 MHz). Il faut également une infrastructure au sol, notamment des antennes, pour la couverture des zones très peuplées. Les acteurs qui se partagent le gros du marché américain, à savoir AT&T, Verizon et T-Mobile, voient logiquement ce potentiel concurrent d’un mauvais œil ; c’est pourquoi aucun d’entre eux n’a voulu donner à SpaceX un accès à son réseau.

Qu’à cela ne tienne, SpaceX a de la ressource. D’une part, le groupe envisagerait de passer par Boost Mobile, un opérateur hybride détenu par EchoStar : les discussions portent sur un rachat ou une négociation pour bénéficier de ses accords avec AT&T et T-Mobile. Cela reste hautement hypothétique, puisque ces accords ne sont pas transférables automatiquement.

Qualcomm pour équiper les futures antennes 5G

D’autre part, SpaceX a bien l’intention de construire son propre réseau terrestre. L’accord avec Qualcomm porte sur la fourniture de puces Dragonwing QRU100 et QDU100, ainsi que de logiciels de traitement du signal, pour équiper ses stations de base 5G. Le QRU100 prendra en charge les fonctions radio des antennes, tandis que le QDU100 assurera le traitement des signaux. L’ensemble doit permettre de gérer un grand nombre de connexions avec une consommation électrique réduite.

L’ambition de SpaceX est très claire : il s’agit de construire un réseau de téléphonie couvrant tous les États-Unis. L’entreprise prévoit de commencer à déployer son réseau à partir de l’année prochaine, « avec des dizaines de milliers de sites installés sur la durée de l’accord pluriannuel ».

Elon Musk a affirmé être en mesure de créer ce nouveau réseau dans les 2 à 3 prochaines années, tandis que Dan Schulman, le directeur général de Verizon, a estimé que l’opération prendrait « au minimum » de 4 à 6 ans.

  •  

☕️ Apple va contrôler les contenus partagés publiquement sur iCloud


Dans les prochaines versions 27.3 de ses systèmes d’exploitation, Apple vérifiera le contenu des liens partagés via iCloud quand l’option « Toute personne disposant du lien » est sélectionnée. Les partages limités à des personnes choisies ne sont pas concernés par ce contrôle.

L’entreprise explique que cet examen servira à détecter les contenus stockés sur iCloud qui sont préjudiciables, sans entrer dans les détails. Apple ne précise pas les méthodes de détection ni les catégories de contenus visées. Il pourrait s’agir de s’assurer que des fichiers malveillants ou des images pédocriminelles ne transitent pas par ce type de lien public.

Apple se réserve le droit de supprimer les contenus et pourra même prendre des mesures contre le compte Apple concerné, ce qui peut aller jusqu’à la désactivation du compte, le blocage de création d’un nouveau compte avec l’adresse email ou le numéro de téléphone associé, voire alerter les forces de l’ordre si nécessaire.

Apple ajoute que le contenu partagé avec l’option « Toute personne disposant du lien » n’est plus chiffré de bout en bout – logique, puisque le constructeur doit pouvoir y jeter un œil –, même si le propriétaire ou les correspondants ont activé la protection avancée des données. Cette fonction annoncée fin 2022 étend le chiffrement de bout en bout aux sauvegardes iCloud.

Les documents partagés avec des correspondants choisis demeurent chiffrés de bout en bout. Les systèmes d’exploitation concernés, iOS 27.3, iPadOS 27.3, macOS 27.3 et visionOS 27.3, sont entrés dans leur cycle de bêta test.

  •  

Vague démocrate aux États-Unis : quels effets sur le secteur de la tech ?

Da ba dee da ba di
Vague démocrate aux États-Unis : quels effets sur le secteur de la tech ?

La victoire démocrate aux États-Unis est claire, tant sur la Chambre des représentants que sur le Sénat. Que signifie la prise du pouvoir au Congrès pour le secteur de la tech ? S’il est encore trop tôt pour établir des prévisions sur l’ensemble de l’industrie, un domaine en particulier va être rapidement concerné : l’IA.

Les pronostics semblaient clairs depuis des semaines, mais la victoire des démocrates est pour le moins éclatante à l’issue des midterms américaines. Ces élections se produisent pour rappel à mi-mandat du président élu et lui sont généralement défavorables. Dans le cas présent, le désaveu pour Donald Trump est cinglant, puisque les démocrates vont contrôler les deux chambres du Congrès, qui appartenaient toutes deux aux républicains jusqu’à présent. Le changement se fera officiellement en janvier.

Comme le signale notamment Reuters, le président américain paye la guerre déclenchée contre l’Iran le 28 février, la flambée des prix des carburants ou encore, de manière générale, le coût de la vie dans le pays. Reuters cite un sondage en sortie des urnes, selon lequel 75 % des personnes interrogées ont indiqué être « en colère » ou « insatisfaites » de la direction prise par les États-Unis. 70 % ont également dit souhaiter un rôle renforcé du Congrès sur le contrôle de l’exécutif.

Ces élections ont également une caractéristique particulière : le secteur de la tech, tout particulièrement l’intelligence artificielle, a joué un rôle. Les entreprises concernées vont devoir s’adapter.

Désaveu pour les milliardaires de la tech

Si l’on en croit CNBC, le scrutin est un désaveu des milliardaires de la tech. Les démocrates auraient ainsi pris le Congrès sur fond de mécontentement face aux prix, à la corruption, mais aussi face à la construction des centres de données pour l’IA. Des datacenters dont l’installation est devenue hautement politique ces derniers mois.

Toujours selon CNBC, le Texas concentre une grande partie des projets prévus. La nouvelle gouverneure Gina Hinojosa a fait campagne pour suspendre les nouveaux projets jusqu’à l’adoption de règles plus strictes, autrement dit un moratoire.

Business Insider et TIME s’intéressent de leur côté à Elon Musk, premier donateur du cycle électoral, avec au moins 446 millions de dollars, dont la moitié pour le seul Texas via des super PAC alliés, sans pour autant empêcher l’État de basculer. Un changement conséquent d’ailleurs, puisque non seulement le Texas n’avait pas eu de gouverneur démocrate depuis 1988, mais le nouveau sénateur élu, James Talarico, l’emporte avec 10 points d’avance sur son adversaire Ken Paxton.


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Le CNRS continue son ménage anti-GAFAM, sa messagerie migre vers Partage de Renater

Ils vont l'utiliser maintenant ?
Le CNRS continue son ménage anti-GAFAM, sa messagerie migre vers Partage de Renater

Le CNRS vient de souscrire à la plateforme de messagerie Partage de Renater. L’organisme de recherche affiche ainsi une volonté de « gagner en souveraineté numérique ». Les 50 000 boites emails de l’organisme doivent maintenant être gérées par le même service qu’une bonne partie des établissements de l’enseignement supérieur français.

Après avoir officiellement annoncé en début d’année l’abandon des licences Zoom au profit de l’utilisation de l’outil Visio de la Suite Numérique de la Dinum, le CNRS veut s’afficher « souverain » concernant la gestion des boites emails de ses agents.

La direction du CNRS, qui a changé de PDG en juin, veut continuer la « démarche de sortie des GAFAM » déjà amorcée et « plus particulièrement sa sortie de Microsoft » affirme-t-elle dans un communiqué [PDF].

Départ d’une solution Exchange hébergée chez un prestataire

Les emails du CNRS étaient jusque-là gérés via le logiciel Exchange de Microsoft et hébergés chez un prestataire externe (sur lequel l’organisme ne donne aucune information).

C’est maintenant avec la solution du logiciel libre Zimbra qu’ils seront traités. De fait, le CNRS se plie aux choix techniques du GIP Renater car il utilisera sa solution nommée « Partage » qui s’affiche comme un « service de messagerie collaborative » s’appuyant, entre autres, sur Zimbra.

En février, le directeur de Renater, Boris Dintrans, mettait en avant, dans une interview pour Next cette solution. Parmi les acteurs du numérique de l’enseignement supérieur et la recherche français, « on est les seuls à proposer 850 000 boîtes mails via notre solution Partage », nous expliquait-il. « Elle est utilisée par 83 établissements. Nous avons aussi un antispam qui protège Partage, mais aussi les établissements qui ne sont pas sur Partage avec 3,5 millions de boîtes mails protégées. Sur le volet messagerie, ce qu’on fait est unique ».

Dans le communiqué annonçant cette migration, Boris Dintrans se réjouit : « Accueillir le CNRS sur PARTAGE, c’est permettre de sécuriser les données scientifiques en s’appuyant sur un logiciel libre et sur l’ensemble de nos infrastructures en propre (datacentres et réseaux de communication) ». Il ajoute que la roadmap de Partage « vise 1,5 million d’utilisateurs d’ici 2027, un déploiement rendu possible notamment par la mise en production d’un nouveau stockage objet permettant [à Renater] de monter en puissance sans compromettre la souveraineté des données ».

Économie annoncée de 3,5 millions d’euros par an

Côté CNRS, on met aussi en avant « l’optimisation des coûts informatiques ». Sans dévoiler ni l’offre choisie chez Renater ni le prix global que paye l’organisme de recherche au GIP, le CNRS affirme que « cette migration permet également de réaliser des gains financiers, de l’ordre de 3,5 millions d’euros par an ». Cela lui permet aussi de mettre l’étiquette à la mode de la « souveraineté » en arguant que l’hébergement de Renater est « 100% français ».

L’organisme explique qu’il y avait 50 000 boites mails à migrer, en comptant celles des 35 000 agents du CNRS mais aussi les boîtes partagées et de service. Reste à savoir si les agents du CNRS vont en profiter pour s’approprier cette messagerie. En effet, les chercheurs du CNRS qui sont intégrés aux UMR ont souvent pris l’habitude d’utiliser les boites mails fournies par les autres tutelles et n’utilisaient l’email @cnrs.fr que pour communiquer avec leur administration interne.

Certains nous font déjà remonter que, même si le changement vers une solution plus souveraine leur semble aller dans le bon sens, l’application web se bloque quand la page est restée ouverte trop longtemps, qu’il est impossible d’envoyer des pièces jointes avec les calendriers partagés ou encore que la synchronisation avec Thunderbird est trop complexe.

  •  

☕️ Meta réduit la voilure en France : un tiers des effectifs visé par un plan de départs


Meta voudrait se séparer d’un tiers de ses effectifs en France. Le géant des réseaux sociaux s’apprêterait en effet à lancer un plan de départs volontaires dans le cadre d’une rupture conventionnelle collective négociée depuis juillet, selon La Lettre. Le groupe emploie 300 salariés au sein de sa branche française : le plan concernerait donc jusqu’à une centaine de postes.

Ce plan de départs serait la concrétisation pour la France de la vague de licenciements annoncée fin août par Meta, touchant 8 000 salariés (soit 10 % des effectifs mondiaux). On a échappé au pire : à l’origine, Mark Zuckerberg avait imaginé se passer de 60 % du personnel de son entreprise.

Dans l’Hexagone, Meta proposerait des conditions de départs de 2,15 mois de salaire par année d’ancienneté et un congé mobilité de dix mois (rémunéré à hauteur de 80 % du salaire brut). De quoi peut-être attirer des candidats. Comme le rappellent Les Échos, 88 salariés avaient quitté Meta France lors d’une précédente rupture conventionnelle collective en 2023 (la filiale comptait alors 350 salariés).

Le groupe s’est engagé dans une course folle à l’IA depuis plusieurs années, occasionnant une restructuration en profondeur et des réassignations de postes (7 000 annoncées mi-mai) pour réduire les couches de management et améliorer la productivité.

Dans son manifeste pro-IA, Mark Zuckerberg avait assuré que cette technologie allait provoquer une « abondance d’emplois à l’avenir » : « Il y a bien davantage d’entreprises et de services utiles à créer que ce que les gens sont aujourd’hui en mesure de réaliser », affirmait-il.

« La taille des entreprises pourrait diminuer, comme cela a été le cas lors du passage des géants industriels aux entreprises technologiques. Mais cela ne signifie pas moins d’emplois au total. Cela suppose un plus grand nombre d’entreprises, chacune employant moins de personnes. »

Les promesses d’abondance d’emplois n’engageant que ceux qui y croient, pour le moment il faudra faire avec leur attrition.

  •  

☕️ [MàJ] Le Crédit Mutuel Arkéa victime d’une cyberattaque


Mise à jour 20 h – Le Crédit Mutuel Arkéa a publié de nouveaux détails sur la cyberattaque dont l’établissement a été victime. D’abord, l’entreprise dément que les pirates soient passés par Fortuneo : « Les attaquants sont passés par la plateforme d’un de nos prestataires et ont ainsi atteint le Crédit Mutuel Arkéa directement. » Nous avons donc changé le titre de cet article en conséquence.

La banque précise le mode opératoire de l’attaque. Les attaquants ont utilisé un compte propre de Crédit Mutuel Arkéa pour « réaliser des transactions vers d’autres acteurs bancaires, qui leur ont ensuite potentiellement permis de convertir cet argent en crypto monnaie via des plateformes spécialisées ». Aucun compte client des fédérations ou des filiales du groupe n’est concerné. Il ne s’agit pas d’une erreur humaine, mais d’« une attaque sophistiquée venant de l’extérieur ».

L’établissement réitère que l’incident n’a entraîné aucune conséquence sur les avoirs de la clientèle, simplement « une exécution différée de certaines opérations de virement » (ça va mieux en le disant). Quant au chiffre de 133 millions de dollars (118 millions d’euros) qui circule, le Crédit Mutuel Arkéa ne peut rien confirmer, mais « valide l’ordre de grandeur ».

Mise à jour 16h30 — Le préjudice se monterait à 133 millions de dollars, selon le chercheur en sécurité ZachXBT cité par The Block. L’enquêteur donne des détails : l’attaque aurait débuté le 1er novembre, les pirates ne seraient pas associés au groupe Lazarus de Corée du Nord.

Article d’origine, 15h07 – Le Crédit Mutuel Arkéa a été victime d’une cyberattaque, a confirmé l’établissement ce mercredi 4 novembre. Un incident « maîtrisé » qui a touché la filiale Fortuneo et qui n’a aucune conséquence sur les avoirs des clients, assure la banque.

La cyberattaque a permis de réaliser des opérations frauduleuses, selon le Crédit Mutuel Arkéa qui regroupe le Crédit Mutuel de Bretagne et le Crédit Mutuel du Sud-Ouest (PDF). Selon Le Figaro, ce sont les fonds propres de la banque en ligne Fortuneo qui ont été ciblés par des pirates. Les montants concernés sont encore en cours d’évaluation, mais l’établissement assure qu’« en tout état de cause pas de nature à remettre en cause la solidité et la santé financière du groupe. »

Illustration : Flock

L’incident a nécessité une suspension temporaire de certaines transactions pour sécuriser les opérations et prévenir tout mouvement frauduleux, détaille l’entreprise. Il est « clos et maîtrisé », et les opérations sont en cours de reprise progressive depuis la matinée de ce mercredi. Le groupe et ses filiales ont réalisé les vérifications nécessaires et pris des mesures de « sécurisation renforcées ».

Le Crédit Mutuel Arkéa se veut rassurant : cette cyberattaque n’entraîne « aucune conséquence sur [les] avoirs » des clients, simplement une « exécution différée de certaines opérations de virement ». Conformément aux procédures standards, la banque a notifié les instances de supervision.

L’entreprise met en garde contre des tentatives d’hameçonnage et appelle ses clients à la plus grande vigilance : ils ne doivent jamais communiquer leurs informations personnelles et bancaires. Elle recommande de contacter un conseiller pour confirmer l’authenticité d’un message.

  •  

Le NYTimes attaque Brave pour ses accords avec les entreprises d’IA et son option anti-paywall

Tout faire pour accéder aux contenus journalistiques sans les payer ?
Le NYTimes attaque Brave pour ses accords avec les entreprises d’IA et  son option anti-paywall

Le journal américain vient de déposer plainte contre Brave, l’accusant de passer outre son paywall pour vendre l’accès à ses contenus aux entreprises d’IA générative comme Anthropic, Perplexity, Mistral, xAI et Cohere. Accompagné d’autres médias, le New York Times cible aussi l’option « paywall blocker » et d’autres fonctionnalités du navigateur.

Le New York Times, suivi par d’autres titres de presse états-uniens, a déposé plainte devant la cour fédérale de Manhattan lundi 2 novembre contre l’éditeur du navigateur Brave.

Dans les deux documents très proches déposés devant la justice (un premier PDF ici et un autre là), ces médias pointent le « rôle central » de l’entreprise de Brendan Eich concernant la copie et la distribution de leurs articles copyrightés aux utilisateurs de son navigateur mais aussi aux entreprises d’IA génératives les plus en vue du marché.

Brave vendrait un accès aux articles sous paywall via une API

« Brave est le fournisseur, le revendeur et le distributeur de contenus copyrightés et obtenus illicitement, destinés à ses propres utilisateurs ainsi qu’à bon nombre des plus grandes entreprises spécialisées dans l’IA générative, notamment Anthropic, Perplexity, Mistral, xAI et Cohere », écrivent-ils.

Les entreprises de presse estiment, dans leur plainte, que Brave a engrangé plus de 100 millions de dollars en copiant et revendant leurs articles. Pour elles, Brave a pivoté et changé de modèle en monétisant son index de pages web scrapées.

D’une part, en déployant sa fonctionnalité IA « Ask Brave », un bot IA comme tant d’autres, mais qui, selon les plaignants, permet « souvent » d’accéder à des verbatim de leurs textes ou à des résumés détaillés.

D’autre part, Brave propose une API via laquelle elle donne accès , toujours selon la plainte, à « une source illicite de contenus copyrightés dont elle ne possède pas les droits, y compris des contenus copyrightés appartenant aux éditeurs, à d’autres sociétés du secteur de l’IA ».

Les éditeurs de presse ciblent aussi les différentes options mises en place dans le navigateur de Brave pour permettre de lire les contenus de médias en passant outre leur paywall. Ainsi, ils citent l’option « Paywall blocker », qui activée, permet aux internautes de passer outre leurs paywalls, mais aussi le portail Brave News et les fonctionnalités de blocage de publicités incluses dans le navigateur.

Ils demandent que Brave soit empêché de continuer à proposer ce genre de fonctionnalité et de vendre l’accès de cette API aux entreprises d’IA générative mais aussi « la restitution intégrale de l’ensemble des recettes et bénéfices obtenus par Brave grâce à son système de substitution publicitaire, majorés des intérêts ».

Perplexity s’énerve

Interrogées par The Verge, Brave ainsi que la plupart des entreprises d’IA générative citées n’ont pas donné suite. Seule Perplexity a vivement réagi en affirmant que « le New York Times paie ses avocats trop cher et sous-paie ses journalistes. (Qui auraient pourtant facilement pu repérer les fausses informations contenues dans cette plainte) ».

ArsTechnica, qui a reçu la même réponse, affirme que la déclaration de Perplexity ne contient aucune information sur ces prétendues fausses allégations. Nos confrères rappellent cependant que l’entreprise est déjà attaquée par le New York Times dans une affaire engagée depuis décembre 2025 concernant la reproduction illégale d’articles copyrightés.

  •  

Une faille critique dans le noyau Linux permet de faire planter un serveur via TCP

Une poignée de mains et patatras
Une faille dans Alpine Linux permet de se connecter avec un mot de passe trop long

Une nouvelle faille critique a été découverte dans le noyau Linux. Avec un score CVSS de 9,8 sur 10, sa dangerosité frôle la note maximale, permettant une exploitation à distance. Selon la distribution utilisée, le correctif peut être disponible ou non.

Les distributions Linux reçoivent peu à peu de nouveaux noyaux contenant un correctif pour la faille estampillée CVE-2026-98432. La situation est très variable selon les systèmes, Red Hat ayant publié de nouveaux noyaux par exemple, alors que chez Canonical, les correctifs pour Ubuntu restent pour l’instant cantonnés au dépôt de test, sans date de publication générale. D’autres encore ont réglé le problème au cours des deux dernières semaines.

La faille est connue publiquement depuis le 15 octobre. Elle est présente dans le noyau Linux depuis sa version 4.4, qui remonte à une dizaine d’années.

Deux cœurs pour une même mémoire

Pour comprendre comment fonctionne la faille, rappelons d’abord quelques bases. Lorsqu’un serveur accepte une connexion TCP, il échange d’abord trois messages avec le client : le client demande l’ouverture (SYN), le serveur accepte (SYN-ACK), puis le client confirme (ACK). Pendant cet échange, le serveur garde en mémoire certaines informations envoyées par le client, les options IP.

Tant que l’échange n’est pas terminé, le noyau Linux range ces informations dans une fiche provisoire (demande en attente). À la réception du dernier message (ACK), il crée la fiche définitive de la connexion. Au lieu de recopier les options IP dans cette nouvelle fiche, il se contente d’y noter leur emplacement en mémoire. Les deux fiches désignent alors la même zone mémoire, et la fiche provisoire peut encore être utilisée.

On peut voir venir le problème. Il survient quand deux cœurs du processeur travaillent en même temps, soit un scénario très commun sur n’importe quel serveur aujourd’hui. Si le client renvoie sa demande de connexion, un cœur peut être en train de lire ces informations pour y répondre, tandis que l’autre vient de les effacer en fermant la connexion. Le premier lit alors une mémoire qui ne lui appartient plus et qui peut tout à fait avoir été réaffectée à un autre processus. Ce mécanisme peut être exploité, la faille étant donc de type use-after-free (utilisation de mémoire après libération).

S’il veut déclencher ce conflit et donc exploiter la faille, le pirate n’a pas besoin de compte. Il lui « suffit » d’envoyer des demandes de connexions contenant certaines options IPv4 peu utilisées (comme Record Route ou Timestamp) vers n’importe quel port TCP ouvert. Les connexions IPv6 ne sont pas concernées.

De fait, le correctif à appliquer est simple : il impose au noyau d’attendre que plus personne ne lise les informations en mémoire avant de les effacer.

La gravité de la faille ne fait pas consensus

Officiellement, le score CVSS est bien de 9,8. Et pour cause : l’exploitation se fait avec un simple accès réseau, ne semble pas complexe, ne réclame aucun privilège particulier ni interaction côté victime, et l’impact potentiel sur la confidentialité, l’intégrité et la disponibilité est élevé. La faille peut en effet servir aussi bien à déclencher un plantage qu’à voler des informations.

Red Hat, dans sa fiche sur la vulnérabilité, considérait initialement cette faille comme « modérée », avec un score de 5,9. L’éditeur s’est pourtant ravisé, s’alignant sur la note de 9,8 et la considérant donc comme critique. Mais tous ne l’ont pas fait.

Chez AWS (pour sa distribution Amazon Linux) par exemple, on considère que la faille a un score de 8,1, ce qui la place dans la catégorie « importante ». Amazon considère que ce « problème entraîne principalement un plantage du système menant à un déni de service (DoS) ou une possible corruption de la mémoire ».

Canonical, dans son bulletin du 2 novembre sur la faille, reprenait directement la note de 9,8.

Qui est à l’abri ?

Comme indiqué, la situation dépend largement du système utilisé. Côté Ubuntu par exemple, si vous utilisez une mouture 26.10 à jour, aucun problème : le correctif est présent dans le noyau 7.3.0 - 10.10. En revanche, pour toutes les autres versions, il faut attendre ou installer un correctif pas tout à fait finalisé. Ubuntu 26.04, 24.04 et 22.04 peuvent ainsi puiser dans le dépôt -proposed pour des révisions des noyaux (respectivement les branches 7.0, 6.8 et 5.15). Pour les versions plus anciennes, le correctif est en préparation.

Sur Amazon Linux, le correctif a été distribué entre les 24 et 30 octobre, selon les versions. Pour Red Hat, on l’a vu, les correctifs sont également disponibles. D’autres distributions ont réagi plus tôt, notamment Debian, SUSE ou encore Oracle Linux, qui ont toutes reçu des correctifs durant la seconde moitié d’octobre.

La situation suffit en tout cas à justifier une mise à jour rapide. On parle tout de même d’un défaut accessible sans authentification sur tout port TCP IPv4 en écoute, présent depuis dix ans, avec au minimum un risque de déni de service et de fuite mémoire.

L’exécution de code à distance n’a été en revanche démontrée que par un seul acteur : Anthropic. Dans un billet du 27 octobre, l’entreprise a en effet indiqué qu’elle avait utilisé un modèle de recherche interne pour créer une chaine d’exploitation aboutissant aux droits root, dans des conditions particulières. Il ne semble pas pour l’instant que la vulnérabilité soit réellement exploitée, mais certains chercheurs évoquent désormais une activité a priori malveillante pour chercher les serveurs exposés.

  •  

☕️ L’Établissement français du sang touché par le piratage de certaines chambres froides


Après les frigos de plusieurs enseignes de supermarché en France puis en Europe, c’est maintenant les chambres froides de l’Établissement français du sang (EFS) qui ont été visées par un piratage.

Selon le Canard enchaîné, le prestataire de l’établissement public, Coolworld, a été ciblé par une cyberattaque dans la nuit de dimanche 1er novembre au lundi 2.

Coolworld est censé assurer la maintenance des chambres froides de l’établissement qui gère les centres de collecte de sang, plasma et plaquettes en France.

Mais, selon nos consœurs du palmipède, certaines chambres froides ont été programmées pour passer des - 30 °C prévus pour conserver des échantillons de donneurs à 110 °C.

Illustration : Flock

Interrogé par le Canard enchaîné, le ministère de la Santé rassure sur les conséquences du piratage : « Il y a zéro conséquence opératoire, car la situation a été repérée ».

Du côté de l’ESF, on explique qu’ « un technicien de permanence a constaté dans la nuit de dimanche à lundi une remontée en température dans les chambres froides », des échantillons d’un dispositif de veille sanitaire concernant la transfusion sanguine seraient concernés mais aussi du plasma congelé destiné à la transfusion.

Dans un communiqué, l’EFS précise que les installations de supervision et de pilotage de chambres froides déployées sur trois sites de l’EFS ont été touchées. Les systèmes de surveillance et d’alarme de l’EFS ont cela dit « permis d’identifier rapidement ces anomalies et de prendre les mesures nécessaires afin qu’aucun échantillon ou produit sanguin ne soit altéré » :

« Aucun impact sanitaire n’a été identifié et aucune perte de produits sanguins n’est à déclarer. Les produits conservés dans les équipements concernés, des poches de plasma destinées à la transfusion et des poches de plasma destinées au fractionnement pour la fabrication de médicaments, ont été transférés ou sécurisés. »

  •  

Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Le comite n'a pas contracté
Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Pour la première fois de son histoire, le langage C++ a échoué à réunir assez de votes au sein de l’ISO pour une nouvelle version. Le C++ 26 n’a pas été ratifié, faute d’un accord sur plusieurs points, dont le principal est le concept de contrat. Explications.

Le 23 octobre avait lieu le vote des organismes nationaux sur le projet de norme internationale (DIS). Le lendemain, Robert Seacord, qui dirige le comité du langage C à l’ISO, annonçait sur LinkedIn que le texte avait été désapprouvé, y évoquant un « jour triste pour la communauté C++ ».

Une première pour le C++

Pour être adopté, un projet doit réunir deux conditions. Il lui faut non seulement les deux tiers des voix des membres participants, mais les votes négatifs ne doivent pas non plus dépasser le quart des votants. Or, C++ 26 n’a obtenu que 12 voix sur 20, soit 60 %, alors que 14 étaient nécessaires. En outre, les votes négatifs ont atteint 9 sur 22, soit 41 %. Le projet C++ 26 a donc échoué sur les deux tableaux.

Selon Mateusz Pusz, membre du comité national polonais qui a consulté le résultat officiel, neuf pays ont voté contre : Danemark, Finlande, Iran, Italie, Japon, Luxembourg, Roumanie, Espagne et Suède. La France et l’Irlande se sont abstenues tout en adressant des commentaires techniques. La Pologne et les États-Unis se sont abstenus sans commentaires.

C’est la première fois qu’une nouvelle version du langage n’est pas normalisée par l’ISO. Pour Robert Seacord, aucune norme de langage n’avait jamais échoué à ce stade. Selon Daveed Vandevoorde, membre du groupe de direction du comité C++, c’est même encore plus significatif : aucun projet antérieur n’avait reçu un seul vote contre.

Au cœur des débats, les contrats

Le C++ 26 dresse une longue liste de nouveautés, parmi lesquelles les contrats. En développement, un contrat inscrit dans la déclaration d’une fonction ce qu’elle exige de son appelant et ce qu’elle garantit en retour. Il s’agit respectivement de la précondition et de la postcondition. Par exemple, une fonction de racine carrée peut exiger un nombre positif et promettre un résultat tout aussi positif.

Cette idée n’est pas nouvelle, comme l’indique le site Les Joies du Code. Le principe a été popularisé dans les années 1980 par l’informaticien français Bertrand Meyer avec son langage Eiffel. D’autres langages plus modernes, comme Ada et D, l’intègrent également. Le contrat figure dans la déclaration, à la vue de tous (aussi bien les appelants que le compilateur et les outils d’analyse). Pour ses défenseurs, il sert même de documentation qui ne peut pas devenir obsolète en silence.

Pour donner une idée de l’âge du sujet, le comité C++ travaille dessus de manière concertée depuis 2004, et une première version avait été proposée pour C++ 20, avant d’être supprimée en 2019. La version actuelle, présente dans la proposition de C++ 26 récemment refusée, avait pourtant reçu l’aval d’un sous-comité technique en février 2025, par 100 voix contre 14.

Alors que s’est-il passé ? En fait, si l’idée fait globalement consensus, sa conception divise. Dans C++ 26, le code source ne décide pas si un contrat est vérifié. Le texte définit quatre comportements possibles : ignorer la vérification, l’effectuer en signalant l’erreur sans s’arrêter, l’effectuer et arrêter le programme, ou l’arrêter immédiatement sans traitement intermédiaire.

Problème, le choix revient à l’implémentation, autrement dit à une option de compilation. Ainsi, une même règle écrite par le développeur peut donc être appliquée strictement, simplement signalée ou ignorée selon la manière dont le programme est construit. Dans son billet, Mateusz Pusz avait résumé ainsi la problématique : une assertion de contrat est-elle une vérification que la compilation peut supprimer, ou une garantie sur laquelle le programme peut compter ?

Deux camps irréconciliables

Sans surprise, les opposants reprochent la possibilité de désactiver les vérifications. Selon eux, cela revient à la pratique déjà connue de tester du code avec des contrôles puis à les supprimer en production. Ils préfèrent que ces vérifications soient toujours actives, ce qui aurait un coût estimé par Google à 0,3 %.

Ils lui reprochent également son inachèvement, car les contrats sur les fonctions virtuelles ont été repoussés à C++ 29. Dans ce camp, on retrouve notamment Bjarne Stroustrup, le propre créateur du C++. Il exprime son rejet des contrats sous cette forme depuis des années, comme l’indiquait The Register en mars dernier.

Pour les défenseurs en revanche, toutes ces critiques ont déjà reçu des réponses. Ils craignent également que le retrait ne repousse encore les contrats de plusieurs années. L’historique va d’ailleurs dans ce sens : après le retrait de C++ 20, il avait fallu six ans pour les remettre sur la table, dans une version plus modeste. En outre, ils reprochent à certains opposants d’avoir plaidé leur cause directement auprès des pays pendant le vote.

Et maintenant ?

D’abord, précisons qu’il y a peu de conséquences immédiates pour les développeurs. La situation est similaire avec les normes Wi-Fi : les compilateurs n’attendent pas la publication d’une norme pour implémenter un projet en cours de travail. Le vote ne modifie pas non plus ce qu’ils proposent déjà. Par exemple, la version 16 de GCC (sortie en avril) prend en charge les contrats à titre expérimental (avec l’option -std=c++ 26). Clang ne les intègre pas encore en revanche.

Quelle suite à présent ? Le comité WG21, le groupe de travail de l’ISO chargé du langage C++, doit se réunir à Búzios, au Brésil, du 16 au 21 novembre 2026. Il devra répondre à chacun des commentaires nationaux (que l’on ne peut pas consulter) et recommander une marche à suivre.

De là, il peut y avoir quatre possibilités : un projet révisé soumis à un nouveau vote de huit semaines, un nouveau projet de comité soumis à commentaires, une publication comme spécification technique, ou l’abandon pur et simple. Le président du SC22, sous-comité de l’ISO chargé des langages de programmation, devra choisir parmi les trois premières. Pour un abandon, il faut en revanche que tout le SC22 vote.

Pour l’instant, les camps sont divisés. Certains militent pour un nouveau vote sur le texte inchangé, d’autres pour retirer la seule fonction contestée afin que le reste passe. D’ici à ce que le problème soit tranché, il est probable que la date du vote glisse en 2027. La future norme pourrait alors changer de nom pour C++ 27.

  •  

Chatbots IA : le droit européen interdirait la reprise d’articles de presse sous paywall

OpenAI mais pas open bar
Chatbots IA : le droit européen interdirait la reprise d’articles de presse sous paywall

Selon l’avocat général de la CJUE, le scraping et la réutilisation de publications de presse en ligne par les chatbots IA pour générer des réponses doivent respecter certains critères, et notamment qu’elles aient été obtenues légalement (donc sans passer outre un paywall), mais aussi que le chatbot ne réutilise pas le style utilisé dans l’article.

La presse européenne est suspendue au sort qui sera réservé à l’affaire qui oppose l’éditeur hongrois Like Compagny à Google. C’est, selon le communiqué de presse [PDF] de la Cour de justice de l’Union européenne (CJUE), la première affaire relative à l’IA générative portée devant elle.

Et l’avocat général à la Cour, Maciej Szpunar, vient de rendre ses conclusions. Rappelons qu’il doit donner un éclairage à la Cour mais que celle-ci n’est pas liée à ses conclusions. Les juges commencent tout juste à délibérer dans cette affaire et leur arrêt sera rendu ultérieurement. Mais le regard de l’avocat général permet de mieux cerner les enjeux de cette décision.

En l’occurrence, devant la Cour régionale de Budapest, Like Compagny accuse Google (en fait, sa maison mère, Alphabet) d’avoir violé les droits qu’elle possède sur les articles publiés sur le site Balaton Környéke en les utilisant entre juin 2023 et juin 2024, sans son accord, pour entrainer ses modèles, mais aussi dans son processus de RAG (pour retrieval-augmented generation) afin de générer des réponses aux utilisateurs de son chatbot Gemini en allant les chercher sur le web. Elle l’accuse aussi d’avoir « reproduit » ces articles et de les avoir « rendus accessibles » aux utilisateurs du chatbot.

Avant de statuer, cette cour hongroise a voulu consulter la Cour de justice de l’Union européenne pour vérifier comment le droit européen encadre ce genre de problèmes. Elle lui a demandé si le processus d’entrainement d’un modèle de langage peut être considéré comme un acte de reproduction illicite ou si il relève de l’exception au « text and data mining » que la loi européenne permet. La Cour hongroise a aussi interrogé la CJUE sur la reproduction des articles de presse par les chatbots.

Pas de preuve d’utilisation pour l’entrainement, pas de question

L’avocat général Maciej Szpunar demande à la CJUE d’évacuer les questions sur l’entrainement du modèle de langage avec les textes de Like Compagny car il considère qu’elles ne sont pas recevables. Pour lui, l’entreprise hongroise ne donne pas de preuve que Google a utilisé ses textes pour entrainer ses modèles.

Il demande à la Cour de se concentrer sur les questions relatives à la reproduction des articles par les chatbots via les processus de Retrieval-Augmented Generation (RAG).

Concernant la réutilisation d’articles en ligne par un chatbot pour générer une réponse, Maciej Szpunar estime que l’éditeur n’a pas un monopole sur l’information qu’il a publiée. Ainsi, selon lui, le droit européen permet à un chatbot de réutiliser une information publiée par un média sans avoir à lui demander son consentement.

Un chatbot ne peut pas réutiliser un contenu sous paywall ou utiliser le style d’un article

Par contre, le chatbot qui réutilise une information doit le faire sans y accéder de manière illicite, « notamment en contournant les mesures techniques efficaces destinées à restreindre l’accès à cette publication ou son extraction ».

Il ne doit pas non plus reproduire le style utilisé « dans tout ou partie de la publication de presse » en question, ce qui dispenserait le lecteur d’accéder à l’article originel. L’avocat général semble donc considérer que le droit européen protège la forme des articles de presse librement accessibles sur Internet mais pas le fond.

Il souligne aussi que, pour qu’ils soient retenus contre le fournisseur d’un chatbot, les actes de reproduction reprochés doivent être inhérents à son modèle économique, ou que ce fournisseur n’ait pas mis en place de mesures appropriées pour lutter contre ce genre de pratique de manière crédible et efficace.

Rappelons que les conclusions de l’avocat général ne sont pas contraignantes pour la CJUE, mais que, généralement, les juges de la Cour les suivent.

  •  
❌