❌

Vue lecture

Google, Microsoft, Anthropic et OpenAI veulent changer robots.txt pour refuser les IA

Un jeton pour les refuser tous
Google, Microsoft, Anthropic et OpenAI veulent changer robots.txt pour refuser les IA

Quatre entreprises de la tech souhaitent ajouter une ligne dans le fichier robots.txt pour que les données des sites concernés ne soient pas utilisées dans l’entrainement des IA. S’agissant d’une démarche déclarative, ses limites sont claires.

Le 30 octobre, Google, Microsoft, Anthropic et OpenAI ont annoncé qu’ils respecteraient une même ligne dans le fichier robots.txt pour refuser ou accepter l’utilisation d’un site à des fins d’entraînement de l’IA générative.

Le texte qui la définit est intitulé « Machine-Readable Training Preference Signal » et a été écrit par Kevin Kelley, ingénieur chez Anthropic. Il vise la normalisation par l’IETF, l’organisme qui fixe les standards techniques d’Internet, et doit expirer le 3 mai 2027 si aucune nouvelle version n’est publiée d’ici là.

Une simple ligne ?

La proposition cherche à simplifier une situation. Actuellement, un éditeur souhaitant en effet refuser l’entrainement sur ses données doit viser chaque robot séparément. Par exemple, GPTBot chez OpenAI ou Google-Extended chez Google. Le texte ajoute un nouveau jeton, « __usage_ai-training », qui doit permettre d’exprimer une seule préférence auprès de tous les fournisseurs qui s’y engagent.

Ce jeton se place dans la ligne User-Agent, comme on le fait déjà avec les noms des robots. Un Disallow exprime un refus de l’entraînement, un Allow un accord, chemin par chemin. Le texte illustre le fonctionnement par le code suivant, qui refuse l’entraînement sur tout le site, sauf pour un espace presse :

User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/

La date de support diffère d’un éditeur à un autre, mais tous s’engagent à respecter le nouveau signal dans les prochains mois.

Des limites évidentes

Il y a évidemment des limites. D’une part, le jeton ne bloque pas l’exploration. Le brouillon le décrit comme indépendant des règles visant les robots, qui continuent donc de s’appliquer comme avant. D’autre part, il est déclaratif et ne lie que les fournisseurs qui s’y engagent. De plus, il ne concerne que les contenus récupérés après son ajout, et ne retire ainsi rien des modèles déjà entraînés.

Surtout, l’engagement repose sur la seule parole des fournisseurs. OpenAI le présente comme une démarche volontaire (OpenAI), et le brouillon ne prévoit aucun contrôle ni sanction. Un éditeur n’a aucun moyen de vérifier qu’un contenu refusé n’a pas servi à entraîner un modèle. Le robots.txt lui-même, à l’origine, n’a d’ailleurs aucune valeur contraignante.

Enfin, le jeton ne lie pas non plus les entreprises qui ne s’y sont pas engagées. Apple, Amazon ou encore Meta ne s’y sont pas engagées. Rien n’oblige par ailleurs les autres développeurs de modèles à lire ce jeton, pas plus que les robots qui ignorent déjà le robots.txt.

  •  

Une faille dans Alpine Linux permet de se connecter avec un mot de passe trop long

Un contournement plus qu’un correctif
Une faille dans Alpine Linux permet de se connecter avec un mot de passe trop long

Une énorme faille de sécurité a été découverte et corrigée dans OpenSSH, qui permet d’administrer à distance la plupart des serveurs Linux. Exploitée, elle pouvait laisser entrer des pirates sur des serveurs Alpine Linux sans besoin de connaitre le mot de passe : il suffisait d’en écrire un aléatoire d’au moins 256 caractères.

Le projet OpenSSH a publié en urgence un correctif pour la faille dès le 5 novembre. Selon le message de Damien Miller, l’un des principaux développeurs, le correctif a été proposé moins de 24 heures après la réception du signalement.

L’équipe d’OpenSSH demande aux administrateurs concernés de couper aussi rapidement que possible la connexion par mot de passe, voire le service SSH lui-même, tant que le correctif n’est pas installé. Damien Miller indique que la grande majorité des systèmes d’exploitation ne sont pas concernés : Windows, macOS, la plupart des distributions Linux (comme Debian, Ubuntu, Red Hat, Fedora…) ou encore les systèmes BSD ne présentent pas de risque d’exploitation dans leur configuration par défaut.

Pourquoi une telle urgence dans ce cas ? Parce que pour être exploitée, la faille nécessite une configuration précise, qui est justement celle par défaut dans Alpine Linux. Or, cette distribution est souvent utilisée pour sa légèreté dans certains environnements, notamment cloud.

Sur Alpine Linux, un correctif à installer au plus vite

Dans l’avis publié par l’équipe d’Alpine Linux hier soir, on peut lire qu’un serveur sous Alpine Linux est vulnérable s’il réunit trois conditions : le service SSH accepte les connexions par mot de passe (c’est le cas par défaut), il existe au moins un compte sans mot de passe, et au moins un autre compte en possède un.

Si vous estimez que personne n’utilise des comptes sans mot de passe, détrompez-vous. Il s’agit le plus souvent de comptes auxquels les propriétaires se connectent avec une clé cryptographique, la méthode étant d’ailleurs plus sûre. La vulnérabilité, référencée CVE-2026-123158, peut donc être exploitée pour ouvrir l’accès à ces comptes sans mot de passe, clé cryptographique ou pas. Tout ce dont le pirate a besoin selon Alpine, c’est de joindre le serveur par le réseau et de connaitre le nom d’un de ces comptes.

Sur cette distribution, le compte administrateur (root) est livré sans mot de passe, le rendant en théorie vulnérable. Par défaut, OpenSSH refuse toute connexion par mot de passe au compte administrateur, quel que soit le mot de passe tapé. C’est en théorie suffisant. Cette protection tombe toutefois si un autre compte a les droits nécessaires pour devenir administrateur. C’est le cas dans les versions 3.18.11 à 3.24.3 des images d’Alpine Linux destinées au cloud. Dès lors, ces machines deviennent vulnérables dès qu’un mot de passe est défini sur un autre compte, ouvrant la voie au pirate pour un accès complet au serveur.

Comme l’indique The Hacker News, il est recommandé de vérifier si d’autres systèmes sont concernés, car le composant impliqué (musl) est aussi utilisé dans des distributions spécialisées dans l’embarqué comme OpenWrt, Buildroot et Yocto. En revanche, les conteneurs Docker qui ne font pas tourner de serveur SSH, les serveurs où la connexion par mot de passe est désactivée, et les machines installées via cloud-init (qui désactive cette connexion) ne sont pas affectés.

Comment un mot trop long peut-il ouvrir la porte ?

Un système ne stocke pas les mots de passe en clair. Il ne conserve que leur empreinte, calculée via une transformation mathématique irréversible. Pour vérifier un mot de passe, le serveur calcule l’empreinte de ce qui a été tapé et la compare simplement à celle enregistrée sur la machine.

La vulnérabilité réside dans la rencontre entre deux conventions, qui n’ont rien d’anormal quand elles sont prises isolément. Ainsi, pour un compte sans mot de passe, Linux enregistre un unique astérisque à la place de l’empreinte. Mais Alpine utilise la bibliothèque musl, pour des besoins de légèreté. Celle-ci, quand elle doit calculer l’empreinte d’un mot de passe de plus de 256 caractères, refuse. Pour signaler l’erreur, elle renvoie… un simple astérisque. Le problème est alors évident : le serveur compare les deux, en déduit qu’il s’agit de la même empreinte et ouvre la session. Pour effectuer ce calcul, le serveur emprunte un paramètre depuis un compte possédant un vrai mot de passe, d’où la nécessité d’avoir au moins un tel compte configuré.

Les distributions n’utilisant pas musl ne sont pas touchées car leur bibliothèque système signale l’erreur autrement. Celles qui délèguent la vérification à un module d’authentification séparé (PAM) ne sont pas non plus concernées.

Ce comportement dans musl remonte à 2012, tandis que la manière dont OpenSSH traite les comptes sans mot de passe vient d’un changement introduit en 2016. La faille existe donc depuis une décennie environ.

Le correctif d’OpenSSH refuse désormais toute comparaison avec une empreinte enregistrée trop courte pour être valide. OpenSSH le présente d’ailleurs davantage comme un contournement, la cause profonde restant dans musl. À noter que le problème avait été remonté en 2024, l’attitude de musl étant alors jugée incorrecte sur l’utilisation de l’astérisque.

Les actions à réaliser

Sans surprise, la meilleure parade est la mise à jour, mais il faudra redémarrer le service SSH ensuite, car l’installation seule du correctif n’est pas suffisante si le serveur est actif.

Alpine a publié des paquets corrigés pour toutes ses versions depuis la 3.16, y compris celles qui ne sont plus officiellement suivies, comme la 3.21 (son support est terminé depuis le 1ᵉʳ novembre), signe de l’importance de la situation. Les nouvelles versions 3.21.10, 3.22.8, 3.23.8 et 3.24.4 intègrent directement la correction.

Comme indiqué précédemment, sur les machines où la mise à jour est impossible pour le moment, il suffit de désactiver la connexion par mot de passe. Alpine recommande d’ailleurs de bien vérifier que la connexion par clé cryptographique fonctionne avant de procéder, pour ne pas se retrouver bloqué hors du serveur. Dans les installations cloud, il faudra s’assurer que toutes les machines virtuelles lancées sont corrigées, car la simple reconstruction des images ne protège pas les instances déjà actives.

On notera enfin que tout le monde ne semble pas d’accord sur le niveau de dangerosité de cette faille. Sur le site du NIST, le score CVSS est en effet de 8,1, ce qui la classe comme « élevée », pas « critique ». Dans son message, Damien Miller (de l’équipe OpenSSH) évoque pourtant bien une faille critique.

  •  

☕️ Vivaldi 8.3 devient plus agressif contre les publicités et les traqueurs


Nouvelle version pour le navigateur alternatif basé sur Chromium et orienté vers les « power users ». L’ajout majeur de cette mouture est l’arrivée d’un nouveau sélecteur pour le niveau de blocage que l’on souhaite contre les publicités et traqueurs.

Jusqu’à présent, les utilisateurs avaient le choix entre trois options : pas de blocage, bloquer les traqueurs, bloquer les traqueurs et les publicités. Désormais, les traqueurs et publicités sont regroupés et le sélecteur propose quatre réglages :

  • Désactivé
  • Léger, qui bloque la plupart des traqueurs et certaines publicités
  • Fort, qui augmente le niveau de blocage, au risque de perturber certains sites
  • Agressif, le niveau maximal de blocage, au risque de « casser » certains sites

Le navigateur laisse cependant la possibilité de définir des niveaux personnalisés en fonction des sites. L’éditeur norvégien pousse d’ailleurs dans ce sens : « Mettez ce DJ-set sur Youtube à fond sans que les publicités ne brisent votre rythme avec le niveau « Agressif  ». Gardez le niveau « Léger » sur votre appli de banque pour que chaque formulaire fonctionne comme prévu. Refusez la protection sur le petit site indépendant en qui vous avez confiance et sur lequel vous tolérez de voir des publicités ». On peut également créer un niveau général de blocage personnalisé, où l’on pourra notamment choisir les listes de blocage.

Vivaldi 8.3 ajoute aussi deux options pour les onglets verticaux. La première permet de déployer la barre d’onglets au survol de la souris, offrant une solution à mi-chemin entre la vue minimaliste (qui n’affiche que les favicons) et la vue classique (qui affiche les noms des pages ouvertes). La seconde regroupe les onglets épinglés pour les afficher en grille, si la colonne est élargie. Dans le cas d’une colonne minimaliste, les favicons s’empilent comme d’habitude. Il s’agit du nouveau comportement par défaut, mais une option permet de le désactiver pour revenir à l’ancien (un site épinglé par liste).

Source : Vivaldi

Parmi les autres améliorations, on trouve en outre une fonction bienvenue : on peut copier une liste de liens et la coller dans la barre d’adresses, Vivaldi ouvrant alors chaque lien dans un onglet dédié. Selon l’éditeur, c’est une solution pratique quand vous recevez par exemple une liste de liens dans un e-mail. La version 8.3 ajoute également une fonction « Copier l’URL sans traqueurs » dans le menu contextuel depuis la barre d’adresses, un mode lecture plus réactif (lancement plus rapide et défilement plus fluide), ainsi que le support de l’API Tab Groups de Chrome pour les extensions

  •  

Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Lumière !
Microsoft propose deux améliorations significatives du ray tracing pour les jeux

Microsoft a publié les préversions de deux nouvelles technologies liées au ray tracing : Clustered Geometry et PTLAS. Elles promettent l’allègement des calculs liés à la lumière dans bon nombre de scénarios, avec des gains parfois significatifs.

Pour comprendre les améliorations proposées, il faut d’abord parler du ray tracing – ou lancer de rayons – pour comprendre le problème.

Ce lancer de rayons simule le trajet de la lumière. Pour chaque pixel, le GPU envoie des rayons et cherche ce qu’ils touchent dans la scène. Cette technique permet de produire des reflets, ombres et éclairages nettement plus réalistes que les méthodes précédentes. Les jeux compatibles avec le ray tracing ont souvent mis en avant cette fonction, dont on sait qu’elle est vorace en puissance de calcul.

La difficulté, en effet, est que la scène contient généralement des millions de triangles, utilisés pour la composition des objets 3D. Tester chaque rayon émis sur chaque triangle en temps réel est impossible.

La carte graphique s’appuie donc sur un résumé de la scène, que l’on nomme « structure d’accélération », dans laquelle les objets sont rangés dans des boites, elles-mêmes rangées dans d’autres boites. Par exemple, une fenêtre appartient à une maison, qui appartient à un quartier, qui appartient à une ville. Ce classement est important, car il permet d’écarter d’un coup tout ce qu’un rayon ne peut pas toucher. Le résumé dispose en outre de deux étages : le bas décrit chaque objet en détail, tandis que le haut décrit la scène complète, donc où se trouve chaque objet.

Où se situe le problème alors ? Dans le mouvement ! Dès que la scène bouge, tout se complique. Un personnage qui marche, un arbre agité par le vent ou autre oblige à recalculer une partie du résumé, parfois à chaque image. Dès qu’une scène devient très détaillée, ce travail de réorganisation peut couter plus cher en calculs que le lancer de rayons lui-même. Pour éviter que les GPU n’arrivent plus à suivre la cadence (donnant des performances exécrables), de nombreux jeux calculent les reflets et autres éléments sur la base d’objets simplifiés.

Ce que Microsoft a présenté

Le 28 octobre, Microsoft a donc lancé deux nouvelles technologies en préversions. L’entreprise présente ces évolutions comme les plus importantes pour DXR (DirectX Raytracing) depuis son lancement en 2018.

La première se nomme Clustered Geometry. Au lieu de construire d’une traite le résumé d’un objet, on le découpe en paquets contenant un maximum de 256 triangles, à la manière de briques de construction. Chacune est préparée une seule fois, puis réutilisée et assemblée selon les besoins. Quand un objet change de niveau de détail (par exemple quand le personnage s’approche), il n’y a pas de reconstruction, le GPU assemblant d’autres briques déjà prêtes. Et pour les objets qui se déforment, comme des personnages animés ? Microsoft prévoit des gabarits, selon le même fonctionnement : la forme des briques est préparée à l’avance, seule leur position étant mise à jour.

La seconde est appelée PTLAS, pour Partitioned Top-Level Acceleration Structures. Pour l’étage haut (donc le descriptif de la scène complète), la scène est découpée en zones. Dans une scène 3D, si une caisse tombe par exemple dans un coin, seule cette zone est mise à jour, le reste étant conservé à l’identique d’une image à l’autre. Les objets qui bougent sans arrêt peuvent être mis à part pour ne pas forcer l’actualisation de toute leur zone.

Dans les deux cas, une autre amélioration est liée : le GPU peut décider de lui-même de ce qu’il faut reconstruire. Un changement de taille, car c’est le CPU qui s’occupe aujourd’hui de préparer une bonne partie de ces opérations. Avec Clustered Geometry et PTLAS, il n’y a presque plus d’allers-retours entre le GPU et le CPU, soulageant d’autant ce dernier.

Précisons quand même que l’idée n’est pas nouvelle : elle vient de NVIDIA. La firme au caméléon propose actuellement ces techniques sous l’appellation RTX Mega Geometry. Gears of War: E-Day est d’ailleurs le premier jeu à l’exploiter. Cependant, sa « standardisation » (en quelque sorte) dans DirectX rend ces techniques utilisables par les autres GPU, ce qui change la donne.

Pour qui ?

L’un des avantages de cette approche est que ces techologies ne réclament aucun nouveau matériel. En théorie, Clustered Geometry et PTLAS sont compatibles avec un très grand nombre de GPU existants.

En résumé, pour l’instant :

  • NVIDIA : toutes les cartes GeForce RTX
  • AMD : les Radeon RX 9000
  • Intel : les Arc série B et certains processeurs Core Ultra récents
  • Qualcomm : les Snapdragon X2 (pilotes attendus au premier semestre 2027)

Techniquement, il suffit que les entreprises concernées mettent à jour leurs pilotes pour profiter de ces améliorations. Chacune devra déterminer quelles cartes seront compatibles. Par exemple, il n’y a aucune information sur le support des Radeon RX 7000, il faudra donc attendre pour en savoir bien.

Bon, et les performances alors ?

Commençons par la mauvaise nouvelle : oui, il est nécessaire que les éditeurs de jeux rendent leurs titres compatibles avec ces techniques pour en profiter. Il n’y a donc aucun jeu prenant en charge Clustered Geometry et PTLAS aujourd’hui, et il faudra attendre que les entreprises concernées s’expriment sur le sujet.

La bonne nouvelle maintenant : le gain peut être significatif, voire… gigantesque. Dans une démonstration de Microsoft sur une Radeon RX 9070, la scène passe de 1,2 à 79 images par seconde, et la mémoire vidéo consacrée au sommaire de la scène tombe d’environ 7,3 Go à 774 Mo.

Cette multiplication des performances par 66 a fait le tour du web ces derniers jours. Et pour cause, on n’a pas souvent l’occasion de voir de tels gains. Mais calmons tout de suite les espoirs, sans les doucher : il s’agit d’un cas extrême, mis en avant par Microsoft pour illustrer le potentiel de ses deux techniques. Ensuite, la comparaison est faite avec le pire scénario possible, c’est-à-dire une reconstruction complète à chaque image. Comme on l’a vu précédemment, les développeurs ont déjà des astuces pour éviter ce type de scénario. Enfin, on n’a rien sans rien : la mémoire de travail nécessaire pendant la reconstruction augmente fortement, mais les autres gains permettent en théorie un bon compromis dans tous les cas.

Microsoft l’indique clairement dans son billet de présentation, il ne faut pas s’attendre à des gains d’une telle ampleur dans tous les jeux. Une démonstration plus réaliste, fournie par NVIDIA, met ainsi en scène des milliers de dominos qui tombent. La mise à jour de la scène passe de 2,88 ms à 0,79 ms par image, alors que le lancer de rayons lui-même devient légèrement plus lent. Le bilan reste positif, mais on est loin d’un facteur 66 (le nombre d’images par seconde passe de 116 à 125).

Même si les gains réels seront plus mesurés et limités aux titres exploitant le ray tracing, une hausse des performances sans changer de matériel est toujours appréciable. Les deux techniques laissent imaginer des mondes ouverts plus denses et plus animés en lancer de rayons, des reflets et des ombres plus fidèles au décor, et une consommation de mémoire vidéo moindre.

Enfin, notez que ces annonces se sont accompagnées d’une autre en parallèle : Advanced Shader Delivery, qui doit réduire les saccades dues à la compilation des shaders en livrant des shaders déjà compilés. La fonction est déjà prise en charge par AMD pour ses Radeon RX 7000 et 9000 dans les derniers pilotes. Chez Intel et NVIDIA, il faudra attendre une nouvelle mouture.

  •  

☕️ Discord travaille sur des clients natifs pour les ordinateurs


Discord travaille à se débarrasser d’Electron pour son client « desktop », à destination de Windows, macOS et Linux. La rumeur courait depuis un moment, mais Stanislav Vishnevskiy en personne, cofondateur et directeur technique de l’entreprise, l’a confirmé sur X.

Son message s’accompagne d’ailleurs d’une capture, montrant le processus « Discord Phoenix » (nom de code de cette future mouture) et sa consommation de 290 Mo de mémoire vive. On remarque d’autres éléments, dont probablement un clin d’œil à Steam et ses 856 Mo consommés, l’application de Valve utilisant des technologies web.

Ce changement est attendu de pied ferme, car Discord peut consommer jusqu’à plusieurs Go de mémoire. Nous l’évoquions fin septembre, quand l’arrivée d’un mode jeu avait été révélée par le compte Discord Previews. La différence pourrait donc s’avérer énorme, libérant une grande quantité de RAM au profit des jeux, Discord étant souvent associé aux plaisirs vidéoludiques.

Dans son message, Stanislav Vishnevskiy indique que la nouvelle application sera intégralement en Rust, langage que l’entreprise utilise déjà pour différents composants. L’interface sera bâtie avec GPUI, un framework accéléré matériellement par le GPU pour Rust. Dans des réponses données sous son tweet d’origine, on apprend également que l’application aura exactement la même apparence qu’aujourd’hui, que le support de Linux devrait en être amélioré et qu’une version web continuera d’exister, Discord abandonnant l’actuel JavaScript pour du WebAssembly (Wasm).

Enfin, Stanislav Vishnevskiy espère que cette nouvelle version sera « bientôt » proposée en test aux utilisateurs. Le responsable n’en parle pas, mais il s’agira probablement du canal Canary de l’application.

  •  

Microsoft veut décidément convaincre sur les performances de Windows 11

Ram, ram, rameurs ramez...
Microsoft veut décidément convaincre sur les performances de Windows 11

Microsoft l’assure encore : Windows 11 consomme moins de mémoire vive. Ce serait surtout le cas pour les machines dotées de 8 Go de RAM, dans un contexte toujours plus tendu de pénurie et d’explosion des prix. Bien que la communication ait une visée marketing, l’entreprise assure que les efforts se poursuivent.

2026 doit marquer un tournant dans l’histoire de Windows 11. Microsoft communique abondamment depuis le début de l’année sur un effort général et profond autour de son système, afin de répondre aux critiques. L’éditeur aura pris le temps de la réflexion, depuis la commercialisation de son produit en octobre 2021.

Comme le rappelle notamment Windows Central, la sortie du MacBook Neo et de ses 8 Go de mémoire a mis en lumière les défaillances de Windows dans ce domaine. Le système est accusé d’être lent, peu réactif, un ogre vorace en mémoire aux interfaces bâties sur des technologies web et pénible à utiliser. Avec les tensions croissantes sur la mémoire vive et la NAND (dans les SSD), et probablement sous pression des constructeurs qui aimeraient lancer des configurations plus chichement équipées, Microsoft devait réagir. D’autant que Windows 11 demande officiellement 4 Go de mémoire pour fonctionner.

Trois axes d’amélioration

Dans son billet du 3 novembre, Microsoft commence par indiquer qu’une mémoire pleine n’est pas en soi un problème : les données et applications se tiennent prêtes dans un certain contexte, qui peut évoluer à mesure que les besoins changent au cours de la session. « Le vrai test est de savoir si votre PC reste réactif, pas de la quantité de mémoire inutilisée », affirme l’entreprise.

Trois leviers sont quand même mentionnés pour les améliorations de ce mécanisme. La compression des données d’abord, pour réduire la taille des informations moins utilisées. La fonction existe depuis des années, mais elle a été retravaillée pour les configurations à 8 Go, a priori pour être plus agressive. En conséquence, Windows 11 peut garder jusqu’à 2 Go de données actives supplémentaires en mémoire, réduisant les chances qu’un onglet ou une application ait besoin d’être complètement rechargé.

Microsoft indique ensuite avoir donné la priorité aux interactions, surtout les principales comme le menu Démarrer, le clic droit, la recherche, les paramètres, l’Explorateur ou encore l’outil Capture d’écran. Autant de composants qui répondraient jusqu’à 20 % plus vite, sans que Microsoft ne détaille sa méthode de calcul. Le système sait mieux suspendre certaines activités quand la machine est sollicitée par l’utilisateur, par exemple l’indexation.

Un mécanisme de lancement accéléré a également été mis en place, dont Edge est la première application à profiter. Le gain de temps peut grimper jusqu’à 33 %, mais il est de 15 % en moyenne. Microsoft ajoute que ce mécanisme est ouvert aux applications tierces. À propos d’Edge, le navigateur met désormais en veille les onglets après 15 min par défaut, contre 2 heures jusqu’à présent.

Enfin, Microsoft travaille sur les applications courantes. Dans des scénarios multitâches impliquant Windows, Edge et la suite Office, les gains observés grimpaient jusqu’à 900 Mo, dont jusqu’à 360 Mo pour Office. L’éditeur explique que les améliorations viennent aussi bien de la manière dont la mémoire est gérée et de comment elle est utilisée par les applications, mais sans donner plus de détails.

Les éditeurs tiers doivent eux aussi profiter de ces améliorations, en théorie. Microsoft cite l’exemple du client WhatsApp pour Windows, qui aurait constaté un gain à deux chiffres, là encore sans plus de précision. Drôle de choix d’ailleurs, car cette application est probablement l’une des pires en matière d’efficacité : WhatsApp a mis fin à son application native et a basculé sur des technologies web, avec une consommation oscillant entre 1 et 3 Go de mémoire. À moins de besoins spécifiques, la version web du service fera largement l’affaire.

La route sera longue

La fin du billet mentionne plusieurs autres améliorations en préparation. Par exemple, une compression des données en mémoire « encore plus intelligente et efficace ». Plus intéressant, il y a un travail en cours pour qu’un plus grand nombre de fonctions et d’applications partagent des éléments communs, avec moins de chargements en mémoire à la clé. La recherche et les widgets devraient ainsi partager un seul moteur web. Idem pour OneDrive et Photos, même si on ignore s’il s’agit là encore d’un moteur web ou d’autres composants.

D’autres chantiers sont en cours, dont la progression du framework natif WinUI 3 pour un nombre croissant d’applications. Microsoft dit également être en discussion avec les fabricants de PC et de puces pour « optimiser » la quantité de mémoire que le matériel réclame pour fonctionner. L’éditeur affirme enfin travailler avec des développeurs tiers pour « aider leurs apps à utiliser plus efficacement la mémoire ».

Toutes ces informations manquent cependant de précision. Les notes en bas de page montrent que les gains observés sont souvent basés sur un faible nombre de machines et dans des cas favorables. Il ne semble pas y avoir pour l’instant de tests indépendants. Si le mouvement de fond va dans le bon sens, il est donc difficile de savoir aujourd’hui dans quelle mesure ces améliorations sont efficaces.

Ce billet comporte en outre une dimension marketing très claire. D’une part, il se termine justement par des offres sur des PC peu onéreux, comme une offre à 429 dollars chez Walmart. D’autre part, il est évident que Microsoft travaille au successeur de Windows 11. Le système ayant agacé par de nombreux aspects depuis sa sortie, l’éditeur doit redorer son image avant d’avoir un nouveau produit à vendre.

Ce point est loin d’être anodin. La fin précipitée de Windows 10 (même si l’Europe a un traitement de « faveur »), le passage forcé à Windows 11, l’expérience utilisateur moyenne, la montée en puissance de Linux ou encore l’agacement engendré par la prolifération des outils IA sont autant de facteurs à prendre en compte. Si « Windows 12 » n’est pas suffisamment attirant, la question d’une bascule vers un autre environnement se posera d’autant. Microsoft a donc tout intérêt à continuer le travail sur ce que l’on attend d’un système d’exploitation : performances, fiabilité et sécurité.

  •  

Vague démocrate aux États-Unis : quels effets sur le secteur de la tech ?

Da ba dee da ba di
Vague démocrate aux États-Unis : quels effets sur le secteur de la tech ?

La victoire démocrate aux États-Unis est claire, tant sur la Chambre des représentants que sur le Sénat. Que signifie la prise du pouvoir au Congrès pour le secteur de la tech ? S’il est encore trop tôt pour établir des prévisions sur l’ensemble de l’industrie, un domaine en particulier va être rapidement concerné : l’IA.

Les pronostics semblaient clairs depuis des semaines, mais la victoire des démocrates est pour le moins éclatante à l’issue des midterms américaines. Ces élections se produisent pour rappel à mi-mandat du président élu et lui sont généralement défavorables. Dans le cas présent, le désaveu pour Donald Trump est cinglant, puisque les démocrates vont contrôler les deux chambres du Congrès, qui appartenaient toutes deux aux républicains jusqu’à présent. Le changement se fera officiellement en janvier.

Comme le signale notamment Reuters, le président américain paye la guerre déclenchée contre l’Iran le 28 février, la flambée des prix des carburants ou encore, de manière générale, le coût de la vie dans le pays. Reuters cite un sondage en sortie des urnes, selon lequel 75 % des personnes interrogées ont indiqué être « en colère » ou « insatisfaites » de la direction prise par les États-Unis. 70 % ont également dit souhaiter un rôle renforcé du Congrès sur le contrôle de l’exécutif.

Ces élections ont également une caractéristique particulière : le secteur de la tech, tout particulièrement l’intelligence artificielle, a joué un rôle. Les entreprises concernées vont devoir s’adapter.

Désaveu pour les milliardaires de la tech

Si l’on en croit CNBC, le scrutin est un désaveu des milliardaires de la tech. Les démocrates auraient ainsi pris le Congrès sur fond de mécontentement face aux prix, à la corruption, mais aussi face à la construction des centres de données pour l’IA. Des datacenters dont l’installation est devenue hautement politique ces derniers mois.

Toujours selon CNBC, le Texas concentre une grande partie des projets prévus. La nouvelle gouverneure Gina Hinojosa a fait campagne pour suspendre les nouveaux projets jusqu’à l’adoption de règles plus strictes, autrement dit un moratoire.

Business Insider et TIME s’intéressent de leur côté à Elon Musk, premier donateur du cycle électoral, avec au moins 446 millions de dollars, dont la moitié pour le seul Texas via des super PAC alliés, sans pour autant empêcher l’État de basculer. Un changement conséquent d’ailleurs, puisque non seulement le Texas n’avait pas eu de gouverneur démocrate depuis 1988, mais le nouveau sénateur élu, James Talarico, l’emporte avec 10 points d’avance sur son adversaire Ken Paxton.


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Une faille critique dans le noyau Linux permet de faire planter un serveur via TCP

Une poignée de mains et patatras
Une faille dans Alpine Linux permet de se connecter avec un mot de passe trop long

Une nouvelle faille critique a été découverte dans le noyau Linux. Avec un score CVSS de 9,8 sur 10, sa dangerosité frôle la note maximale, permettant une exploitation à distance. Selon la distribution utilisée, le correctif peut être disponible ou non.

Les distributions Linux reçoivent peu à peu de nouveaux noyaux contenant un correctif pour la faille estampillée CVE-2026-98432. La situation est très variable selon les systèmes, Red Hat ayant publié de nouveaux noyaux par exemple, alors que chez Canonical, les correctifs pour Ubuntu restent pour l’instant cantonnés au dépôt de test, sans date de publication générale. D’autres encore ont réglé le problème au cours des deux dernières semaines.

La faille est connue publiquement depuis le 15 octobre. Elle est présente dans le noyau Linux depuis sa version 4.4, qui remonte à une dizaine d’années.

Deux cœurs pour une même mémoire

Pour comprendre comment fonctionne la faille, rappelons d’abord quelques bases. Lorsqu’un serveur accepte une connexion TCP, il échange d’abord trois messages avec le client : le client demande l’ouverture (SYN), le serveur accepte (SYN-ACK), puis le client confirme (ACK). Pendant cet échange, le serveur garde en mémoire certaines informations envoyées par le client, les options IP.

Tant que l’échange n’est pas terminé, le noyau Linux range ces informations dans une fiche provisoire (demande en attente). À la réception du dernier message (ACK), il crée la fiche définitive de la connexion. Au lieu de recopier les options IP dans cette nouvelle fiche, il se contente d’y noter leur emplacement en mémoire. Les deux fiches désignent alors la même zone mémoire, et la fiche provisoire peut encore être utilisée.

On peut voir venir le problème. Il survient quand deux cœurs du processeur travaillent en même temps, soit un scénario très commun sur n’importe quel serveur aujourd’hui. Si le client renvoie sa demande de connexion, un cœur peut être en train de lire ces informations pour y répondre, tandis que l’autre vient de les effacer en fermant la connexion. Le premier lit alors une mémoire qui ne lui appartient plus et qui peut tout à fait avoir été réaffectée à un autre processus. Ce mécanisme peut être exploité, la faille étant donc de type use-after-free (utilisation de mémoire après libération).

S’il veut déclencher ce conflit et donc exploiter la faille, le pirate n’a pas besoin de compte. Il lui « suffit » d’envoyer des demandes de connexions contenant certaines options IPv4 peu utilisées (comme Record Route ou Timestamp) vers n’importe quel port TCP ouvert. Les connexions IPv6 ne sont pas concernées.

De fait, le correctif à appliquer est simple : il impose au noyau d’attendre que plus personne ne lise les informations en mémoire avant de les effacer.

La gravité de la faille ne fait pas consensus

Officiellement, le score CVSS est bien de 9,8. Et pour cause : l’exploitation se fait avec un simple accès réseau, ne semble pas complexe, ne réclame aucun privilège particulier ni interaction côté victime, et l’impact potentiel sur la confidentialité, l’intégrité et la disponibilité est élevé. La faille peut en effet servir aussi bien à déclencher un plantage qu’à voler des informations.

Red Hat, dans sa fiche sur la vulnérabilité, considérait initialement cette faille comme « modérée », avec un score de 5,9. L’éditeur s’est pourtant ravisé, s’alignant sur la note de 9,8 et la considérant donc comme critique. Mais tous ne l’ont pas fait.

Chez AWS (pour sa distribution Amazon Linux) par exemple, on considère que la faille a un score de 8,1, ce qui la place dans la catégorie « importante ». Amazon considère que ce « problème entraîne principalement un plantage du système menant à un déni de service (DoS) ou une possible corruption de la mémoire ».

Canonical, dans son bulletin du 2 novembre sur la faille, reprenait directement la note de 9,8.

Qui est à l’abri ?

Comme indiqué, la situation dépend largement du système utilisé. Côté Ubuntu par exemple, si vous utilisez une mouture 26.10 à jour, aucun problème : le correctif est présent dans le noyau 7.3.0 - 10.10. En revanche, pour toutes les autres versions, il faut attendre ou installer un correctif pas tout à fait finalisé. Ubuntu 26.04, 24.04 et 22.04 peuvent ainsi puiser dans le dépôt -proposed pour des révisions des noyaux (respectivement les branches 7.0, 6.8 et 5.15). Pour les versions plus anciennes, le correctif est en préparation.

Sur Amazon Linux, le correctif a été distribué entre les 24 et 30 octobre, selon les versions. Pour Red Hat, on l’a vu, les correctifs sont également disponibles. D’autres distributions ont réagi plus tôt, notamment Debian, SUSE ou encore Oracle Linux, qui ont toutes reçu des correctifs durant la seconde moitié d’octobre.

La situation suffit en tout cas à justifier une mise à jour rapide. On parle tout de même d’un défaut accessible sans authentification sur tout port TCP IPv4 en écoute, présent depuis dix ans, avec au minimum un risque de déni de service et de fuite mémoire.

L’exécution de code à distance n’a été en revanche démontrée que par un seul acteur : Anthropic. Dans un billet du 27 octobre, l’entreprise a en effet indiqué qu’elle avait utilisé un modèle de recherche interne pour créer une chaine d’exploitation aboutissant aux droits root, dans des conditions particulières. Il ne semble pas pour l’instant que la vulnérabilité soit réellement exploitée, mais certains chercheurs évoquent désormais une activité a priori malveillante pour chercher les serveurs exposés.

  •  

Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Le comite n'a pas contracté
Le C++26 refusé à l’ISO, une première dans l’histoire du langage

Pour la première fois de son histoire, le langage C++ a échoué à réunir assez de votes au sein de l’ISO pour une nouvelle version. Le C++ 26 n’a pas été ratifié, faute d’un accord sur plusieurs points, dont le principal est le concept de contrat. Explications.

Le 23 octobre avait lieu le vote des organismes nationaux sur le projet de norme internationale (DIS). Le lendemain, Robert Seacord, qui dirige le comité du langage C à l’ISO, annonçait sur LinkedIn que le texte avait été désapprouvé, y évoquant un « jour triste pour la communauté C++ ».

Une première pour le C++

Pour être adopté, un projet doit réunir deux conditions. Il lui faut non seulement les deux tiers des voix des membres participants, mais les votes négatifs ne doivent pas non plus dépasser le quart des votants. Or, C++ 26 n’a obtenu que 12 voix sur 20, soit 60 %, alors que 14 étaient nécessaires. En outre, les votes négatifs ont atteint 9 sur 22, soit 41 %. Le projet C++ 26 a donc échoué sur les deux tableaux.

Selon Mateusz Pusz, membre du comité national polonais qui a consulté le résultat officiel, neuf pays ont voté contre : Danemark, Finlande, Iran, Italie, Japon, Luxembourg, Roumanie, Espagne et Suède. La France et l’Irlande se sont abstenues tout en adressant des commentaires techniques. La Pologne et les États-Unis se sont abstenus sans commentaires.

C’est la première fois qu’une nouvelle version du langage n’est pas normalisée par l’ISO. Pour Robert Seacord, aucune norme de langage n’avait jamais échoué à ce stade. Selon Daveed Vandevoorde, membre du groupe de direction du comité C++, c’est même encore plus significatif : aucun projet antérieur n’avait reçu un seul vote contre.

Au cœur des débats, les contrats

Le C++ 26 dresse une longue liste de nouveautés, parmi lesquelles les contrats. En développement, un contrat inscrit dans la déclaration d’une fonction ce qu’elle exige de son appelant et ce qu’elle garantit en retour. Il s’agit respectivement de la précondition et de la postcondition. Par exemple, une fonction de racine carrée peut exiger un nombre positif et promettre un résultat tout aussi positif.

Cette idée n’est pas nouvelle, comme l’indique le site Les Joies du Code. Le principe a été popularisé dans les années 1980 par l’informaticien français Bertrand Meyer avec son langage Eiffel. D’autres langages plus modernes, comme Ada et D, l’intègrent également. Le contrat figure dans la déclaration, à la vue de tous (aussi bien les appelants que le compilateur et les outils d’analyse). Pour ses défenseurs, il sert même de documentation qui ne peut pas devenir obsolète en silence.

Pour donner une idée de l’âge du sujet, le comité C++ travaille dessus de manière concertée depuis 2004, et une première version avait été proposée pour C++ 20, avant d’être supprimée en 2019. La version actuelle, présente dans la proposition de C++ 26 récemment refusée, avait pourtant reçu l’aval d’un sous-comité technique en février 2025, par 100 voix contre 14.

Alors que s’est-il passé ? En fait, si l’idée fait globalement consensus, sa conception divise. Dans C++ 26, le code source ne décide pas si un contrat est vérifié. Le texte définit quatre comportements possibles : ignorer la vérification, l’effectuer en signalant l’erreur sans s’arrêter, l’effectuer et arrêter le programme, ou l’arrêter immédiatement sans traitement intermédiaire.

Problème, le choix revient à l’implémentation, autrement dit à une option de compilation. Ainsi, une même règle écrite par le développeur peut donc être appliquée strictement, simplement signalée ou ignorée selon la manière dont le programme est construit. Dans son billet, Mateusz Pusz avait résumé ainsi la problématique : une assertion de contrat est-elle une vérification que la compilation peut supprimer, ou une garantie sur laquelle le programme peut compter ?

Deux camps irréconciliables

Sans surprise, les opposants reprochent la possibilité de désactiver les vérifications. Selon eux, cela revient à la pratique déjà connue de tester du code avec des contrôles puis à les supprimer en production. Ils préfèrent que ces vérifications soient toujours actives, ce qui aurait un coût estimé par Google à 0,3 %.

Ils lui reprochent également son inachèvement, car les contrats sur les fonctions virtuelles ont été repoussés à C++ 29. Dans ce camp, on retrouve notamment Bjarne Stroustrup, le propre créateur du C++. Il exprime son rejet des contrats sous cette forme depuis des années, comme l’indiquait The Register en mars dernier.

Pour les défenseurs en revanche, toutes ces critiques ont déjà reçu des réponses. Ils craignent également que le retrait ne repousse encore les contrats de plusieurs années. L’historique va d’ailleurs dans ce sens : après le retrait de C++ 20, il avait fallu six ans pour les remettre sur la table, dans une version plus modeste. En outre, ils reprochent à certains opposants d’avoir plaidé leur cause directement auprès des pays pendant le vote.

Et maintenant ?

D’abord, précisons qu’il y a peu de conséquences immédiates pour les développeurs. La situation est similaire avec les normes Wi-Fi : les compilateurs n’attendent pas la publication d’une norme pour implémenter un projet en cours de travail. Le vote ne modifie pas non plus ce qu’ils proposent déjà. Par exemple, la version 16 de GCC (sortie en avril) prend en charge les contrats à titre expérimental (avec l’option -std=c++ 26). Clang ne les intègre pas encore en revanche.

Quelle suite à présent ? Le comité WG21, le groupe de travail de l’ISO chargé du langage C++, doit se réunir à Búzios, au Brésil, du 16 au 21 novembre 2026. Il devra répondre à chacun des commentaires nationaux (que l’on ne peut pas consulter) et recommander une marche à suivre.

De là, il peut y avoir quatre possibilités : un projet révisé soumis à un nouveau vote de huit semaines, un nouveau projet de comité soumis à commentaires, une publication comme spécification technique, ou l’abandon pur et simple. Le président du SC22, sous-comité de l’ISO chargé des langages de programmation, devra choisir parmi les trois premières. Pour un abandon, il faut en revanche que tout le SC22 vote.

Pour l’instant, les camps sont divisés. Certains militent pour un nouveau vote sur le texte inchangé, d’autres pour retirer la seule fonction contestée afin que le reste passe. D’ici à ce que le problème soit tranché, il est probable que la date du vote glisse en 2027. La future norme pourrait alors changer de nom pour C++ 27.

  •  

[MàJ] Fedora 45 est disponible en version finale

Chapeau la distrib'
[MàJ] Fedora 45 est disponible en version finale

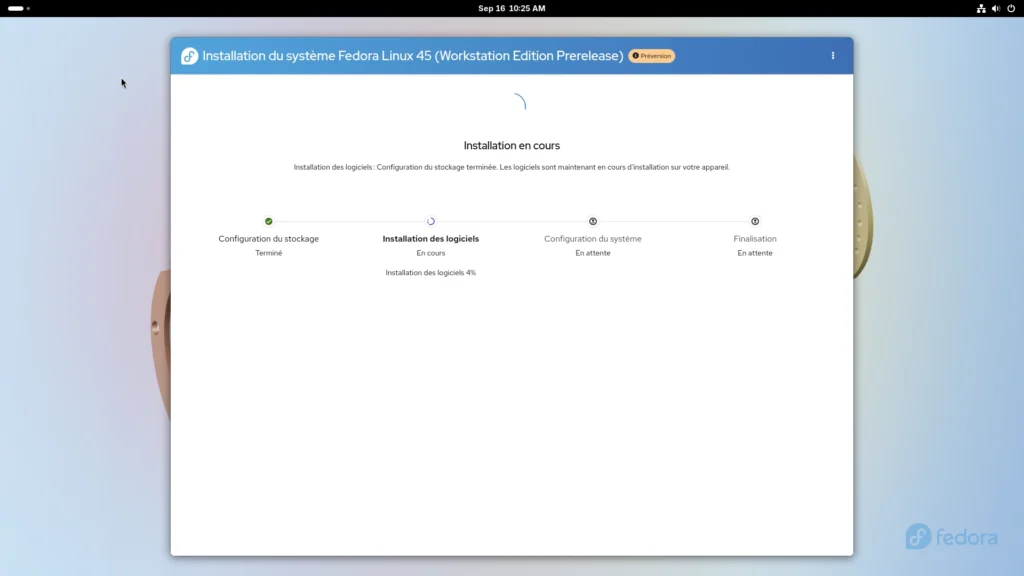
Fedora 45 est maintenant téléchargeable en version finale. Les nouveautés sont assez nombreuses, notamment sur la sécurité et les paquets reproductibles.

Mise à jour du 4 novembre

La version finale est désormais disponible au téléchargement. On peut récupérer les images ISO depuis le site officiel.


Article original du 16 septembre

Fedora est le laboratoire à ciel ouvert de Red Hat. La distribution est connue pour être pionnière dans ses choix technologiques, comme le choix du serveur d’affichage Wayland par défaut dès la version 25, longtemps avant les autres distributions (et les bugs de jeunesse qui allaient avec).

Comme Ubuntu, Fedora dispose d’un rythme biannuel, au printemps et à l’automne. La nouvelle mouture 45 est ainsi prévue pour le 20 octobre, ou le 27 en cas de problème. Maintenant que la bêta est disponible, on peut observer ses nouveautés, parmi lesquelles une hausse manifeste du niveau de sécurité.

Toutes les variantes du système peuvent être téléchargées (images ISO) depuis le site officiel. Sur la page de téléchargement, il faut penser à activer le sélecteur d’affichage pour la bêta. Depuis l’annonce officielle, les différents liens pointent tous directement vers les versions 45.

Composants de base

La bêta de Fedora 45 est livrée avec le noyau Linux 7.2, la dernière révision stable (sortie le 16 aout). Parmi les nouveautés de ce dernier, le Cache Aware Scheduling permet à l’équilibrage de charge de tenir compte du cache de dernier niveau au sein des processeurs. Phoronix, connu pour ses tests de performances, indiquait en outre que le noyau 7.2 introduisait des gains mesurables de performances pour les processeurs AMD et Intel. Entre autres nouveautés, on trouve une première prise en charge du HDMI 2.1 FRL dans le pilote AMDGPU, le support du protocole USB4STREAM d’Intel ou diverses prises en charge dans KVM de fonctions de sécurité propres à AMD et Intel.

Comme toujours avec Fedora, la version proposée par défaut pour les PC, Workstation, est fournie avec GNOME, qui passe pour l’occasion en version 51. Cette mouture n’est pas finalisée, même si les composants en bêta sont remplacés par leurs équivalents RC (Release Candidate) après l’installation de Fedora 45. GNOME 51 inaugure des curseurs au format SVG (déjà présents dans KDE), une nouvelle interface de gestion des empreintes digitales, le support de la connexion distante multi-utilisateurs via Kerberos, de nouveaux réglages pour le pavé tactile, de meilleures performances pour Agenda ou encore le nettoyage du code auparavant lié aux anciens pilotes NVIDIA. Pour les personnes n’appréciant pas GNOME, KDE Plasma 6.7 est disponible dans une version dédiée.

Côté développement, la chaîne GNU passe à GCC 16.2, binutils 2.47, glibc 2.44 et gdb 17.2. S’y ajoutent LLVM 23 pour l’ensemble des sous-projets, Go 1.27, Python 3.15, Perl 5.44 et Lua 5.5. Dans les notes de version de la distribution, on peut lire que plusieurs changements cassent la compatibilité. Par exemple, Setuptools 82 supprime le module pkg_resources. Pandas passe de la 2.3 à la 3.0, avec une gestion des chaînes revue, un comportement copie-sur-écriture cohérent et la suppression de fonctionnalités dépréciées depuis longtemps. Même chose avec libxml2, dont le passage de la 2.13.9 à la 2.15.3 s’est accompagné d’un changement d’ABI, imposant une recompilation de masse avec dépréciation des liaisons Python.

Parmi les autres changements, Podman 6 est une des mises à jour les plus lourdes de conséquences. Elle « inclut des changements importants de rupture de l’API et de la ligne de commande, de nouvelles fonctionnalités, ainsi que la suppression finale de composants obsolètes tels que slirp4netns, cgroups v1 et le backend BoltDB », prévient Fedora. Citons également le passage de MySQL de la version 8.4 à 9.7, et celui de MariaDB de la version 11.8 à la 12.3. NetworkManager prend en charge par défaut les réseaux « IPv6-mostly ».

Sécurité : plusieurs serrages de vis

Plusieurs changements importants sont présents dans Fedora 45. D’abord, l’équipe indique avoir franchi la barre des 90 % de paquets reproductibles.

Pour comprendre l’intérêt, rappelons qu’un paquet est dit « reproductible » si, à partir du même code source, du même environnement de compilation et des mêmes instructions, n’importe qui peut régénérer une copie identique bit à bit du paquet publié. En clair, il s’agit d’un gage de sécurité de la chaine d’approvisionnement : c’est la garantie que le binaire téléchargé correspond bien au code source publié. Dans le cas de Fedora, toute non-reproductibilité détectée est considérée comme un bug et est traitée comme telle, via un rapport. La distribution n’est pas la seule à progresser dans ce domaine, d’autres comme Arch Linux ou NixOS font de même.

On reste dans le sujet avec la vérification désormais obligatoire des signatures par le gestionnaire de paquets RPM. Un mode de vérification stricte, conformément au comportement en amont introduit par la version 6.0, comme nous l’indiquions il y a un an. Ainsi, seuls les paquets dont la signature est vérifiée peuvent être installés, sauf dérogation explicite avec --nosignature ou l’API correspondante. Les RPM compilés localement et non signés sont directement concernés. Côté Fedora, ce changement se fait dans la foulée du passage à RPM 6.1.

Fedora 45 restreint également ptrace par réglage global dans le noyau qui retire par défaut certaines permissions de débogage aux utilisateurs non privilégiés. L’objectif est d’empêcher un logiciel malveillant d’inspecter les autres processus du même utilisateur. En revanche, si des outils de débogage sont installés, un fichier sysctl rétablit le comportement classique de Fedora 44 et des versions précédentes.

Autre changement significatif, le changement de fournisseur par défaut du service Secret. On passe ainsi de KWallet et GNOME Keyring à oo7. Écrit en Rust, il implémente la même interface D-Bus org.freedesktop.secrets, et se veut une alternative légère utilisable sur tous les environnements. Il est développé dans le cadre du projet linux-credentials et sert déjà de service de secrets natif pour COSMIC Desktop. D’après la fiche Fedora, oo7 doit permettre un modèle d’autorisation limitée par application ou par service, ouvrir la voie à l’authentification FIDO2 et mieux encadrer l’accès des applications isolées aux secrets.

On trouve d’autres modifications liées à la sécurité, comme l’interdiction par DNF5 de changer de fournisseur par défaut. Un changement important, car à moins d’une manipulation spécifique, un paquet installé ne peut donc plus être remplacé automatiquement par celui d’un autre fournisseur. Signalons aussi que chpasswd et newusers passent désormais par PAM et appliquent donc les politiques de mots de passe du système.

  •  

Airzone, Withings : quand des fonctions connectées gratuites deviennent payantes

Le trésor des données
Airzone, Withings : quand des fonctions connectées gratuites deviennent payantes

L’achat de matériels domotiques comprend souvent tout un lot de fonctions connectées pour les exploiter depuis d’autres plateformes. Il arrive pourtant que les entreprises derrière ces produits changent brutalement de logique commerciale, des capacités gratuites devenant tout à coup payantes. Plusieurs cas interrogent sur ces revirements.

La société espagnole Airzone commercialise des solutions de contrôle connectées pour le chauffage et la climatisation. Depuis fin octobre, les clients doivent décider s’ils payent pour une formule à 48 euros par an permettant de préserver certaines fonctions, notamment le pilotage à distance.

Ce changement est rétroactif et concerne donc l’ensemble des clients disposant déjà de produits Airzone. Comme l’un de nos lecteurs nous l’a signalé, cette bascule se fait dans la douleur, avec de très nombreux avis négatifs sur Trustpilot, la note moyenne de l’entreprise s’étant effondrée à 1,1 sur 5. L’instauration de la formule payante Airzone Cloud passe mal.

Plusieurs avis mentionnent un changement abusif dans les conditions d’utilisation et certains vont jusqu’à mentionner qu’un signalement a été fait auprès de la DGCCRF. « Quant à la clause vous autorisant à annuler unilatéralement cette gratuité ou à modifier les caractéristiques du service après l’achat, je vous rappelle qu’en droit français (Article L. 212 - 1 du Code de la consommation), les clauses permettant à un professionnel de modifier unilatéralement les conditions du contrat ou de supprimer une fonctionnalité essentielle du bien sont réputées abusives et nulles. Elles ne sauraient m’être opposées », fustige par exemple un client.

Ce changement n’est cependant pas une surprise. Il avait été communiqué en mai et Airzone précise depuis que les nouveaux clients ont droit à une période gratuite de six mois. Mais attention, car l’abonnement affecte d’autres aspects de l’utilisation, notamment un abaissement à un seul jour d’historique des données pour les graphiques intégrés, contre 1 à 3 ans dans la formule payante.

Comme le précisait alors iGen, Airzone est partenaire d’environ 200 fabricants d’équipements CVC, dont des pompes à chaleur et climatisations. Ses produits se retrouvent donc souvent dans des équipements vendus dans le commerce, rendant le changement particulièrement visible.

Le composant Webserver, nœud du problème

Une installation Airzone (qui comprend les registres motorisés, les thermostats et la carte centrale) doit fonctionner seule. On peut cependant demander à ajouter en option un composant nommé Webserver. Il se branche sur le bus domotique de la maison et connecte le tout au réseau.

Le Webserver est une option payante, ajoutée au devis pour pouvoir justement piloter l’installation domotique à distance. C’est un cas classique, qui permet par exemple de déclencher manuellement le chauffage ou la climatisation à l’avance quand on est sur la route du retour.

Or, comme mentionné par plusieurs clients dans les forums de QueChoisir, Airzone mettait en avant la gratuité du service liée à ce composant optionnel. Ils estiment que cet aspect a été un facteur important de la décision d’achat.

« J’ai acheté le webserver à la fin de l’hiver pour pouvoir piloter ma maison depuis mon téléphone. Si j’avais su que cela allait devenir payant je n’aurais pas dépensé cet argent, car maintenant si je ne paye pas l’abonnement (qui n’existait pas et dont personne ne m’a parlé au moment de l’achat) je reviens au point de départ », explique un client, qui évoque une « prise d’otage ».

« J’ai le système Airzone sur gainable Hitachi depuis plusieurs années. Depuis peu le contrôle extérieur par application est payant. Une honte quand on voit le prix d’achat du système sachant qu’avant cela était gratuit et qu’à la pose on m’a vendu ce système de réglage comme gratuit », indique un autre.

Nous avons contacté Airzone pour éclaircir ce point et mettrons cet article à jour en cas de réponse.

Le cas Withings

L’entreprise française Withings a également fait parler d’elle pour des raisons similaires. À la mi-octobre, l’entreprise a en effet introduit un changement particulièrement désagréable pour les nouveaux clients : pour les comptes créés depuis le 13 octobre, il est désormais nécessaire de passer par une formule payante Withings+ (10 euros par mois ou 100 euros par an) pour transférer les données vers des plateformes tierces. Les anciens utilisateurs ne sont pas concernés.

La décision a créé une vive polémique, notamment chez nos confrères de MacG, qui s’interrogeaient alors : cela ne revient-il pas à placer un verrou sur les données des utilisateurs ? La formule payante devient d’autant plus incontournable que parmi les plateformes tierces, il y a Apple et Google. Pour les personnes qui visaient des produits Withings dans l’idée de synchroniser et rassembler les données dans Santé (Apple) ou Health (Google), l’abonnement est nécessaire, alors qu’il s’agissait jusqu’à très récemment d’une fonction considérée comme basique. Même chose pour Strava.

Au micro de BFMTV, Vincent Brand, chef de produit numérique, a assumé pleinement le choix, évoquant une nécessité pour l’entreprise : « Si on veut que Withings soit encore là dans les années qui viennent, il faut compter sur un transfert de valeur. Avant, elle était sur le hardware, aujourd’hui, c’est la donnée », ajoutant que « le monde n’est plus le même aujourd’hui ».

Facteur « aggravant » autour du changement, Withings n’a pas fait de communication dédiée, frôlant l’effet Streisand. Il est simplement apparu dans une FAQ sur la page d’assistance et sur les écrans des nouveaux clients qui voulaient transférer des données. Interrogé sur ce manque de communication, Vincent Brand a simplement répondu : « On savait que nos clients allaient le voir ». Problème, la méthode peut donner l’impression que le changement a été introduit en douce. « On a sûrement fait quelque chose qui n’était pas totalement optimisé, c’est une certitude », a concédé le responsable. Et pour cause : cette information n’est pas disponible sur les emballages des produits, des clients s’estiment donc floués.

La compatibilité avec le Data Act et le RGPD s’est également posée. Mais pour Withings, il n’y a aucun problème : non seulement rien ne change pour les personnes souhaitant rester dans le seul écosystème Withings, mais les données personnelles peuvent toujours être récupérées. « Le RGPD et le Data Act sont bien évidemment respectés, notamment le droit à la portabilité ou l’interopérabilité ».

Et comme dans un nombre croissant de situations similaires, quelqu’un a décidé de contourner le changement. Un développeur s’est servi de Claude Code pour créer YourOwnWeigh pour récupérer les données et les synchroniser avec des plateformes tierces sans avoir à passer par l’abonnement. Disponible sur GitHub sous licence MIT, le projet se présente sous forme d’application web avec des composants en Python spécifiques à chaque plateforme (fonctionne sur macOS et Linux, bientôt sur Windows).

Grain à moudre

Tous ces cas – y compris celui de Wink en 2020 – invitent cependant à la réflexion sur les achats d’appareils connectés. Le point de vue commun est que la vente de matériel ne suffit pas, même si les deux changements diffèrent : Airzone fait payer l’usage d’une fonction, quand Withings fait payer la circulation des données.

Rien ne porte à croire que ce changement était envisagé dès le départ, mais qu’il s’agisse de contraintes économiques ou d’autres facteurs, la sentence est la même pour la clientèle. Pour les acheteurs prospectant dans la domotique ou la santé connectée, la question de la politique des données est donc encore plus importante. Il ne s’agit plus seulement de leur sécurité ou de la vie privée, mais de la manière dont leurs données seront exploitables à travers d’autres services.

Ces formules ont toutes pour trait commun de rendre payante une fonctionnalité qui était jusque-là gratuite. Il ne s’agit donc pas de formules premium au sens classique, qui reviendraient à payer un supplément pour des fonctions supplémentaires. Pour autant, aucune règle n’oblige actuellement un fabricant à annoncer, au moment de la vente, combien de temps un service restera gratuit, ni même s’il continuera d’exister.

Ces changements invitent quoi qu’il en soit à se poser la question avant d’acheter, car il ne suffit plus de savoir ce que l’objet sait faire le jour de son acquisition. Des projets comme Home Assistant ou YourOwnWeigh montrent que l’on peut presque retirer les fabricants de l’équation, mais il faut pour cela des compétences, du temps et parfois d’autres matériels spécifiques.

  •  

Le créateur de Rocky Linux a créé un noyau compatible Linux en 11 jours avec l’IA

Du code « jetable »
Le créateur de Rocky Linux a créé un noyau compatible Linux en 11 jours avec l’IA

Gregory Kurtzer, créateur de CentOS et Rocky Linux, a créé un noyau compatible Linux, nommé Ginux. Loin d’être une proposition concrète, le projet était surtout une expérience : était-il possible de proposer un noyau compatible principalement développé par IA ?

L’expérience fait parler d’elle depuis plusieurs jours. Gregory Kurtzer est loin d’être un inconnu, il est connu pour avoir créé CentOS, une distribution Linux 100 % compatible avec Red Hat Enterprise Linux (RHEL), dont elle est une reconstruction. Apparue en 2003, CentOS attire l’attention, jusqu’à ce que Red Hat commence à sponsoriser la distribution en 2014. Dans les années suivantes, Red Hat embauche progressivement les développeurs travaillant sur CentOS, jusqu’à récupérer la gestion du projet.

Décembre 2020, patatras : Red Hat met fin à CentOS et pousse Stream, sa variante conçue pour intégrer les nouveautés. Le positionnement est alors clair : Fedora pour son aspect laboratoire, CentOS Stream pour intégrer les nouveautés en vue d’une utilisation professionnelle, RHEL pour l’offre commerciale. Gregory Kurtzer, frustré par le nouveau positionnement de Red Hat, crée alors Rocky Linux, à nouveau une reconstruction de RHEL, avec la même compatibilité complète.

Alors quand le développeur annonce avoir créé un noyau compatible Linux, développé avec l’IA, le sujet attire l’attention. Mais pas toujours pour les « bonnes » raisons.

Un noyau compatible, pas un fork

Le projet Ginux est surtout une expérience. Il la présente sur X le 27 octobre comme « un nouveau noyau de système d’exploitation compatible avec Linux qui démarre Rocky Linux 10 avec systemd, le tout en utilisant l’ingénierie agentique dirigée par l’humain (HDAE) ».

Le noyau est conçu pour l’architecture x86-64 et est indépendant. Il ne s’agit pas d’un fork du noyau actuel. Le code utilisé est principalement écrit en Rust. Ginux propose sa propre gestion mémoire, son processus de démarrage, son ordonnanceur, son modèle de processus, ses systèmes de fichiers, son réseau, ses périphériques et sa couche de compatibilité Linux.

Sa particularité est d’implémenter l’interface binaire (ABI) de Linux afin de faire tourner les exécutables Linux existants, sans modification. Gregory Kurtzer indique que cette compatibilité est partielle : sur 375 appels système recondensés dans l’ABI Linux 6.12 en x86-64, 82 sont entièrement implémentés, 245 le sont partiellement et 48 sont refusés volontairement.

Dans l’architecture choisie par le développeur, les charges de travail sont réparties dans des environnements nommés « domaines ». Chacun dispose de ses processus, espaces d’adressage, systèmes de fichiers, points de montage, privilèges et cycle de vie. Il présente ces frontières comme plus marquées que les espaces de noms Linux et les conteneurs OCI (Open Container Initiative).

Source : Gregory Kurtzer

Des limites assumées

Gregory Kurtzer affirme que son projet a pris 11 jours. Il tâche de rester « humble » dans l’annonce en précisant plusieurs points. D’abord, le nom Ginux fait référence aussi bien à Greg qu’à GPT. Dans le README du projet sur GitHub, l’auteur plaisante : pour s’assurer que son égo reste contenu, le G est officiellement une référence à GPT, puisque le projet a été entièrement réalisé avec GPT-5.6 Sol.

En outre, Ginux ne fonctionne pour l’instant qu’au sein d’une machine virtuelle QEMU. Il n’y a donc ni profil matériel physique, ni support des GPU et disques NVMe, ni audit de sécurité indépendant. Le code est publié sous licence Apache 2.0 comme prototype de recherche.

Le développement cible principalement QEMU/KVM avec une configuration x86-64 Q35, et le dépôt documente aussi une exécution en émulation QEMU sur Apple Silicon. Kurtzer reconnaît que la couverture ABI est incomplète et le matériel peu pris en charge. Réseau, systèmes de fichiers, application des limites de ressources et sécurité demandent encore un travail décrit comme « considérable ».

Dans la méthode HDAE évoquée, c’est lui-même qui a fixé l’architecture, les contraintes, les jalons et les critères d’acceptation. L’agent, lui, menait la boucle d’implémentation : il était chargé d’écrire, démarrer, tester, diagnostiquer, corriger, recommencer face à des vérifications exécutables. C’est l’ensemble de ces actions qui ont alimenté une tâche unique confiée à GPT-5.6 Sol, produisant finalement 139 000 lignes de code et de tests, réparties sur un millier de validations Git environ.

Une expérience, pas un concurrent

En quelques jours, le projet a généré une attention croissante. Face à un nombre croissant de questions sur la possibilité que Ginux puisse concurrencer le noyau Linux, Gregory Kurtzer est intervenu le 29 octobre pour expliquer que « les gens passent à côté du but de Ginux » et que ce dernier n’a pas été conçu pour rivaliser avec Linux : « Ce serait idiot ! ».

Il considère le code produit comme jetable, car Ginux en tant que tel n’était pas le but de l’expérience. Il s’agissait bien du processus de création, c’est-à-dire confier à un agent un travail de longue haleine, guidé par une infrastructure, pour répondre à la question : « L’IA, dirigée par un ingénieur expérimenté, pouvait-elle construire et valider un système logiciel extraordinairement complexe ? ».

Il répète d’ailleurs que l’article de recherche documente la méthodologie, les résultats et les limitations, pas le noyau comme possibilité alternative. Il estime que les questions posées sur la méthode sont plus intéressantes que le résultat. Par exemple : « Combien de temps faut-il pour reproduire un problème, identifier la cause racine, implémenter une correction et valider le résultat ? Quelle intervention humaine est réellement requise ? ».

« Parce que la vraie question n’a jamais été de savoir si l’IA pouvait remplacer Linux. Même si elle peut remplacer certains aspects de sa fonction, elle ne peut pas reproduire la communauté, les normes, la collaboration, l’alignement ou la stabilité », affirme-t-il. Dans une autre publication le 30 octobre, il détaille d’ailleurs comment il a collecté les retours pour déclencher de nouveaux travaux, pour continuer à tester sa méthode.

Ginux est donc davantage une démonstration de faisabilité qu’un produit. Rien n’empêche bien sûr la communauté de s’emparer du projet et de le poursuivre. Rien ne permet d’affirmer que ce noyau alternatif, s’il était développé plus avant, offrirait des avantages concrets et mesurables par rapport au noyau Linux.

Si l’expérience a fait parler, c’est aussi parce que la question de l’IA agite largement le domaine du logiciel libre. La récente enquête publiée par Linux Foundation a montré en partie l’ampleur de ce questionnement, avec des développeurs et mainteneurs de projets dans une position ambivalente, entre abaissement du ticket d’entrée et besoins accrus de vérifier toute la production de code. Dans cette optique, l’expérience de Kurtzer donne un aperçu de ce qu’une IA, employée par un développeur expérimenté, peut accomplir quand elle est strictement encadrée.

  •  

IA : l’amende honorable de Proton a bien du mal à passer

Au feu !
IA : l’amende honorable de Proton a bien du mal à passer

Face à l’ampleur de la polémique, Proton a bien été obligée de réagir. L’entreprise suisse subit les foudres des utilisateurs et un torrent de réactions négatives suite aux révélations de 404 Media sur ses méthodes internes et son utilisation forcenée de l’IA.

Deux articles de 404 Media ont provoqué une crise au sein de Proton. Le 26 octobre, nos confrères révélaient le contenu d’un e-mail envoyé aux employés pour les avertir qu’ils allaient être « réinterrogés » au cours d’entretien sur la manière dont l’IA avait transformé leur travail. Le message laissait clairement entendre que leur emploi était menacé s’ils ne l’utilisaient pas assez. Le 29 octobre, deuxième article, cette fois pour détailler l’ambiance interne, avec un Andy Yen (CEO) très offensif, voire insultant avec les développeurs.

Le point le plus inquiétant pour les utilisateurs, comme vu sur Reddit et X notamment, semblait l’accélération de la production de code par IA au détriment de la sécurité. 404 Media avait mis en avant un échange sur Slack dans lequel un développeur demandait du temps pour réaliser des tests de pénétration sur du nouveau code. Andy Yen y répondait en critiquant la requête et en évoquant une « mentalité de loser ».

Proton cherche maintenant à éteindre l’incendie

Au soir du 30 octobre, plusieurs publications sont apparues. D’abord, un nouvel article de 404 Media pour indiquer que les « réentretiens » n’auraient finalement pas lieu. Selon nos confrères, Andy Yen a confirmé ce changement lors d’une réunion interne, estimant que le débat avait servi le but poursuivi : que l’IA devienne un sujet actif et que les développeurs se lancent dans une formation personnelle.

Il faut également éteindre publiquement l’incendie. Sur X et LinkedIn, dans la nuit du 30 au 31 octobre, le compte officiel Proton a publié un long message pour aborder plusieurs points de tension. Ainsi, l’entreprise n’installerait aucun logiciel sur les postes des développeurs pour surveiller leur utilisation de l’IA, une rumeur qui proviendrait d’un « malentendu sur le fonctionnement des logiciels MDM », ces derniers étant destinés à gérer des parcs d’appareils de manière centralisée.

« Ensuite, notre utilisation de l’IA ne se fera jamais au détriment de la sécurité. Au cours de l’année écoulée, contrairement à ce qui a été allégué, des couches supplémentaires de révision de sécurité ont été ajoutées pour faire face à la menace posée par des IA hostiles qui scrutent le code open source de Proton à la recherche de vulnérabilités. Notre code est open source, et sa sécurité reste ouverte à la vérification de tous », affirme l’entreprise.

Proton dit également vouloir faire preuve de transparence. Elle veut « ouvrir le capot » pour montrer comment elle utilise l’IA en interne. Elle compte par exemple publier des informations sur ses outils et rendre leur code open source, « y compris sur des versions plus avancées de Lumo avec des capacités accrues, qui n’ont jamais été mises à disposition en dehors de l’entreprise ». Lumo est pour rappel le chatbot maison, qui doit permettre d’utiliser l’IA sans envoyer d’informations chez les grandes entreprises américaines.

La société suisse promet en outre de communiquer des informations sur la manière dont les révisions de code et de sécurité sont réalisées. Elle veut se montrer transparente sur ses politiques en IA, y compris les domaines dans lesquels elle est autorisée ou interdite. « Au lieu de pouvoir seulement voir le code open source final que nous produisons pour vérifier la sécurité, vous pourrez également évaluer comment ce code a été produit », ajoute Proton, qui confirme à nouveau que les employés ne seront pas réinterrogés sur leur utilisation de l’IA.

Oui, mais…

Bien que l’entreprise cherche à contrôler autant les dégâts que possible, on peut relever plusieurs problèmes. D’abord, son amende honorable n’a été publiée que sur deux réseaux sociaux, X et LinkedIn. Le texte n’a pas fait l’objet d’une communication plus officielle, sur le blog de l’entreprise par exemple.

Ensuite, les bonnes volontés de Proton ne sont accompagnées d’aucune date. L’éditeur s’engage donc sur plusieurs processus, mais sans calendrier.

Sur la présence d’un logiciel qui analyserait l’utilisation de l’IA, la situation reste floue. On se souvient que Brad Butler, directeur technique, a indiqué que 90 % du code produit en octobre avait été généré par IA (a priori par Claude). La mesure semble donc exister quelque part, peut-être au niveau de GitHub via la console de Copilot.

La promesse de transparence autour de Lumo devra également être confrontée à la réalité, car ce n’est pas la première fois que Proton s’engage sur ce sujet. L’European Open Source AI Index avait en effet critiqué en aout 2025 la présentation initiale de Lumo comme « open source ». Selon cet index, seuls les codes des applications mobile et web sont ouverts.

Surtout, l’entreprise a désormais deux problèmes sérieux d’image. D’abord, sur son activité elle-même : Proton se présente depuis toujours comme l’alternative sécurisée aux grands groupes américains. Les extraits de conversations publiés par 404 Media ne vont pas exactement dans ce sens.

Ensuite, que ce soit sur X, Reddit ou LinkedIn, de nombreuses personnes remettent en question le rôle d’Andy Yen à la tête de l’entreprise, beaucoup appelant désormais à sa démission. Il est accusé d’avoir installé un climat délétère au sein de Proton, la course à la croissance et aux profits mettant en danger les fondements de l’offre logicielle. D’autres encore estiment que si l’IA est désormais incontournable, Andy Yen reste responsable de son utilisation forcée au point de mettre en danger les emplois et de ses insultes aux personnes qui réclament du temps pour tester le code produit.

  •  

☕️ Windows 11 a son nouveau menu contextuel et oui, il est « rapide »


Microsoft avait promis de remanier le menu contextuel de Windows 11 sur les fichiers. C’est désormais chose faite, avec la mise à jour KB5127936 disponible depuis peu en option. Ce qui signifie qu’elle n’apparaitra que si vous déclenchez une recherche volontaire de mise à jour dans Windows Update. Sinon, elle sera installée automatiquement le mois prochain.

Problème : comme toujours chez Microsoft, les nouvelles fonctions n’apparaissent pas tout de suite. Le nouveau menu contextuel est en cours de déploiement. Pour vérifier si vous l’avez après l’installation de la mise à jour, il suffit de vérifier en faisant un clic droit sur un fichier. Si c’est bien le nouveau menu, vous verrez une ligne « Personnaliser le menu » tout en bas. Il existe toutefois un moyen de forcer l’activation en passant par l’outil ViVeTool, dans un Terminal avec droits administrateur, via la commande :

vivetool /enable /id:60813048

Sur certaines configurations, cet ID peut ne pas suffire. Auquel cas, il faudra tenter avec la fin de commande « /id:49453572,60813048 », voire « /id:49453572,60813048,61934903 ». Dans notre cas, la commande simple a suffi.

Deux exemples de configuration du nouveau menu

Après un redémarrage, vous aurez alors le nouveau menu. Le jeu en vaut-il la chandelle ? Tout dépend de votre utilisation du fameux menu. Le nouveau est clairement plus réactif, ce qui était un point régulier de friction jusqu’ici. Surtout, le menu est maintenant personnalisable. En cliquant sur le dernier élément du menu, le panneau idoine s’ouvre dans Paramètres.

Les options sont assez nombreuses. On peut voir notamment une ligne permettant de retrouver les options Couper/Copier/Coller en liste, et plus les icônes en tête de menu. Il aura donc fallu cinq ans à Microsoft à comprendre qu’un élément aussi basique que le menu contextuel doit être réactif, personnalisable et que l’on ne casse pas plusieurs décennies de mémoire musculaire impunément.

La mise à jour KB5127936 contient d’autres nouveautés, comme une fenêtre modernisée pour AutoPlay, un affichage plus cohérent pour les résultats de recherche dans l’Explorateur, une nouvelle Gaming Task View en mode Xbox, ou encore l’intronisation officielle de la réinstallation par le cloud, que Microsoft avait présentée en juillet.

  •  

Danger autour d’une extension Claude Code vérolée dans la boutique de Cursor

Vous avez le week-end pour tout réinstaller
Danger autour d’une extension Claude Code vérolée dans la boutique de Cursor

Une version piégée de l’extension Claude Code pour Visual Studio Code a été distribuée le 29 octobre dans la boutique Cursor. Elle installait une porte dérobée SSH persistante. Même si le problème a été résolu, l’extension frelatée a été installée par environ 5 000 personnes et pose de nouveau la question des chaînes d’approvisionnement.

Dans la journée du 29 octobre, quelque part entre 10h27 et 21h35 (heure de Paris), une version vérolée de l’extension Claude Code pour VS Code a été distribuée dans la boutique de Cursor. Estampillée 2.1.313, elle est restée suffisamment de temps en ligne pour avoir été téléchargée. Les 5 000 personnes concernées sont actuellement contactées, a indiqué Cursor.

L’éditeur dit avoir supprimé la version, arrêté intégralement sa boutique d’extensions, audité les accès, renouvelé ses clés, reconstruit la boutique et fait mettre hors ligne le serveur de l’attaquant par son hébergeur. Les différents contrôles n’ont révélé aucune autre extension modifiée.

Où l’attaque a-t-elle commencé ?

Le principal point flou dans cette histoire est que l’on ne sait pas exactement quand tout a commencé. Tout dépend de qui raconte l’incident.

Chez Phorion par exemple, l’attaque est présentée comme une compromission de la fiche officielle sur Open VSX, la marketplace ouverte de la Fondation Eclipse pour l’écosystème des éditeurs API compatibles avec VS Code. Phorion affirme également qu’Anthropic a retiré la version 2.1.313 d’Open VSX, de npm et même du Marketplace de Microsoft pour VS Code.

OpenSourceMalware, qui a publié la première analyse, indique que l’échantillon analysé provenait bien d’Open VSX. Le site en a déduit une diffusion par npm et le Marketplace de Microsoft en se basant sur un constat : la version 2.1.313 n’y figurait plus. Il précise que la provenance de l’artefact n’est pas établie et que ses conclusions ne prouvent pas une compromission de la distribution officielle d’Anthropic. Et pour cause, les retraits de npn et du Marketplace peuvent n’être qu’une mesure de sécurité, dans l’optique de supprimer toutes les versions 2.1.313 existantes. Problème, pour l’instant, ni Anthropic ni Microsoft n’ont réagi publiquement à l’incident.

Chez StepSecurity, on affirme que la compromission a commencé chez Open VSX avant d’être étendue à Cursor, puisque la boutique de ce dernier est un intermédiaire dont la base se synchronise avec le registre Open VSX. Les contrôles de sécurité appliqués sur ce dernier sont limités, avec un examen portant sur les motifs malveillants les plus connus. Ce qui signifie que l’extension vérolée aurait passé non seulement ces contrôles, mais également ceux de Cursor, plus poussés.

Illustration de ces incertitudes, The Hacker News a mis à jour son article pour indiquer que la compromission venait de Cursor seul. Pour cela, il faudrait que l’infrastructure propre à Cursor ait été compromise, ce que l’éditeur ne dit pas clairement. Cependant, le nombre d’actions entreprises pourrait aller dans ce sens, Cursor ayant renouvelé ses clés et reconstruit son magasin.

Le fonctionnement du malware

Si on ne sait pas comment tout a commencé ni qui est réellement concerné, on connait en revanche mieux le fonctionnement du code malveillant, les analyses de Phorion, OpenSourceMalware et Cursor s’accordant sur les détails.

L’extension contient ainsi un chargeur de 66 lignes, placé en tête du fichier extension.js. Il se lance dès le chargement du module, sans nécessiter d’action de l’utilisateur et donc avant même de lancer une conversation avec Claude. Ce chargeur ajoute une clé publique SSH liée à l’attaquant dans le dossier ~/.ssh/authorized_keys, pour lui donner un accès distant permanent sur l’ordinateur de la victime. La clé est étiquetée « svc-telemetry » pour paraitre anodine.

Le code vérifie ensuite que le service SSH est présent et actif. Dans le cas contraire, il tente de l’activer. Sur la plupart des Mac et PC sous Windows, l’étape échoue, non seulement faute de droits administrateur mais aussi car le code contient des erreurs. Sur Linux, le code réussit.

Le malware cherche ensuite à faire établir une connexion sortante vers le serveur de l’attaquant et à la maintenir ouverte. L’attaquant n’a alors plus qu’à emprunter ce tunnel en sens inverse pour atteindre la porte SSH et entrer avec sa clé privée, ouvrant la voie vers un terminal et la possibilité de lancer des commandes.

Le code installe aussi un petit script qui se relance à chaque démarrage de l’ordinateur et retente la connexion une fois par minute. Sur macOS, ce script se déguise en composant Apple (com.apple.sysmond), sur Windows en tâche Sysmon ou en script dans le dossier Démarrage, et sur Linux en tâche planifiée. La désinstallation de l’extension ne suffit donc pas. Le code envoie enfin une fiche descriptive de la machine avec nom de l’ordinateur, utilisateur, système, adresse IP publique, adresse électronique Git et dossier de travail.

Cette charge utile ne vole donc en elle-même aucune information cruciale, mais elle prépare le terrain. Le danger vient avant tout de ce que le pirate peut réaliser une fois la connexion établie via SSH.

Des vérifications à faire

La fiche de Cursor sur l’incident, publiée hier soir, mentionne uniquement des vérifications à faire pour macOS et Windows. L’éditeur ne le dit pas explicitement, mais il semble que Linux ne soit curieusement pas concerné, malgré les détails techniques allant pourtant dans ce sens.

Faute de script officiel, les analyses de Phorion et OpenSourceMalware présentent une série de commandes bash. Dans les trois cas cependant, si une preuve de compromission est détectée, il faudra effectuer plusieurs manipulations. Mais la recommandation est claire : réinstaller complètement la machine sera l’option la plus sûre.

Cursor indique dans son billet que les 5 000 personnes (environ) qui ont installé l’extension modifiée sont contactées pour être averties du problème.

  •  

[MàJ] Chez Proton, le rouleau compresseur de l’IA écrase tout

Du travail pour les relations presse
[MàJ] Chez Proton, le rouleau compresseur de l’IA écrase tout

L’ambiance chez Proton est particulièrement difficile autour de l’usage de l’IA et de l’attitude du patron de l’entreprise, Andy Yen. C’est ce qu’affirme 404 Media dans un article. La société suisse a désormais un sérieux problème d’image à résoudre.

Mise à jour du 30 octobre à 18 h :

Selon un nouvel article de 404 Media, Andy Yen, CEO de Proton, a annoncé que les « réentretiens » des employés n’auraient finalement pas lieu. Ils visaient à identifier les développeurs qui n’utilisaient pas assez l’IA. Leurs emplois semblaient directement menacés.

Le nouvel article indique qu’une réunion s’est tenue aujourd’hui même, vendredi 30 octobre. Andy Yen y aurait reconnu un échec de communication de sa part, tout en annonçant que la poussée vers l’IA continuerait. Il aurait affirmé que ces nouveaux entretiens étaient à présent inutiles, car la situation avait abouti au résultat voulu : déclencher une vaste conversation sur l’IA et accélérer la formation. Une réorganisation serait prévue pour le mois prochain, mais aucune suppression d’emploi ne serait prévue.

Les salariés interrogés par nos confrères sont partagés. L’un d’entre eux y voit un progrès, un autre regrette l’absence de responsabilité de la direction, un autre encore évoque une simple gestion de crise. Selon ce dernier, les constats sur l’utilisation de l’IA passeront dans les évaluations annuelles et ne sont donc que différées.


Article original du 30 octobre à 12h02 : Proton est connue depuis des années comme l’entreprise suisse pourvoyeuse de solutions respectueuses de la vie privée. Et pour cause : tous ses produits communiquent en utilisant le chiffrement de bout en bout. En d’autres termes, personne ne peut voir ce qui transite ou est stocké, pas même Proton. Cependant, cette efficacité dépend étroitement de la manière dont la technologie est implémentée.

Selon un long article de 404 Media du 29 octobre, les employés craignent désormais pour l’intégrité du code. La raison ? Une obligation d’utiliser autant que possible l’IA, au point que la direction de Proton envisagerait de ne plus embaucher d’ingénieurs dès l’année prochaine, mais des chefs de produit utilisant l’IA, Claude étant largement cité.

Injonctions sur l’IA

404 Media dit avoir échangé avec huit employés actuels et un ancien, consulté des conversations Slack, des enregistrements de réunions ou encore un manifeste sur l’IA rédigé par le directeur technique de Proton, Bart Butler.

Un employé a par exemple demandé récemment s’il était possible de prendre quelques jours pour analyser le code généré et réaliser des tests de pénétration pour en mesurer le degré de sécurité. Selon nos confrères, le CEO de l’entreprise, Andy Yen, a répondu sur Slack qu’il s’agissait de « conneries et d’une attitude de perdant », que rapidité et sécurité étaient « bien sûr » compatibles et qu’il fallait arrêter de « réfléchir à comment être plus lent ».

Dans une ambiance électrique, Andy Yen a ouvert une adresse e-mail servant à signaler tout obstacle à une adoption plus large de l’IA. Selon 404, l’entreprise est même allée jusqu’à installer sur les postes des employés un logiciel mesurant la quantité de code produite par LLM. Le résultat, proclamé par le Bart Butler lui-même, est que 90 % du code écrit pour l’instant en octobre a été généré par IA. Sur cette proportion, une grande partie viendrait de Claude, selon plusieurs employés.

« Le train arrive, montez à bord ou soyez écrasés »

Le déclencheur de la colère semble avoir été un e-mail envoyé à tous les employés pour les avertir que des « réentretiens » allaient avoir lieu, chaque salarié devant être évalué sur son utilisation de l’IA par une personne extérieure à son équipe et à sa chaîne hiérarchique. Ces entretiens sont prévus pour la période du 4 au 11 novembre, les salariés devant apporter des exemples concrets de ce que l’IA a changé dans leur travail. L’e-mail avertit que ces entretiens auront des conséquences : « Votre capacité à vous aligner avec leurs vues déterminera votre avenir avec nous, ou si vous en avez un ».

L’attitude d’Andy Yen semble avoir largement changé en août. Dans une interview accordée à Wired, le patron indiquait alors que Proton s’était lancée dans l’IA à contrecœur, car la technologie impliquait une forme de surveillance. Yen avait même proclamé qu’il préférerait un monde sans IA. Le LLM maison, Lumo, était présenté comme une manière de faire de l’IA générative en préservant la vie privée des utilisateurs.

À la fin du même mois, le ton était déjà très différent en interne. « Le train arrive, montez à bord ou soyez écrasés. Ne soyez pas l’opérateur professionnel de fax à l’ère d’internet », a-t-il déclaré dans une conversation Slack.

« Je pense que d’ici la fin de cette année, la plupart des développeurs arrêteront de programmer et commenceront à écrire des spécifications pour des tests que l’IA va coder et exécuter, afin de valider le code écrit par l’IA que les humains ne pourront plus vérifier. Ce sera la dernière année où nous embaucherons des ingénieurs, et à partir de l’année prochaine, nous recruterons ce que nous appelions autrefois des chefs de produit, pour construire des choses avec l’IA »

Proton ne nie pas les révélations

Andy Yen cherche désormais à mettre en place une nouvelle équipe qui devra travailler nettement plus dur et poser les bases du futur pour l’entreprise. Le patron a explicitement mentionné son désir de voir Proton devenir une « entreprise 996 », en référence à une culture grandissante (en Chine et dans la Silicon Valley) de travailler de 9 h à 21 h, six jours par semaine. Les avantages matériels suivraient, avec notamment une hausse de 30 % du salaire et une carte bancaire dédiée aux frais professionnels.

Interrogée sur ce climat de peur et de pression, l’entreprise n’a pas nié : « Les temps de grands changements font peur, et l’industrie technologique dans son ensemble doit faire face à cette transition. Nous n’avons pas toujours communiqué nos intentions aussi bien que nous aurions pu, mais Proton s’engage à aider nos collègues à se reformer et à se requalifier pour l’avenir », a déclaré un porte-parole.

L’entreprise a cependant un sérieux problème d’image désormais, suite à l’article de 404 Media du 26 octobre sur l’e-mail qui semble avoir tout déclenché. Sur Reddit, la colère est palpable chez les utilisateurs, notamment ceux abonnés. Beaucoup affirment avoir résilié ou leur intention de le faire.

« Votre personnel était suffisamment qualifié pour obtenir son poste au départ. Si vous pensez maintenant que certains d’entre eux n’ont pas les compétences nécessaires pour s’adapter aux technologies évoluant à une vitesse ultra-rapide, vous avez clairement échoué en ne mettant pas en place un programme de formation d’amélioration continue efficace. Vous avez échoué en tant que direction. Vous les avez laissés tomber », affirme par exemple neilbaldwn.

  •  

☕️ Tor Browser 16 se dote de noms de fenêtres génériques


Nouvelle mouture majeure pour Tor Browser, dont la version 16 se fonde désormais sur Firefox 153 ESR, avec à la clé un an de changements techniques sous le capot. Dans son billet, l’équipe de Tor Browser indique que son audit annuel du code de Firefox a porté sur plus de 270 anomalies référencées dans Bugzilla, susceptibles de nuire à la vie privée ou à la sécurité.

Côté nouveautés, la plus visible est la refonte des paramètres, qui reprennent en bonne partie ceux de Firefox. Ainsi, la page Général disparaît et son contenu est réparti entre Apparence, Téléchargements, Onglets et navigation, Accessibilité et Langues. Les pages spécifiques à Tor – comme Connexion et Niveau de sécurité – ont été reconstruites avec les nouveaux composants de Firefox.

Certains réglages qui pourraient dégrader la vie privée ou faciliter la prise d’empreinte du navigateur sont masqués ou accompagnés d’avertissements. L’équipe du navigateur ajoute que les préférences personnelles sont gardées lors de la mise à jour.

Autre nouveauté importante, les titres de fenêtres génériques. Cette option (Confidentialité et sécurité> Protections contre les applications tierces) permet de remplacer tous les titres par « Tor Brower », avec pour objectif de barrer la route au système ou autres applications qui voudraient lire l’historique de navigation via les titres de fenêtres. L’équipe est en quête de retours sur cette fonction, qui a d’ailleurs été reversée à Firefox via deux nouvelles lignes dans le about:config :

  • privacy.exposeContentTitleInWindow
  • privacy.exposeContentTitleInWindow.pbm.
Source : Tor Browser

Outre une révision complète du manuel utilisateur, Tor Browser 16 introduit également une version ARM 64 bits pour Linux (Aarch64). Cette architecture était supposée dans la branche Alpha du navigateur, mais l’équipe recommande désormais de basculer sur la branche stable.

Puisque l’on parle d’architectures, Tor Browser 16 ne prend plus en charge les installations Linux 32 bits. « Heureusement, très peu de personnes devraient être touchées, car nous recevons actuellement environ 200 vérifications de mise à jour par jour de cette plateforme, contre un pic d’environ 4 000 en 2019. La plupart des utilisateurs 32 bits restants devraient pouvoir passer à la version 64 bits, sauf s’ils utilisent du matériel ou des versions de Linux obsolètes », précise le billet.

Quant à la version Android, elle reprend elle aussi les améliorations de Mozilla sur l’année écoulée, dont le passage progressif à Jetpack Compose, permettant une migration vers des interfaces « natives », autrement dit Material Design 3. L’équipe de Tor Browser rappelle cependant que Google limite la taille des applications distribuées en APK à 100 Mo, ce qui représente « un défi constant ». Il a fallu par exemple sortir le manuel utilisateur alors que l’équipe aurait préféré qu’il soit toujours consultable, indépendamment des conditions réseau.

  •  

Canonical se relance sérieusement dans son Ubuntu Core Desktop immuable

Un autre genre de confinement
Canonical se relance sérieusement dans son Ubuntu Core Desktop immuable

Après une première annonce en 2023, Canonical semblait avoir laissé tomber son idée d’un Ubuntu Core Desktop, un système pensé pour être immuable, atomique et attestable. Voilà pourtant qu’elle remet le couvert, affirmant cette fois accélérer le projet.

Pour comprendre les enjeux, il faut revenir aux définitions : qu’est-ce qu’un système d’exploitation immuable, atomique et attestable ? D’abord, immuable : c’est un système dont les fichiers essentiels sont en lecture seule. Avec ce fonctionnement, en théorie, aucun utilisateur ni aucune application ne peut les modifier.

Ensuite, lorsque l’on parle de système atomique, on évoque surtout ses mises à jour : elles s’appliquent soit entièrement, soit pas du tout. Les deux vont très souvent de pair, de sorte que le système vise une prévisibilité extrême, la base ne changeant pas. Les applications sont isolées, aussi bien du système qu’entre elles, chacune résidant dans son propre conteneur. Dans le cas de Canonical, vous l’aurez deviné, on parle bien de Snap.

Sur ce socle vient se greffer un système d’attestation. Une telle version d’Ubuntu doit ainsi prouver à tout moment ce qu’elle exécute. Interrogée, la machine peut démontrer quels logiciels elle fait tourner, simplifiant les vérifications et rendant les altérations plus complexes. Ce type de mécanisme passe souvent par un composant matériel dédié, TPM dans la grande majorité des cas.

Le retour d’Ubuntu Core Desktop

Dans son nouveau billet du 28 octobre, Canonical reconnait que la préversion de 2023 n’a pas été à la hauteur. Les débuts ont certes été encourageants, mais le projet est devenu très silencieux dès l’année suivante. Selon le site It’s FOSS, l’explication tient dans la manière dont Canonical avait dessiné son système, une grande partie du bureau (dont GNOME et l’écran de connexion) étant réunie dans un seul snap volumineux.

Dans le fond, le principe est inchangé. Tous les composants sont livrés sous forme de snaps, dont le chargeur d’amorçage, le noyau, l’environnement de bureau, les démons (services) et toutes les applications. Mais en pratique, l’approche est cette fois beaucoup plus modulaire. Canonical dit vouloir définir des interfaces claires entre les composants. Ainsi, le gestionnaire d’affichage, l’environnement de bureau, les serveurs multimédias, le réseau et les autres fonctions devront respecter des interfaces clairement définies sans dépendre d’une implémentation particulière.

Dans ce fonctionnement, chaque partie du bureau peut évoluer individuellement. C’est effectivement à la base la promesse des snaps et, plus généralement, de tous les conteneurs logiciels. Bénéfice de cette évolution modulaire, il ne serait plus nécessaire de reconstruire tout le système à chaque changement. Selon Canonical, ce facteur différencierait Ubuntu Core Desktop des autres systèmes immuables comme Fedora Silverblue ou openSUSE Aeon.

Conséquence, cette version du système n’obligerait pas à utiliser GNOME. Canonical indique s’être rapprochée de l’équipe de KDE Neon Core et avoir produit une variante de KDE Neon fondée sur Ubuntu Core.

Canonical vise trois cas d’usage pour la 27.04

L’entreprise explique qu’une équipe dédiée est désormais constituée pour travailler sur Ubuntu Core Desktop et que des préversions quotidiennes seront construites pendant le cycle de développement d’Ubuntu 27.04. Pour l’instant, la nouvelle équipe remet en place les chaînes de production d’images et fait le point sur la situation.

Canonical indique que trois cas d’usage prioritaires sont visés. D’abord, le navigateur, cas jugé le plus simple car Firefox et Chromium sont livrés en snaps depuis des années. Ils sont compatibles avec le système de permissions et peuvent donc accorder l’accès à la caméra et au micro.

Ensuite, le développement logiciel. Cette fois, la situation se complique : un système de fichiers en lecture seule et des permissions strictes ne font pas forcément bon ménage avec les habitudes des développeurs. De plus, des outils répandus comme Visual Studio Code fonctionnent en mode « classic », qui accorde de nombreuses permissions au système. VSC ne fonctionne d’ailleurs pas sur Ubuntu Core. Solution envisagée par Canonical : placer ces applications dans Workshop, un environnement de développement isolé propre à l’entreprise, tandis que les fenêtres associées seraient affichées sur le bureau principal. Canonical compare directement cette solution à WSLg (Windows Subsystem for Linux GUI) de Microsoft.

Enfin, le jeu vidéo, avec l’objectif affiché de pouvoir fonctionner aussi bien sur ordinateur classique que sur des consoles portables comme le Steam Deck. Techniquement, le snap de Steam satisfait déjà les exigences de confinement strict, mais il a été largement mis de côté ces deux dernières années. Dans l’idéal, les composants graphiques seront eux aussi modulaires, afin que Mesa et Proton puissent être mis à jour sans toucher au reste du système. Canonical dit aussi étudier des modes de commande où l’appareil démarre directement sur une interface de jeu plutôt que sur un bureau classique.

La route sera longue

Dans tous les cas, le principal obstacle est la disponibilité des applications en snaps. Core Desktop ne peut pas exécuter un autre format. Il faut également que les permissions soient gérées, afin qu’une application puisse toujours demander l’autorisation avant d’accéder à la caméra, au micro ou à un dossier personnel. Autre défi, la modularisation complète du bureau et la prise en charge de KDE Plasma au même niveau que GNOME.

Le projet reste jeune, voire très jeune. Canonical précise d’ailleurs que la version classique d’Ubuntu est là pour rester, aucun calendrier n’étant donné pour une éventuelle bascule par défaut sur Core Desktop. Concernant les variantes officielles du système (les flavors comme Kubuntu, Edubuntu, Xubuntu…), le billet indique que les mainteneurs concernés seront libres de proposer leur propre variante de Core Desktop, s’ils le souhaitent.

  •  

IA : chez Google, Carbon supplante déjà Argon

Oui, c'est compliqué
IA : chez Google, Carbon supplante déjà Argon

Argon tout juste présenté il y a un mois, Google l’éclipse déjà par un nouveau venu : Carbon. Il prend la tête des modèles de pointe de l’entreprise, mais il n’est pas encore disponible et les détails manquent.

Google a présenté Argon le 30 septembre comme premier représentant de la famille Gemini 4. Il n’a cependant pas été disponible de tout de suite, le LLM ayant dans un premier temps été examiné par le gouvernement américain. Le 13 octobre, le nouveau modèle a finalement été lancé publiquement. À peine deux semaines plus tard, voilà qu’Argon est déjà remplacé.

Son successeur se nomme Carbon. Il prend ainsi la tête des LLM frontière (de pointe) chez Google et, si l’on en croit les chiffres communiqués, de bon nombre de classements tous modèles confondus. Ce n’est pas tout à fait une surprise cependant, des rumeurs circulaient depuis trois semaines environ sur cette arrivée.

Des performances à l’avenant, mais…

Au vu des scores donnés par Google, Carbon est premier dans 15 des 17 benchmarks référencés. Il n’est derrière que sur deux des tests : FrontierSWE 2, où Carbon obtient 61,2 %, derrière GPT-6 Astra (65,5 %) et Opus 5.5 (62,3 %), et OSWorld, où Opus reste en tête avec 87,2 %, contre 81,5 % pour Carbon.

Artificial Analysis classe Carbon (en effort High) premier de son Intelligence Index v5.0 avec 59 points, devant Claude Opus 5.5 (58), GPT-6 Astra (57) et Argon (50). Attention avec cette version 5 de l’indice, car elle a été révisée pour limiter la saturation (les notes maximales devenaient souvent atteintes). 60 % des tests étant désormais privés ou à réponses non publiées, les scores ne sont pas comparables à ceux des versions précédentes.

Carbon surpasse son prédécesseur dans tous les cas de figure, avec des bonds parfois importants dans certains domaines, comme un passage de 42 à 54,8 % sur ExploitGym. La cybersécurité est d’ailleurs mise en avant par Google, qui précise tout de même que ses tests ont été menés sans aucun garde-fou. Impossible en l’état de savoir ce que les clients auront réellement entre les mains, même si ce n’est que l’un des nombreux points que Google n’aborde pas dans sa présentation.

Parmi les progrès que Google revendique face à Argon, on peut voir un taux de triche désormais à 0,0 % sur Terminal-Bench 4.0, une baisse de 80 % des alertes de désalignement graves dans ses environnements internes de développement, ou encore une réduction de moitié des réponses non étayées.

… peu d’informations concrètes

Problème, Carbon a beau sembler puissant, Google tait pour l’instant de nombreuses informations. La plupart des données fournies émanent de tests internes ou de formulations floues, par exemple sur l’utilisation enthousiasmée des employés qui l’ont testé pendant plusieurs jours. Google ne dit rien non plus de la disponibilité. Si l’on applique le calendrier d’Argon, la sortie publique pourrait intervenir dans deux semaines. Un petit nombre de spécialistes de la cybersécurité y a cependant accès, le nombre devant augmenter progressivement via le programme Fairwind.

Côté tarifs, puisque Carbon remplace Argon, il reprend les mêmes : 2 dollars par million de jetons en entrée, 10 dollars en sortie, avec une remise de 95 % sur les jetons d’entrée en cache. À l’issue de la période de lancement, le tarif passera respectivement à 4 et 20 dollars, mais Google ne donne aucun détail temporel. Carbon, comme Argon, est donc un modèle onéreux. Il est d’ailleurs épinglé comme tel par Artificial Analysis, dont l’indice maison affiche un coût de 7,76 dollars par tâche, qui reste cependant moins élevé que ceux affichés par les derniers modèles Anthropic en effort maximal.

Si Carbon est présenté explicitement comme un successeur d’Argon, sur lequel il est bâti, la gamme Gemini manque de lisibilité, d’autant qu’Argon reste au catalogue. Sa période promotionnelle se finit le 1er décembre, et on peut se demander si Google ne compte pas le retirer alors, pour laisser place à Carbon et sa propre période promotionnelle. Le nouveau venu serait sinon moins cher que son grand frère, ce qui n’aurait guère de sens.

  •  

Réveil, cadre photo, nouvelles enceintes : Amazon complète son offre domotique

La facture est salée
Réveil, cadre photo, nouvelles enceintes : Amazon complète son offre domotique

Amazon a présenté le 28 octobre une nouvelle série d’appareils Alexa. Si trois sont des révisions et améliorations, deux sont entièrement nouveaux : Alexa Photo Frame et Echo Time.

Automne oblige, de nombreux constructeurs lancent de nouveaux produits ou renouvellent leurs gammes. Chez Apple par exemple, depuis l’iPhone 18 Pro et l’iPhone Duo les produits se sont enchainés, notamment dans le domaine de la domotique, ou très récemment un MacBook Pro tactile dont on se demande pourquoi une arrivée aussi tardive sur ce créneau.

Chez Amazon, l’heure est au renouvellement des appareils Alexa. Cinq ont été présentés, dont trois sont des modernisations de produits existants et deux sont nouveaux. Mais rien de tout cela n’est prévu pour être disponible en Europe.

Alexa Photo Frame et Echo Time

L’Alexa Photo Frame est un cadre photo numérique de 10 pouces, conçu pour être davantage accroché à un mur que posé sur un meuble. L’écran est décrit comme semi-mat et antireflet et les prix de lancement sont de 199,99 dollars en noir, ou 229 dollars avec un cadre en bois (bouleau ou noyer). La disponibilité est immédiate, en tout cas aux États-Unis et dans certains marchés, mais pas en Europe pour l’instant. Pour le Vieux Continent, rien n’a été annoncé.

Le cadre photo est fait pour fonctionner avec Alexa+, qu’il faudra donc souscrire si ce n’est pas déjà fait. Il exploite le compte Amazon Photos pour choisir les images, en écartant automatiquement tout ce qui n’a pas lieu d’être affiché sur ce type de produit, comme les captures d’écran et les tickets de caisse. Via une commande vocale, on peut lui demander de se concentrer sur certaines catégories de photos comme des visages souriants, des personnes spécifiques ou d’autres thématiques.

L’autre appareil est un réveil, Echo Time. Il propose diverses fonctions comme un suivi du sommeil (désactivé par défaut). Il peut également déclencher une alarme « intelligente » quand ce suivi est activé, afin de vous réveiller dans une fenêtre de 10 à 60 min quand l’appareil détecte un sommeil léger avant l’heure prévue.

Affichant un design sphérique, l’appareil est équipé d’un écran 3,2 pouces personnalisable, avec « des centaines de cadrans d’horloge ». Amazon prend bien soin de préciser qu’aucune caméra n’est présente. L’Echo Time est commercialisé 199,99 dollars ou 209,99 pour une version « Kids », tout de même. Certaines fonctions nécessitent là aussi Alexa+.

Nouvelles versions pour Echo Dot, Echo Show et Echo Studio

On continue dans la domotique avec des renouvellements de produits existants.

À commencer par l’Echo Dot, la petite enceinte connectée ressemblant très fortement au HomePod Mini d’Apple. La petite boule intègre désormais un concentrateur domotique compatible Zigbee, Matter et Thread, ainsi qu’un répéteur Wi-Fi eero couvrant une surface d’environ 93 m² selon Amazon. La nouvelle mouture intègre également une puce Z23 d’Amazon, censée accélérer les traitements des commandes vocales sur l’appareil, puisqu’il est censé servir de pont entre les différents équipements connectés. La petite enceinte est vendue 99,99 dollars et réclame une nouvelle fois Alexa+.

L’Echo Studio reste sur son positionnement de version plus musclée de la Dot. La nouvelle version est présentée par Amazon comme son enceinte « la plus avancée », avec cette fois une caméra (13 mégapixels) et de l’intelligence visuelle. En clair, l’enceinte peut être utilisée comme caméra de surveillance lorsque l’on quitte le domicile et reconnaitre ce qu’elle voit. Cette reconnaissance s’applique à différents scénarios, comme la possibilité de lui montrer une boite de jeux pour en obtenir les règles. Ces fonctions ont besoin d’Alexa+. Un lien sera prochainement ajouté avec les équipements Fire TV pour transmettre les appels vidéo sur le téléviseur. Le tarif de lancement est de 249,99 dollars.

L’Echo Dot et l’Echo Studio

Amazon rappelle plusieurs éléments importants, comme la présence sur tous ses produits Echo d’un bouton physique permettant de désactiver les micros et caméras. En outre, des indicateurs sont fournis pour indiquer quand des données sont envoyées vers le cloud (une LED dans la nouvelle Echo Studio).

Enfin, Amazon renouvelle son Echo Show, son écran de contrôle pensé pour la cuisine. Il est maintenant équipé d’un écran 16 pouces et intègre pour la première fois Fire TV et une caméra à vision nocturne. L’appareil peut se mettre en plusieurs modes : organisateur familial, cadre photo ou encore tableau de bord domotique. Le cadre de l’appareil se veut 40 % plus fin que la gamme précédente et le prix débute à 499,99 dollars (en précommande). Pour ce prix élevé, le support mural et la télécommande Alexa sont fournis. Alexa+ est bien sûr de la partie.

Un plan 3D de la maison

L’Echo Show 16, dans son mode domotique, pourra en outre exploiter Alexa Home Map. Le service permet d’obtenir une vue 3D de sa maison pour y localiser tous les appareils connectés compatibles. « Vous pouvez contrôler les fonctions principales de l’appareil directement depuis la carte : tapoter pour éteindre les lumières, baisser le volume de votre musique ou vérifier vos caméras de sécurité », indique Amazon.

Source : Amazon

La création de cette carte commence avec l’adresse postale renseignée par l’utilisateur, pour obtenir une vue extérieure de la maison. Ensuite, il faudra se balader dans toutes les pièces avec un iPhone compatible (Android n’est pas encore pris en charge, pas même les propres tablettes Alexa d’Amazon) pour que le plan se dessine en temps réel. La fonction n’est cependant pas disponible immédiatement. Elle n’arrivera que plus tard dans l’année, sous forme de préversion.

  •  
❌