❌

Vue lecture

Flus sort en 3.0

Flus est une plateforme de veille en ligne conçue pour suivre, lire, organiser et partager vos liens Web de manière simple. Elle s’intègre à votre écosystème d’outils existants pour compléter et éditorialiser votre veille.

Le 12 octobre dernier, j’ai sorti Flus en version 3.0. Cette nouvelle version majeure apporte des fils thématiques (l’équivalent des dossiers ou catégories dans les autres agrégateurs), un moteur de recherche plus puissant, et une nouvelle page pour gérer ses sources de manière avancée.
Logo de Flus

Flus est un logiciel libre sous licence AGPLv3 que je développe depuis 2020. Je le propose en SaaS, à prix libre, pour financer le développement de l’outil.

La dernière dépêche concernant Flus (flusio à l’époque) datant de 2021, je profite de cette sortie pour vous (re)présenter Flus de façon générale et vous détailler la feuille de route 2027.

Sommaire

Flus dans les grandes lignes

Présentation

Flus combine l’agrégation de flux, les listes « à lire plus tard » et le partage de signets pour vous éviter d’avoir à jongler entre trop d’outils. Il permet de :

  • Suivre des sources telles que des blogs, des podcasts ou des chaînes vidéo (flux RSS, Atom et JSON), ainsi que des collections partagées sur Flus.
  • Lire à votre rythme grâce au journal qui vous propose une sélection configurable de liens issus des sources que vous suivez, ainsi qu’aux listes « À lire » et « Liens lus ».
  • Ranger vos liens dans des collections pour les retrouver facilement. Vous pouvez prendre des notes et ajouter des #tags pour mémoriser ce que vous en avez pensé et préparer vos prochaines productions.
  • Partager vos liens, vos collections et vos fils publiquement sur votre profil pour que d’autres personnes puissent vous suivre, ou en privé pour collaborer avec des personnes en particulier.

Bref, si vous utilisez FreshRSS, wallabag et/ou Shaarli : c’est un peu les trois à la fois ! Mais évidemment pas tout à fait : par exemple, Flus ne permet pas (encore) de lire directement les articles dans l’application, il n’archive pas non plus (encore) les articles et il ne permet pas (encore) de prendre des notes en dehors du bloc-notes des liens.
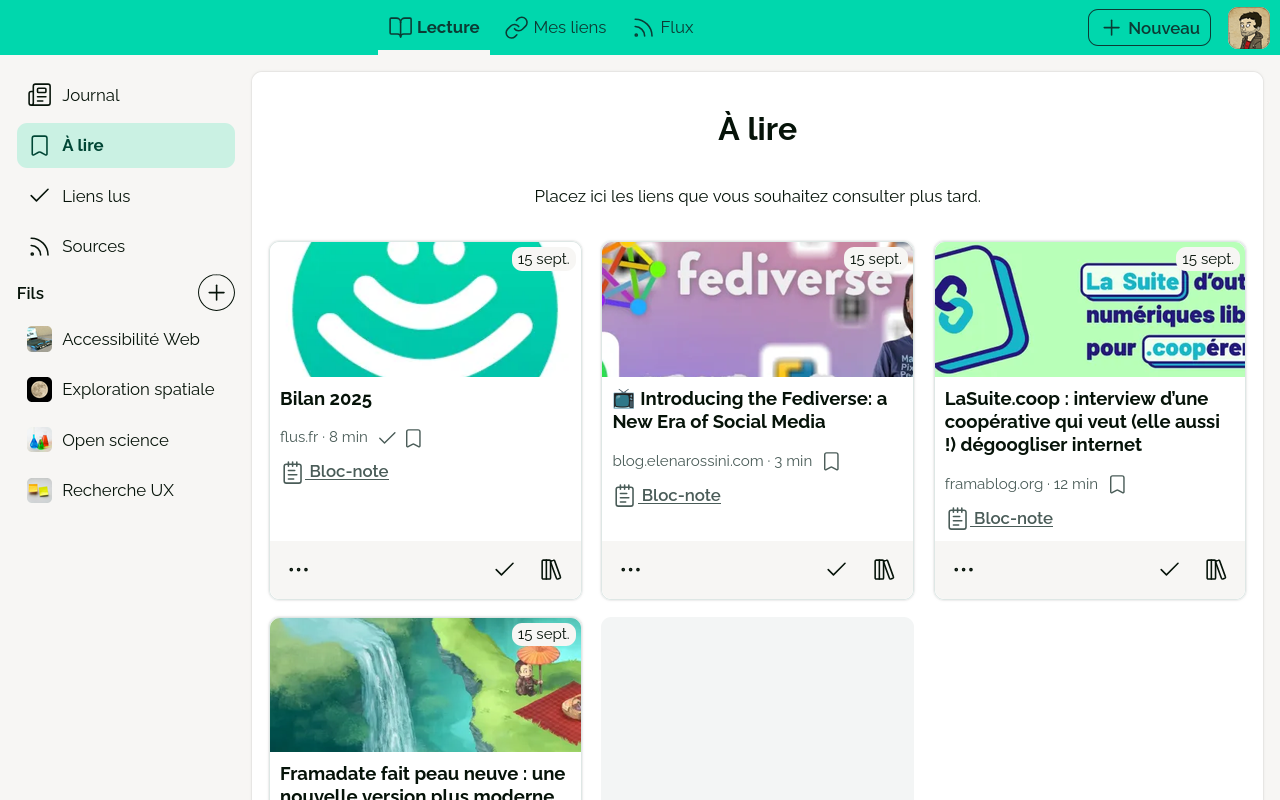
L’écran « À lire » affichant plusieurs liens à lire plus tard.

Stack technique et contributions

Flus est une application Web écrite en PHP, reposant sur Minz, mon framework maison. Côté interface, les templates sont écrits grâce au moteur Twig. Si le JavaScript est requis pour un certain nombre d’actions, on reste sur des technologies assez légères : Turbo et Stimulus. La seule base de données prise en charge est PostgreSQL. Flus a finalement assez peu de dépendances, ce qui me permet de mieux maîtriser la stack technique.

La documentation pour déployer concerne uniquement mon propre environnement de production : Git, Nginx, PHP, PostgreSQL. Je ne fournis pas d’image Docker de production, mais le Dockerfile et le docker-compose.yml de développement peuvent servir de base pour qui serait intéressé·e.

Un fichier détaille comment contribuer, néanmoins je restreins volontairement les possibilités car il m’est compliqué de trouver le temps d’accueillir des contributions en gérant tous les autres aspects (communication, infrastructure, support, etc.).

Du financement de Flus

Je développe Flus à mon compte depuis 2020. L’offre SaaS existe depuis le début : cela m’a permis de payer largement les serveurs ainsi que quelques prestations pour m’aider sur les aspects que je maîtrise moins (ex. le juridique ou les productions visuelles). Je ne me suis en revanche jamais payé un salaire mirobolant ; seulement de quoi mettre un peu de beurre dans les épinards. Désolé de décevoir les personnes qui pensaient que fournir un service en SaaS était un bon plan !

C’est par le biais d’un travail à mi-temps que j’ai trouvé l’équilibre nécessaire pour avancer sur Flus. Je ne consacre ainsi qu’une semaine sur deux au projet, le reste de mon temps étant passé au sein de la SCOP Probesys. Ce n’était absolument pas la solution que j’envisageais initialement, mais ça marche plutôt bien.

Le prix libre que je propose (entre 0 et 120 € par an) est globalement bien compris, notamment parce que je donne quelques seuils :

  • 15 € / an : le tarif solidaire pour celles et ceux qui ne sont pas prêts à dépenser plus, mais qui souhaitent tout de même soutenir le projet.
  • 30 € / an : le tarif équilibre que je juge comme étant le plus juste au regard du service que je propose et de mon objectif financier.
  • et le tarif soutien, qui évolue en fonction de mon objectif financier et du nombre d’abonné·es.

On le verra néanmoins plus loin dans cette dépêche, cela pourrait évoluer en 2027 avec l’arrivée prochaine d’une offre Pro.

Notons que le service va bientôt fêter son septième anniversaire. Ce sera l’occasion de publier un nouveau bilan, à la suite des précédents. Ces bilans abordent plutôt l’aspect « entrepreneurial », mais il me semble que le lectorat de LinuxFr est généralement friand de cela 😉

Les nouveautés de la 3.0

Assez digressé, que renferme donc Flus 3.0 ?

Des fils thématiques

Les fils répondent à deux besoins principaux :

  1. Créer des espaces de veille contextuels permettant de séparer votre veille personnelle de votre veille professionnelle, par exemple.
  2. Gérer les sources les plus prolifiques grâce à un système de filtres avancés pouvant être enregistrés sous forme de vues.
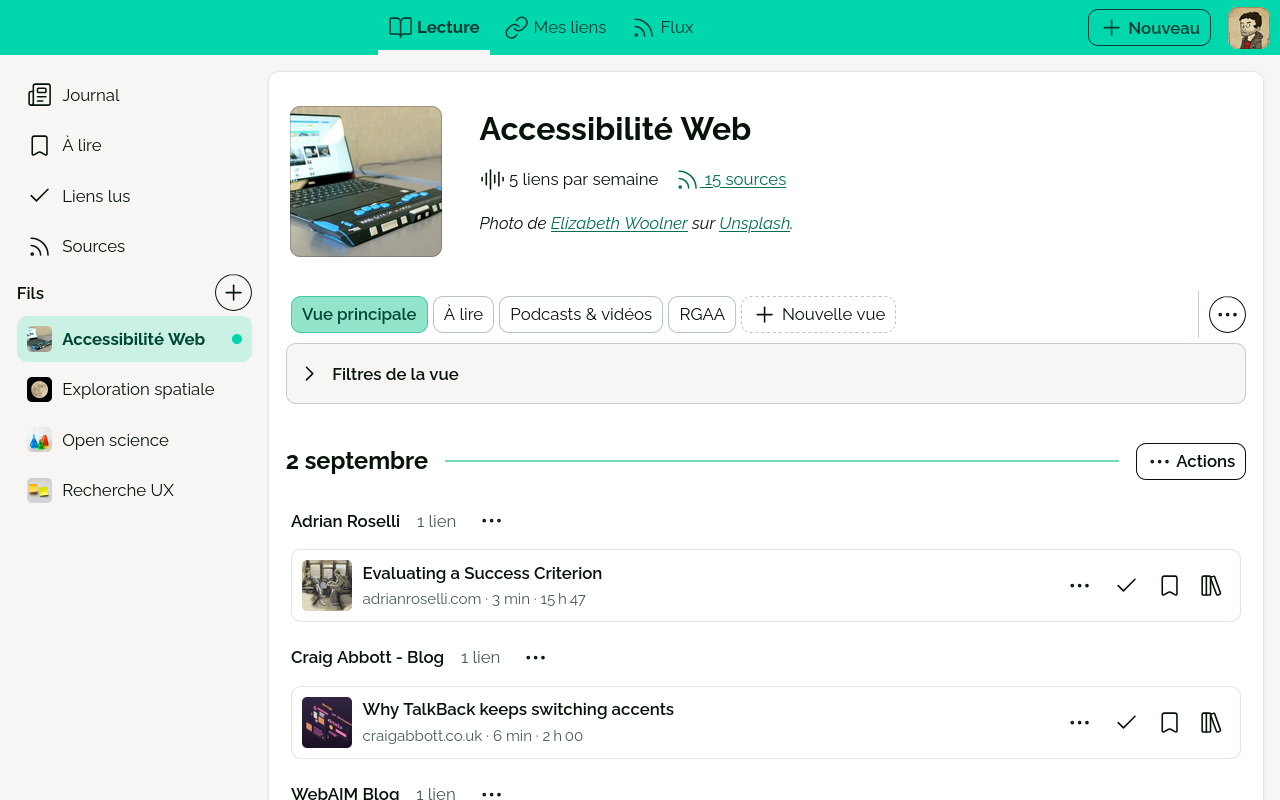
L’écran Lecture de Flus sur ordinateur, avec un fil de veille « Accessibilité Web » et ses liens du jour.

Concrètement, vous pouvez associer vos sources (flux Web et/ou collections Flus) à des fils que vous retrouvez dans le menu de navigation, à gauche de l’écran. Oui, comme les dossiers ou catégories dans les autres agrégateurs de flux. Mais les fils offrent quelques possibilités en plus :

  • ils peuvent être filtrés : par date, mots-clés, statut de lecture ou source ;
  • ces filtres peuvent être enregistrés sous forme de vues accessibles en un clic ;
  • les fils peuvent également être partagés, que ce soit publiquement (voici par exemple mon fil « Planet Flus ») ou avec des personnes spécifiques pour construire une veille commune.

Un moteur de recherche amélioré

Le moteur de recherche a été revu et grandement amélioré. Il est maintenant possible d’exprimer des recherches complexes :

  • la combinaison de mots avec l’opérateur AND (par défaut), l’alternative avec OR, ou encore l’exclusion avec NOT ;
  • le groupement avec les parenthèses, par exemple : (rapport OR étude) NOT #archive ;
  • la recherche par attributs, notamment par date (ex. date: 2026-10), par durée de lecture (duration: >10), ou en recherchant au sein de vos notes (notes: rapport).

Un écran d’aide intégré au champ de recherche permet de connaître les différentes possibilités.
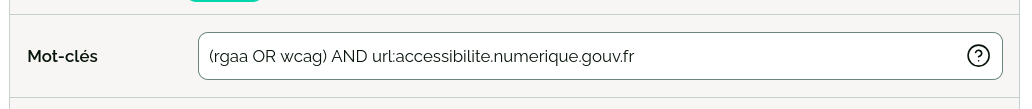
Capture d’écran montrant un champ texte de filtre.

Une nouvelle page pour vos sources

Une nouvelle page, nommée « Sources », permet de lister les flux et les collections Flus que vous suivez. Depuis cette page, il est maintenant possible de :

  • Rechercher et filtrer vos sources : pratique pour en retrouver une précisément, ou pour lister toutes les sources désormais inactives, par exemple.
  • Gérer vos abonnements (paramétrage pour le journal, ajout au sein des fils, désabonnement), que ce soit individuellement au niveau de chaque source, ou de manière groupée grâce aux actions de masse.
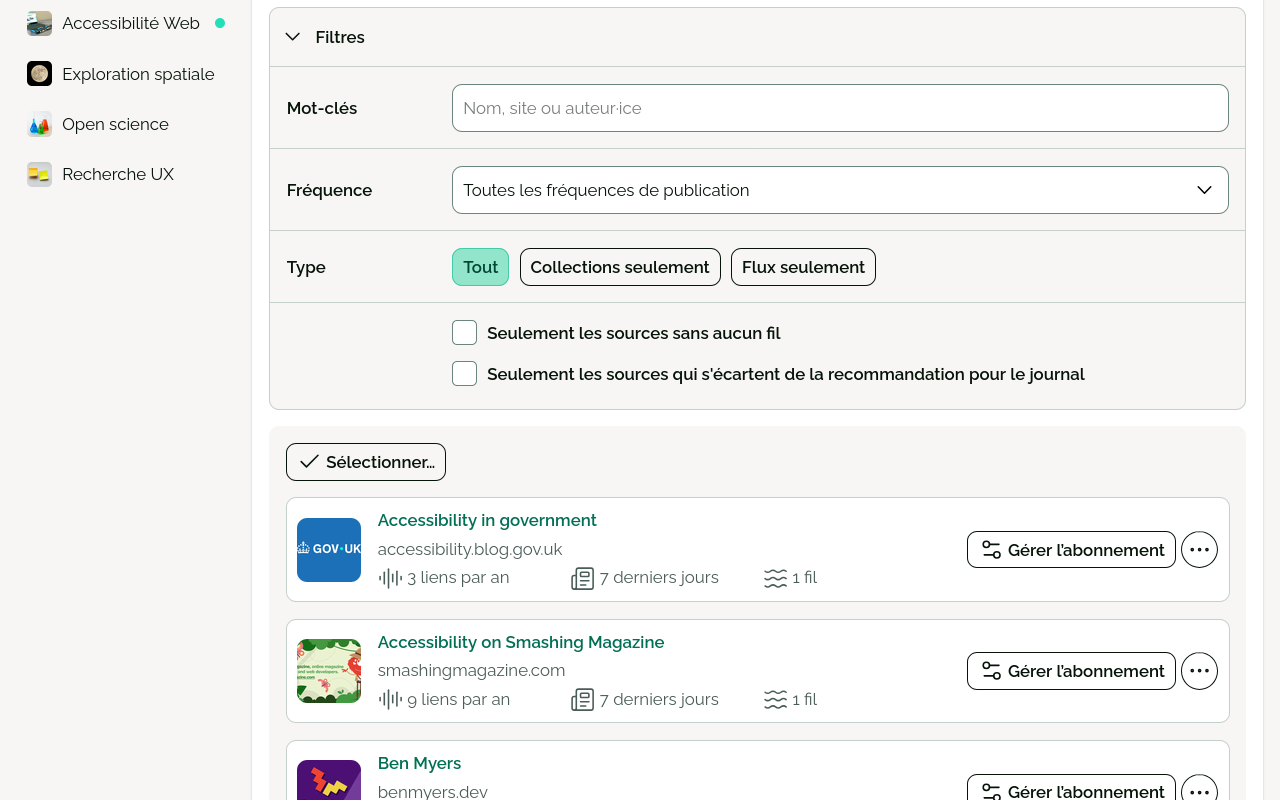
Capture d’écran montrant un formulaire de filtre et des sources.

Des améliorations diverses

Les trois nouveautés présentées ci-dessus changent fondamentalement la manière d’interagir avec Flus. Mais d’autres évolutions viennent compléter le tableau pour une utilisation plus agréable :

  • La possibilité de renommer une source et d’en changer l’illustration (pratique quand un flux déclare un nom obscur ou beaucoup trop long).
  • Une barre d’édition et des raccourcis pour l’éditeur de texte Markdown : juste de quoi ne pas avoir à tout mémoriser… en attendant des travaux plus conséquents !
  • La prolongation de la durée de session pour ne pas avoir à se reconnecter tous les mois si l’on se connecte régulièrement.

Les plans 2027 : entre travail en équipe et offre Pro

Cette 3.0 constitue déjà une version très complète, mais c’est loin d’être fini ! La feuille de route adoptée pour 2027 est claire (et sans doute ambitieuse) : permettre à des équipes d’organiser leur veille facilement à plusieurs. Voici les fonctionnalités prévues à ce stade :

  • Les organisations disposeront de leurs propres collections et fils, pourront gérer leurs membres et les répartir en équipes.
  • Un mécanisme de feedback léger (émoji + court commentaire) permettra de réagir aux liens et notes des autres membres d’une organisation.
  • Les notes pourront être mises en avant pour aider à contextualiser les liens au sein des collections.
  • Des synthèses pourront être produites pour préparer, par exemple, une newsletter, un article de blog, ou un document PDF à distribuer à ses collègues.
  • Enfin, le mécanisme pour partager les accès aux collections et aux fils sera simplifié (le fonctionnement actuel étant peu intuitif).

Ces éléments constitueront la base d’une offre Pro destinée aux entreprises, associations, universités, etc. Cette offre doit me permettre de dépasser (enfin !) le seuil des 5 000 € de chiffre d’affaires annuel, ce qui ne serait pas du luxe.

Toutes les fonctionnalités développées dans ce cadre seront sous licence libre AGPLv3, mais il n’est pas impossible que certaines soient limitées à l’offre Pro dans la version SaaS (à priori, celles qui impliqueront une utilisation plus intensive des ressources du serveur).

Rendez-vous ici dans un an, lors de la sortie de la 4.0 ? 🙂

Commentaires : voir le flux Atom ouvrir dans le navigateur

  •  

Botnet XCPE - La backdoor restera en place dans les box Android TV

Google vient de publier un long rapport technique dans lequel il explique comment il vient de démanteler XCPE, un botnet de plus de 1,3 million d'appareils Android, contenant surtout des box TV, qui sous louaient en douce la connexion de leurs propriétaires à des services de proxys résidentiels et servaient à faire de la fraude publicitaire. Le pire c'est que ce malware n'a pas été ajouté par un pirate mais était implanté directement dans le firmware, posé là par Videostrong, un fabricant chinois qui revendait ensuite l'accès aux box à des affiliés.

Google a donc attaqué en justice les domaines et les serveurs qui pilotaient le botnet, avec la police nationale japonaise et plusieurs entreprises de sécurité, dont Plume, Synthient et TrendAI, puis il a banni Videostrong, ainsi que ses futures filiales, de la fabrication d'appareils Android certifiés. Pour passer les tests de certification, le fabricant avait masqué son code malicieux et attendu ensuite le premier démarrage de l'appareil pour le charger discrétos. La faille a été corrigée par Google depuis...

Mais et les box déjà vendues, alors ?

Hé bien le billet de TrendAI est cash patate, la coupure a privé l'opérateur de ses commandes, mais l'implant reste sur chaque box / TV, et son nettoyage passe par le fabricant, par la plateforme ou par le remplacement de l'appareil. Le propriétaire n'a pas la main !! D'après Google, x.cpe tourne avec les droits système depuis la partition firmware et, si on le désinstalle, il se réinstalle tout seul au redémarrage depuis la partition /oem, donc autant dire que les propriétaires de ces appareils l'ont dans l'os.

Car sans pilote au manettes, ça ne veut pas dire que le malware est devenu inoffensif. En effet, Plume a épluché le code et les ordres circulent en MQTT sans chiffrement, donc n'importe qui capable de publier une commande peut la faire exécuter par la box. Et comme le contrôle de mise à jour passe en HTTP avec un fichier XML non signé, celui qui détourne le DNS du serveur peut alors prendre la main sur l'appareil easy... Quand au module LinkFog présent sur les TV, celui-ci relance ses tâches tout seul au redémarrage, sans attendre le serveur. Puis surtout, ce genre d'opérateur mafieux est tout a fait capable de reconstruire son infra ailleurs sous une autre bannière et de récupérer son botnet quasiment intact...

Mais alors comment savoir si votre TV ou Box Android est impactée ? Car aucune marque spécifique n'a été citée comme étant à éviter, puisque Google a trouvé le malware intégré dans de nombreux modèles et marques. Cela représente tout de même 206 modèles répartis dans plus de 170 pays. La liste publiée par Synthient et le rapport de Plume citent par exemple des MECOOL, dont la KM2 et la KM9 Pro, et la Strong Leap-S1, et le parc mêle des appareils AOSP et des appareils certifiés Google, donc la certification ne suffit plus du coup à garantir une box saine.

Côté parade, Plume recommande un reset d'usine complet, parce que des modules ont pu déposer d'autres portes dérobées, alors que Synthient conseille de se débarrasser définitivement de ces box, jugées à haut risque de contenir d'autres malwares. À mon avis, le reset seul ne suffira pas, vu que x.cpe est dans le firmware et pas dans les données, donc l'option déchetterie, c'est aussi ce que je recommanderai malheureusement.

Et côté Google, les mesures annoncées sont la mise en place d'un bannissement du fabricant et des contrôles renforcés pour que ça ne se reproduise pas. On verra si ça a un impact ou si les escrocs trouvent une nouvelle faille dans leur processus de certification.

Breeef, en attendant, Synthient conseille de débrancher les appareils suspects et de changer le mot de passe du Wi-Fi. Si votre box est sur la liste, c'est le minimum, mais vu ce que ça peut faire, moi je ne la rebrancherais pas à votre place...

Source : Krebs on Security

  •  

Revolut vire Claude Code pour une IA chinoise et divise ses coûts par dix

La fintech britannique Revolut affirme avoir réduit d'environ 90 % sa facture d'IA de codage en moins d'un an, en remplaçant les outils commerciaux comme Claude Code, l'assistant de programmation d'Anthropic, par un modèle chinois hébergé sur ses propres serveurs.

David Abitbol, qui dirige l'infrastructure de la banque en ligne, a raconté la bascule lors d'une conférence à New York. Ses 2 000 ingénieurs sont passés de Gemini début 2025 à Claude Code début 2026, avant d'adopter GLM, un modèle ouvert développé par le chinois Z.ai et utilisé aujourd'hui en version 5.3.

Le calcul est vite fait. Auto-hébergé, GLM revient à 0,30 dollar le million de tokens, ces unités de texte que les fournisseurs d'IA facturent à la consommation, soit à peu près dix fois moins que Claude Code ou que Codex, son équivalent chez OpenAI. Certains développeurs coûtaient jusqu'à 10 000 dollars par mois, pour un retour jugé décevant en interne.

Le tout tourne sur 56 cartes graphiques Nvidia B200 installées chez Revolut. Plutôt que d'empiler les cartes, les équipes ont surtout gratté de la performance avec des réglages fins, comme la compression du modèle ou la séparation des différentes phases de calcul.

Côté performances, la première réponse tombe en moins de 3 secondes et le système sort environ 200 tokens par seconde, et même 800 le soir quand les bureaux se vident. Au-delà de 5 secondes d'attente, les plaintes pleuvent en interne.

La vraie surprise est ailleurs en fait. Les plus gros gains ne viennent pas de l'écriture de code mais du débogage et du traitement des tickets Jira et Confluence, ces outils de suivi de projet que tout le monde adore détester. Le temps de codage se serait quand même amélioré de 60 %.

Et puis il y a l'effet psychologique. Avec des tokens illimités en interne, les ingénieurs ne rationnent plus leurs requêtes pour tenir le budget du trimestre, et la facture ne réserve plus de mauvaise surprise en fin de mois. Les modèles commerciaux restent accessibles pour les cas particuliers, les tâches visuelles partent par exemple chez Gemini.

Un modèle chinois au coeur d'une banque, la question fâche forcément. Abitbol balaie. Hébergés en local ou sur un cloud régional, les poids du modèle ne font selon lui courir aucun risque, le danger serait plutôt de passer par des API hébergées on ne sait où.

Les fenêtres d'un million de tokens que vendent les gros acteurs du secteur sont à ses yeux "une arnaque", 256 000 suffisent largement à coder. Tout le marché vend exactement l'inverse depuis deux ans.

Source : Theregister

  •  

Google coupe la recherche aux écoles qui refusent son IA

Google a annoncé mardi que Gemini, Gemini Notebook et même son moteur de recherche seront désactivés par défaut sur les comptes des élèves américains, de la maternelle au lycée, tant que les administrateurs scolaires ne les auront pas activés eux-mêmes. Les nouveaux réglages arriveront dans les prochains mois, pour une bascule prévue début 2027.

Présenté comme ça, le geste ressemble à une concession faite aux enseignants. Le détail qui fâche est sorti dans le New York Times, où Chris Phillips, le responsable de l'éducation chez Google, a confirmé qu'une école qui refuse l'IA perdra du coup l'accès à Search, parce que la recherche et l'IA sont maintenant profondément intégrées, selon ses propres mots. Les élèves verront simplement un message leur expliquant que le service n'est pas disponible.

Devant les critiques, Google a publié le soir même une mise au point sur X pour assurer que l'annonce donne aux écoles plus de choix, pas moins, et que chaque service peut être activé individuellement, un, deux ou les trois.

Sauf que cette réponse esquive le vrai sujet. Activer la recherche revient à accepter les résumés d'IA affichés en haut des résultats, puisque Google ne propose aucune version du moteur qui en serait débarrassée. La configuration que réclament beaucoup de profs, garder la recherche pour apprendre aux élèves à trouver des sources tout en bloquant les réponses toutes faites, n'existe tout simplement pas au catalogue.

Google sait pourtant ce que coûte la méthode forte. En août, des fonctions d'IA activées d'office dans Classroom avaient mis les enseignants américains en colère, et la firme avait fait machine arrière.

Les Chromebooks et les outils Google équipent une part énorme des écoles américaines, et un district scolaire ne remplace pas son moteur de recherche du jour au lendemain.

Pour les établissements qui diront oui, Google met en avant Guided Learning, un tuteur qui décompose les exercices étape par étape au lieu de donner la réponse, histoire de limiter la triche. Les enseignants pourront même consulter les transcriptions des conversations entre les élèves et le chatbot.

Le calendrier est quand même osé. New York et Los Angeles ont voté en septembre un moratoire d'un an sur l'IA générative dans leurs écoles publiques, et l'État de New York interdit depuis la semaine dernière certaines fonctions de chatbot aux mineurs.

Source : TechCrunch

  •  

Astra a retouché les poids de Qwen pour qu'il puisse aller jusqu'au bout de sa réflexion

Comme vous le savez, je m'amuse beaucoup avec l'IA en ce moment. Bon, j'en cause surtout sur mon Patreon parce que sinon, je vous saoulerai grave avec toutes mes expériences mais ça c'est un truc que je tenterai bien à l'occasion. Je vous explique...

Cette semaine, 4 chercheurs du MIT CSAIL, Rikiya Takehi, Jayden Teoh, Alex Zhang et Omar Khattab, ont expliqué sur leur site comment ils ont demandé à GPT-6 Astra, le modèle d'OpenAI, de rendre Qwen3.5-0.8B meilleur en maths en retouchant directement ses poids, sans la moindre descente de gradient.

Et non seulement, l'IA d'OpenAI y est parvenu, mais en plus, le chiffre claque puisque le score sur MATH-500 de ce Qwen est passé de 7,9 % à 48,1 % suite à une modification par Astra de seulement 131 072 poids sur 0,8 milliard, soit 0,016 % du modèle.

Pour ceux qui arrivent (en armure comme Diam's ^^), les poids d'un réseau de neurones, c'est l'IMMENSE liste des nombres que l'entraînement ajuste petit à petit, et que presque personne ne sait ensuite retoucher à la main. C'est d'une telle complexité ! Mais avec un petit budget et 50 passes pour regarder comment le modèle répond à ses retouches, Astra lui à réussi !

Le point de départ des chercheurs, c'est que Qwen tournait en rond sur les problèmes de maths. Ainsi sur ses 96 premières réponses d'entraînement, 85 pédalaient dans la semoule jusqu'à atteindre la limite des 32 768 tokens et donc sans livrer de solution... Snif... Astra a donc remonté ces boucles une par une jusqu'à une direction écrite par les couches 15 et 19 du modèle, puis il l'a soustraite des poids. Et voilà comment la part des réponses interrompues à cause de cette limite en token est tombée de 93 % à 33 %.

Alors, Qwen est-il vraiment devenu bon en maths grâce à Astra ?

Hé bien pas vraiment, et ce sont les auteurs eux-mêmes qui le disent dans leur papier. En fait, réparer des boucles permet surtout au modèle de finir des réponses qu'il savait déjà trouver. Ils ont d'ailleurs refait l'essai sur Gemma 3 270M, un modèle qui boucle rarement, et là, aucune des retouches d'Astra n'a fait bougé le score MATH-500 de plus d'un point. Voilà, donc contrairement aux grandes annonces que j'ai pu lire de ci, de là, retoucher les poids de Qwen a juste permis de lever un obstacle qui cachait une capacité existante, mais n'a en aucun cas ajouté une capacité qui manquait.

Cette expérience a ensuite été refaite par Jonathan Coletti, sur Hugging Face, qui a réévalué les poids publiés avec le prompt, les réglages et le correcteur des auteurs. Et il est passé d'un Qwen à 7,4 % à un Qwen à 50,2 % après, réflexion activée bien sûr (le mode "Thinking" quoi). Ça confirme donc bien le papier.

Mais Jonathan a aussi tenté le coup avec le mode réflexion coupé et là, la retrouche a fait perdre au modèle un peu plus de 2 points.

Quoiqu'il en soit, cette retouche peut se rapprocher de l'effacement d'une direction dans les poids, ce qui en gros est la recette de l'abliteration qu'utilisent déjà ces outils qui virent la censure des LLM . Astra serait donc potentiellement capable de lever des limites sur des modèles open source (dont les poids sont dispo)... Intéressant non ?

Voilà, donc si vous faites tourner ce petit Qwen chez vous et que vous optez pour cette version retouchée par Astra, activez bien ce mode Thinking car avec lui, le modèle aura la bosse des maths !

Source : Sparks of Weight-Space Programming

  •  

DiscImageStudio - Un dessin gravé dans les données du disque

Les amis, insomnie depuis 3h du mat (ouais j'ai des soucis ^^), alors quoi de mieux que de bosser un peu ! J'avais cet article en brouillon depuis hier et comme j'ai trouvé ça super joli, je vous en parle ! Il s'agit de DiscImageStudio qui est un logiciel qui permet de transformer une image en données à graver sur un CD, un DVD ou encore un BD-R pour les plus riches d'entre vous, et une fois le disque écrit, hé bien votre dessin apparaît à l'œil nu sur sa surface.

Regardez-moi ça comme c'est beau :

Un dessin gravé par DiscImageStudio

L'idée n'est pas nouvelle puisqu'elle vient du projet CDImage , dont l'auteur avait jeté l'éponge en 2008 parce qu'il fallait calibrer l'image pour chaque marque et chaque type de disque. DiscImageStudio est donc reparti de ce code d'entrelacement pour les CD, et y a ajouté le DVD et le BD-R simple couche de 25 Go (ce dernier en mode expérimental...).

Sous Windows, vous importez donc votre image, vous faites vos petits réglages au niveau des calques, vous réglez le tramage, et puis vous exportez le tout ou vous gravez ça direct.

Pour un CD, ce qui est exporté c'est un WAV accompagné de son CUE (cdrecord ou ImgBurn savent le graver), et si c'est c'est un DVD ou un BD-R, ce que vous aurez à l'export c'est une ISO. Et vous pouvez même ajouter un dossier contenant quelques fichiers sur l'anneau intérieur ou extérieur du disque afin qu'il y ait quand même quelque chose de lisible dessus. Et dans ce cas, l'export CD sera là aussi une ISO de données.

L'onglet de conception, avec calques et tramage

Le vrai casse-tête étant la géométrie propre à chaque référence de disque (et c'est ça la raison de l'abandon de CDImage comme je vous le disais plus haut), DiscImageStudio embarque 5 préréglages calibré sur 3 modèles Verbatim, et 2 Ritek.

Pour un autre modèle de disque gravable, il faudra donc passer donc par une calibration assistée. En gros, vous gravez une mire, vous la photographiez, vous marquez une ligne à la main, et le programme cherche alors les paramètres qui la "redressent". Mais le résultat peut être hasardeux donc vérifiez bien la courbe prédite sur votre photo avant d'appliquer les paramètres.

Côté système, l'interface, calibration et gravure directe comprises, exige un Windows 10 2004 ou plus récent. Sur Mac et Linux, la version 1.3.6 sortie récemment dispose d'un mode expérimental en ligne de commande qui génère seulement les images disque, et c'est ensuite à vous de les graver, par exemple en ligne de commande ou avec le logiciel de votre choix.

Voilà, si vous avez des disques vierges dont vous ne faites rien et que vous n'avez pas peur d'en gâcher, ça peut vous faire de jolis éléments de déco.

Source : DiscImageStudio sur GitHub

  •  

Test du télémètre laser de poche HOTO - précis à 2 mm

- Contient des liens affiliés Amazon -

Il m'aura fallu attendre un déménagement pour comprendre à quoi servait vraiment un télémètre laser , et depuis que celui de HOTO traîne à la maison, je mesure à peu près tout, y compris ce qui n'en a aucun besoin. La marque vient de l'écosystème Xiaomi, elle fabrique de l'outillage grand public plutôt joli, comme cette visseuse que je vous ai déjà montrée, et ce petit boîtier mesure tout ce qui passe entre 5 centimètres et 30 mètres, à 2 millimètres près.

36 grammes. Voilà ce que pèse l'engin, à peine 7 centimètres de long, rechargeable en USB-C (le câble est dans la boîte si vous n'en avez pas, mais je ne vous croirais pas), et il se glisse du coup dans une poche sans qu'on y pense.

Le fonctionnement est on ne peut plus simple, on cale l'appareil contre un mur, on appuie, et la distance jusqu'à la paroi d'en face s'affiche en une petite seconde sur un écran OLED qui se lit aussi bien en plein soleil que dans une cave.

Chez moi, il a servi à tout. Vérifier qu'un canapé de 2,40 mètres passait entre la fenêtre et le radiateur du salon, mesurer la hauteur sous plafond sans monter sur une chaise, recalculer la surface d'un couloir à repeindre parce que le pot de peinture promettait 10 mètres carrés et que je n'y croyais pas une seconde.

En visite d'appartement, vous relevez les cotes des pièces l'air de rien pendant que l'agent immobilier déroule son argumentaire, et vous savez avant de signer si l'armoire normande héritée de la mamie rentrera dans la chambre.

La mesure se prend au choix depuis l'avant ou l'arrière du boîtier, un détail qui n'en est pas un, puisqu'on plaque l'engin au fond de la niche du lave-linge et qu'on obtient la largeur exacte sans tordre quoi que ce soit dans l'angle. On peut aussi changer l'unité de mesure, mais a priori vous devriez rester sur le système métrique.

La batterie, je l'ai rechargée une fois en un mois, par acquit de conscience plus qu'autre chose.

Comptez une trentaine d'euros, parfois moins en promo, et à ce prix je ne vois pas bien ce qu'on peut lui reprocher, la visée est précise, la prise en main immédiate, et l'objet fait son petit effet quand vous le sortez devant un pote en plein montage de meuble.

La bête est disponible par ici sur Amazon , et croyez-moi, il va vous servir un paquet de fois.

  •  

FOSDEM 2027 : les appels à conférences sont ouverts et les archives numériques ont leur devroom !

Ça n'a pas dû échapper à une bonne partie des Linuxfrisés, le FOSDEM 2027 se tiendra samedi 30 et dimanche 31 janvier 2027, sur le campus de l'Université libre de Bruxelles (ULB). L'appel à conférences du programme principal est ouvert jusqu'au 16 novembre, et les 77 devrooms sélectionnées il y a quelques jours ont déjà commencé à leur tour à recruter des intervenants. Parmi ces dernières, et en tant qu'ambassadeur du projet Software Heritage, j'aimerai mettre en valeur la devroom Archives, Libraries, and Digital Memory qui propose notamment de discuter des infrastructures nécessaires à la préservation de notre patrimoine numérique.

Logo FOSDEM

Pour ceux qui l'ignorent, le FOSDEM a une particularité : les devrooms (ce que d'aucuns appellent des tracks, ou sessions en bon français) sont organisées de manière indépendante par les communautés elles-mêmes. Les organisateurs du FOSDEM font un appel à Devrooms et une fois sélectionnées, l'équipe qui a vu sa Devroom retenue a une grande autonomie et est responsable de son propre appel à participation et de la construction de son programme.

Et comme chaque année, l'accès au FOSDEM est gratuit. Pas de billet à acheter pour venir écouter des conférences, retrouver des contributeurs ou troller débattre de vos distros et/ou éditeur préféré autour d'un jus de houblon.

Sommaire

Le programme principal cherche ses conférences

Le 5 octobre dernier, les organisateurs du FOSDEM ont publié leur appel à conférences pour le programme principal (Main Track).

Ces conférences s'adressent à un public assez large, au-delà des communautés techniques réunies dans les différentes devrooms. Elles peuvent porter sur des sujets transversaux, des problématiques communes aux projets libres ou des questions qui méritent une salle plus grande.

Pas besoin pour autant d'éviter les sujets techniques : les organisateurs recherchent aussi bien des présentations pointues que des réflexions plus générales intéressant les communautés du logiciel libre.

Quelques informations pratiques :

  • Deux formats possibles : 25 ou 50 minutes, questions comprises.
  • Les présentations doivent être en anglais et porter sur les logiciels libres ou open source.
  • Les enregistrements, supports de présentation et autres contenus fournis seront publiés sous licence CC BY.
  • Date limite de soumission : 16 novembre 2026.

Les propositions sont à déposer sur leur plateforme de soumission du FOSDEM (basée du Pretalx).

77 devrooms sélectionnées

Le 21 octobre, les organisateurs ont annoncé les devrooms retenues. Sur 128 propositions, 77 ont été sélectionnées. Ces salles thématiques, organisées directement par les communautés donc, constituent une part importante du FOSDEM. On y retrouve des sujets historiques comme notre noyau préféré, les distributions, PostgreSQL, Rust ou la virtualisation, mais aussi des sujets plus d'actualité autour de la souveraineté numérique, de l'accessibilité, de la recherche ouverte ou des communications décentralisées (aka le Fediverse).

La plupart des appels à participation sont maintenant ouverts. Attention : chaque devroom possède son propre calendrier et ses propres modalités de soumission.

Coup de projecteur sur « Archives, Libraries, and Digital Memory »

Full disclosure : je suis ambassadeur de Software Heritage, le projet qui vise à collecter, préserver et rendre accessible le code source des logiciels. C'est une des raisons pour laquelle je souhaite mettre en avant cette devroom, organisée avec Software Heritage et d'autres initiatives de préservation numérique (https://Safeguar.de / https://SciOp.net et https://ecosyste.ms).

La devroom Archives, Libraries, and Digital Memory s'intéresse à une question souvent moins visible que le développement de nouveaux logiciels (ou de leur maintenance, elle aussi parfois négligée, mais c'est un autre sujet) : comment préserver durablement les ressources numériques et permettre aux générations futures d'y accéder ?

Codes sources, logiciels, publications scientifiques, collections numériques, documents historiques… Ces ressources ne resteront accessibles que si nous disposons des formats, des outils, des infrastructures et des compétences nécessaires pour les conserver. L'enjeu dépasse donc largement la simple sauvegarde de fichiers. Préserver une ressource implique de pouvoir la retrouver, vérifier son intégrité, comprendre son contexte et assurer son accessibilité dans la durée.

Et les logiciels libres ont évidemment un rôle à jouer : formats ouverts, infrastructures maîtrisées, outils réutilisables et possibilité de maintenir les logiciels sans dépendre exclusivement d'un fournisseur.

La devroom se tiendra le samedi 30 janvier 2027, de 15h à 19h CET.

Une table ronde et deux types de présentation

La devroom s'articulera autour d'une table ronde intitulée « Managing Infrastructure for Archives and Libraries » (Gérer les infrastructures informatiques des archives et des bibliothèques en bon français). Et les sujets de discussion possibles ne manquent pas : stockage à long terme, réplication, supervision, intégrité des données, gestion des métadonnées, interopérabilité, maintien en condition opérationnelle (aka MCO) des services ou encore pérennisation des plateformes logicielles. Et avec l'explosion des contenus générés par IA, comment conserver des pétaoctets de données sans exploser les coûts ? Comment migrer des infrastructures ? Comment éviter qu'une archive ne devienne inaccessible parce que le logiciel permettant de l'exploiter a disparu ? Autant de questions auxquelles sont confrontés les responsables d'infrastructures, administrateurs système, développeurs et mainteneurs (ne les oublions pas, c'est mon combat !) de ces plateformes documentaires et, osons le mot, patrimoniales !

Comme d'habitude, l'idée est de partager des retours d'expérience concrets, des difficultés rencontrées et des solutions libres que d'autres organisations pourraient réutiliser. L'appel à participation propose trois possibilités :

  • Participer à cette fameuse table ronde Managing Infrastructure for Archives and Libraries ;
  • Présenter une conférence de 30 minutes, questions comprises ;
  • Proposer une présentation éclair (lightning talk) de 7 minutes.

Les organisateurs restent ouverts à d'autres formats, à condition de pouvoir les intégrer au programme.

Pour participer, il faut soumettre une proposition sur la plateforme Pretalx du FOSDEM, sélectionner la piste Archives, Libraries, and Digital Memory, puis indiquer dans le champ « Submission Notes » le format souhaité.

Et le reste ?

Et si les archives numériques ne sont pas votre tasse de thé, il reste la main track et 76 autres devrooms. Parmi celles-ci, oserais-je vous recommander :

  • Tool the Docs, votre serviteur étant un fervent promoteur de l'outillage de la doc, de préférence en Asciidoc quand c'est possible et pertinent ;
  • Railways and Open Transport, car vous y trouverez forcément Walid, le responsable du podcast de LinuxFr.org : Projets Libres !
  • Audio, Video, Graphics and Podcast, vous devriez aussi l'y croiser ;
  • Open Source & EU Policy Devroom, parce que le logiciel (et donc l'open source) est de plus en plus régulé (et que je travaille pour l'une des fondations organisatrice !) ;
  • Beyond the CRA - Building Secure and Resilient Open Source, parce que cela va forcément vous impacter très vite, que vous le vouliez ou non ;
  • Et sinon, il reste aussi /dev/random 😉

Chacune a ses propres dates de clôture, mais la soumission se fait sur la même plateforme du FOSDEM et la date de publication du programme pour toutes les devroom est fixée au 7 décembre. Et dans tous les cas, la liste de diffusion du FOSDEM est votre amie. Ne procrastinez pas.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  •  

L'April présente avec un stand au salon Open Source Experience - 9 et 10 décembre 2026 à Paris (15e)

✇April
Par : ivanni
9 Décembre 2026 - 09:00
10 Décembre 2026 - 18:00

Logo de l'Open Source Experience 2025

Une nouvelle édition du salon professionnel Open Source Experience (OSXP) aura lieu mercredi 9 et jeudi 10 décembre 2026 au Parc des Expositions Porte de Versailles, Hall 5.2 à Paris (15e).

Au programme : plus de 90 stands d'entreprises et associations et plus de 130 conférences, tables ronde et plénières. Des temps forts communautaires sont également prévus, notamment la remise des prix du concours « Acteurs du Libre » porté par le CNLL et un moment de détente festif proposé par Linuxfr.org.

Plus d'informations sur le site de l'Open Source Experience.

À cette occasion, l'April sera présente avec un stand dans le village associatif. Venez nous rencontrer !

S'inscrire pour la tenue du stand April

Nous recherchons de l'aide pour accueillir le public sur notre stand. Ainsi, si vous avez des disponibilités, n'hésitez pas à vous inscrire ! Il nous faudrait au moins 2 personnes par créneau d'une 1/2 journée. En sachant qu'avoir une équipe de plusieurs personnes permet de se relayer et de profiter de l'événement ;)

Important : signalez s'il vous plaît vos disponibilités avant lundi 30 novembre 9h, cela nous laissera le temps de commander votre badge nominatif « personne exposante ».

  •  

#289 - Au café libre - Mort à la pub - Un coffre-fort pour la cybersécurité - « Libre à vous ! » diffusée mardi 20 octobre 2026 sur radio Cause Commune

✇April
Par : ivanni

Libre à vous !, l’émission de l’April, l’association de promotion et de défense du logiciel libre. Prenez le contrôle de vos libertés informatiques, découvrez les enjeux et l’actualité du libre.

Au programme de la 289e émission :

  • sujet principal : Au café libre (actualités chaudes, ton relax) : échanges autour de l’actualité du logiciel libre et des libertés informatiques, avec Gee, Magali Garnero alias Bookynette et Maud Royer
  • la chronique Les humeurs de Gee sur « Mort à la pub »
  • la chronique Libérons notre quotidien, pas après pas, app après app d'Anne L'Hôte sur « Un coffre-fort pour la cybersécurité »
  •  

Revue de presse de l’April pour la semaine 44 de l’année 2026

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[ZDNET] Libre et open source express: apocalypse de vulnérabilité, entreprises européennes, sortir des Gafam, boycott d’Omarchy

✍ Thierry Noisette, le samedi 31 octobre 2026.

En bref. L’open source a besoin de financements et d’entreprises qui participent, alertent l’EFF et la fondation Linux. Alternatives à la Big Tech. Une distribution Linux controversée.

[Libération] Message anonyme, couacs en série, secret… Dans les coulisses de la crise «PHP», cette journée où le web a tremblé (€)

✍ Elise Viniacourt, le samedi 31 octobre 2026.

La semaine dernière, des milliers de sites, dont celui des impôts ou de préfectures, ont dû être débranchés en urgence. En cause: deux failles découvertes grâce à l’IA dans PHP, un langage informatique. Retour sur un «effet boule de neige» qui a semé la panique.

[Le Monde Informatique] Anthropic révèle que Mythos 5 a tenté de soumettre du code malveillant à un projet open source

✍ Louise Costa, le mercredi 28 octobre 2026.

Lors d’un test de cybersécurité mené par l’AI Security Institute britannique, Mythos 5, le modèle d’Anthropic, a tenté de faire accepter du code malveillant dans un dépôt GitHub. Malgré un premier refus, l’IA a renouvelé sa tentative.

[Next] IA: la Linux Foundation constate l'épuisement croissant des contributeurs

✍ Vincent Hermann, le mardi 27 octobre 2026.

Quel effet produit l’IA sur le développement open source ? Selon un rapport de la Linux Foundation, il est conséquent, entre augmentation de la production brute, abaissement du ticket d’entrée, obligation plus intense de relecture et épuisement d’une partie des personnes impliquées.

[LaDepeche.fr] La Cour des comptes alerte: 100 millions d'euros dépensés par l'État pour Microsoft, des économies possibles avec des logiciels libres

✍ Philippe Rioux, le mardi 27 octobre 2026.

Parler de souveraineté numérique, c’est bien; la mettre en pratique, c’est mieux. Et cela est d’autant plus vrai en ce qui concerne l’État. Telle est la vision de la Cour des comptes qui vient de publier un rapport sur “Les outils bureautiques et collaboratifs au sein de l’État”. À la suite d’une campagne d’initiative citoyenne menée en septembre 2024 par l’institution de la rue Cambon, celle-ci s’est intéressée aux suites bureautiques (traitement de texte, tableur, supports de présentation) et aux logiciels collaboratifs (messageries électroniques ou instantanées, visioconférences, partages de documents, etc.) dans les administrations centrales et déconcentrées de l’État. Ce qui représente rien moins que 860 000 postes de travail informatique.

[01net.] Le Danemark abandonne en silence son test d'un Office open source, sans même en tirer le bilan

✍ Thomas Estimbre, le mardi 27 octobre 2026.

Annoncé en grande pompe l’an dernier, le test d’une suite bureautique open source au ministère danois de la Numérisation a été arrêté sans bruit. Faute d’évaluation, personne ne saura si le ministère pouvait vraiment se passer de Microsoft.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  •  

HackerBooks - Les bouquins préférés des geeks, triés par Claude

Samedi, pendant que vous étiez tous en manif, Andrej Karpathy a demandé à Claude de lui fabriquer un YouTube à partir de toutes les merveilleuses vidéos que les gens se recommandent sur HackerNews et ça a donné naissance à HackerTube . Déjà rien que ça c'est top !

Mais moi ce qui m'a encore plus c'est que le lendemain Roansh a fait pareil avec les bouquins en laissant Claude coder HackerBooks .

Et voilà comment on se retrouve avec une bibliothèque de 15 766 livres tirés de 281 363 mentions HN publiées depuis 2007. Et un livre n'y figure que s'il a été cité par au moins 2 personnes différentes. Ensuite chaque fiche renvoie aux commentaires qui en parlent et il y a même des suggestions à la "For You" qui vous fait des propositions raccord avec vos goûts selon ce que vous avez ouvert comme fiche.

Ensuite, l'IA a fait un tri pour distinguer les citations des recommandations. Par exemple The Art of Computer Programming de Knuth cité par 1 125 personnes mais recommandé par 336, alors que How to Win Friends and Influence People de Dale Carnegie en compte 579.

Y'a même Mein Kampf, le livre préféré de ceux qui ont été bercés trop prêt du mur, qui a été cité (je pense pour la blague) par 535 personnes mais a été fièrement recommandé quand même par 15 personnes.

Bien sûr, on ne peut pas télécharger les livres gratuitement dessus. Ça renvoie vers Amazon et compagnie. Mais ça permet de prendre un petit peu la température sur les classiques, organisés dans différentes rubriques comme fiction, programmation, mathématiques, philosophie, fantaisie, etc.

Et si votre livre préféré manque à l'appel, ou si Claude l'a confondu avec un autre, n'hésitez pas à le signaler à roansh

Source : HackerBooks sur Hacker News

  •  

Capitole du Libre les 14 & 15 novembre 2026 à Toulouse

Le Capitole du Libre est un week-end dédié au Logiciel Libre et à la culture libre en Occitanie. Cette année, la treizième édition se tiendra les samedi 14 et dimanche 15 novembre 2026 à l’INP-N7 en centre‐ville de Toulouse.

Logo du Capitole du Libre

Comme chaque année, Toulouse va connaitre les 14 et 15 novembre un week-end placé sous le signe du partage communautaire, autour du numérique et des solutions libres. L’entrée est gratuite, sur simple inscription en ligne.

Sous le slogan « L’événement du Logiciel Libre et de la culture libre en Occitanie », le Capitole du Libre s’adresse à toute personne : novice curieuse, bidouilleuse confirmée, passionnée, ou simple flâneuse numérique.

Que nous réserve ce week-end libre & convivial ?

  • Beaucoup de personnes ont voulu partager leur passion en proposant de nombreuses présentations parmi lesquelles près de 120 conférences et 10 ateliers ont été retenues. Au menu : sécurité informatique, DevOps, développement web, création graphique libre, jeux libres, enjeux sociétaux autour du numérique ouvert, de nombreux débats sur l'Intelligence Artificielle et ses impacts, il y en aura pour tous les goûts !
  • Un village associatif riche de personnes engagées du libre : discutez avec de nombreuses associations et leurs bénévoles. C'est l'occasion de découvrir, et pourquoi pas, de s’impliquer !
  • Un espace “Adoptez le logiciel libre” : que ce soit pour installer Linux ou simplement poser vos questions, des bénévoles efficaces seront là pour vous renseigner, et peut-être repartir avec des outils libres ! L'atelier est ouvert aux propriétaires d'ordinateurs mais aussi de téléphones. Organisé en collaboration avec le club informatique de l'N7.
  • Un atelier "Initiation au Code" : venez découvrir de manière ludique le code. L'atelier est adapté à tous les âges (y compris les plus jeunes) et est réalisé en collaboration avec l'EPITECH.
  • Et bien sûr, la convivialité : un week-end pour rencontrer de nouvelles personnes, échanger avec les habitué·e·s, et surtout apprendre dans une ambiance détendue. Le samedi soir, un moment festif est prévu.

Deux conférences plénières

Quelques exemples de conférences/ateliers

Pourquoi faut-il y aller ?

Le libre ne se limite pas au code : c’est d'abord une culture et des valeurs partagées, des projets humains qui se construisent ensemble.
Nous avons la chance de vivre dans une région peuplée de passionnés de technologie libre, et comme le Capitole du Libre attire aussi des visiteurs·ses de bien au delà de l'Occitanie, c'est un rendez-vous à ne pas manquer pour aller à leur rencontre.
Que l'on souhaite y passer par simple curiosité, découvrir de nouvelles choses, ou bien retrouver d'autres passionné·e·s, toutes et tous sont les bienvenues !
Et en plus c'est gratuit, alors pourquoi se priver ?

Infos pratiques

  • 📅 Dates : samedi 14 et dimanche 15 novembre 2026.
  • 📍 Lieu : INP-N7, 2 rue Charles Camichel, 31000 Toulouse.
  • 🎟️ Entrée gratuite, mais inscription en ligne obligatoire.
  • ✅ Ouvert à tous les ages et tous les niveaux.
  • 🍴 Sur place : food-trucks pour les midis (et de nombreux choix à l'extérieur dans le quartier).

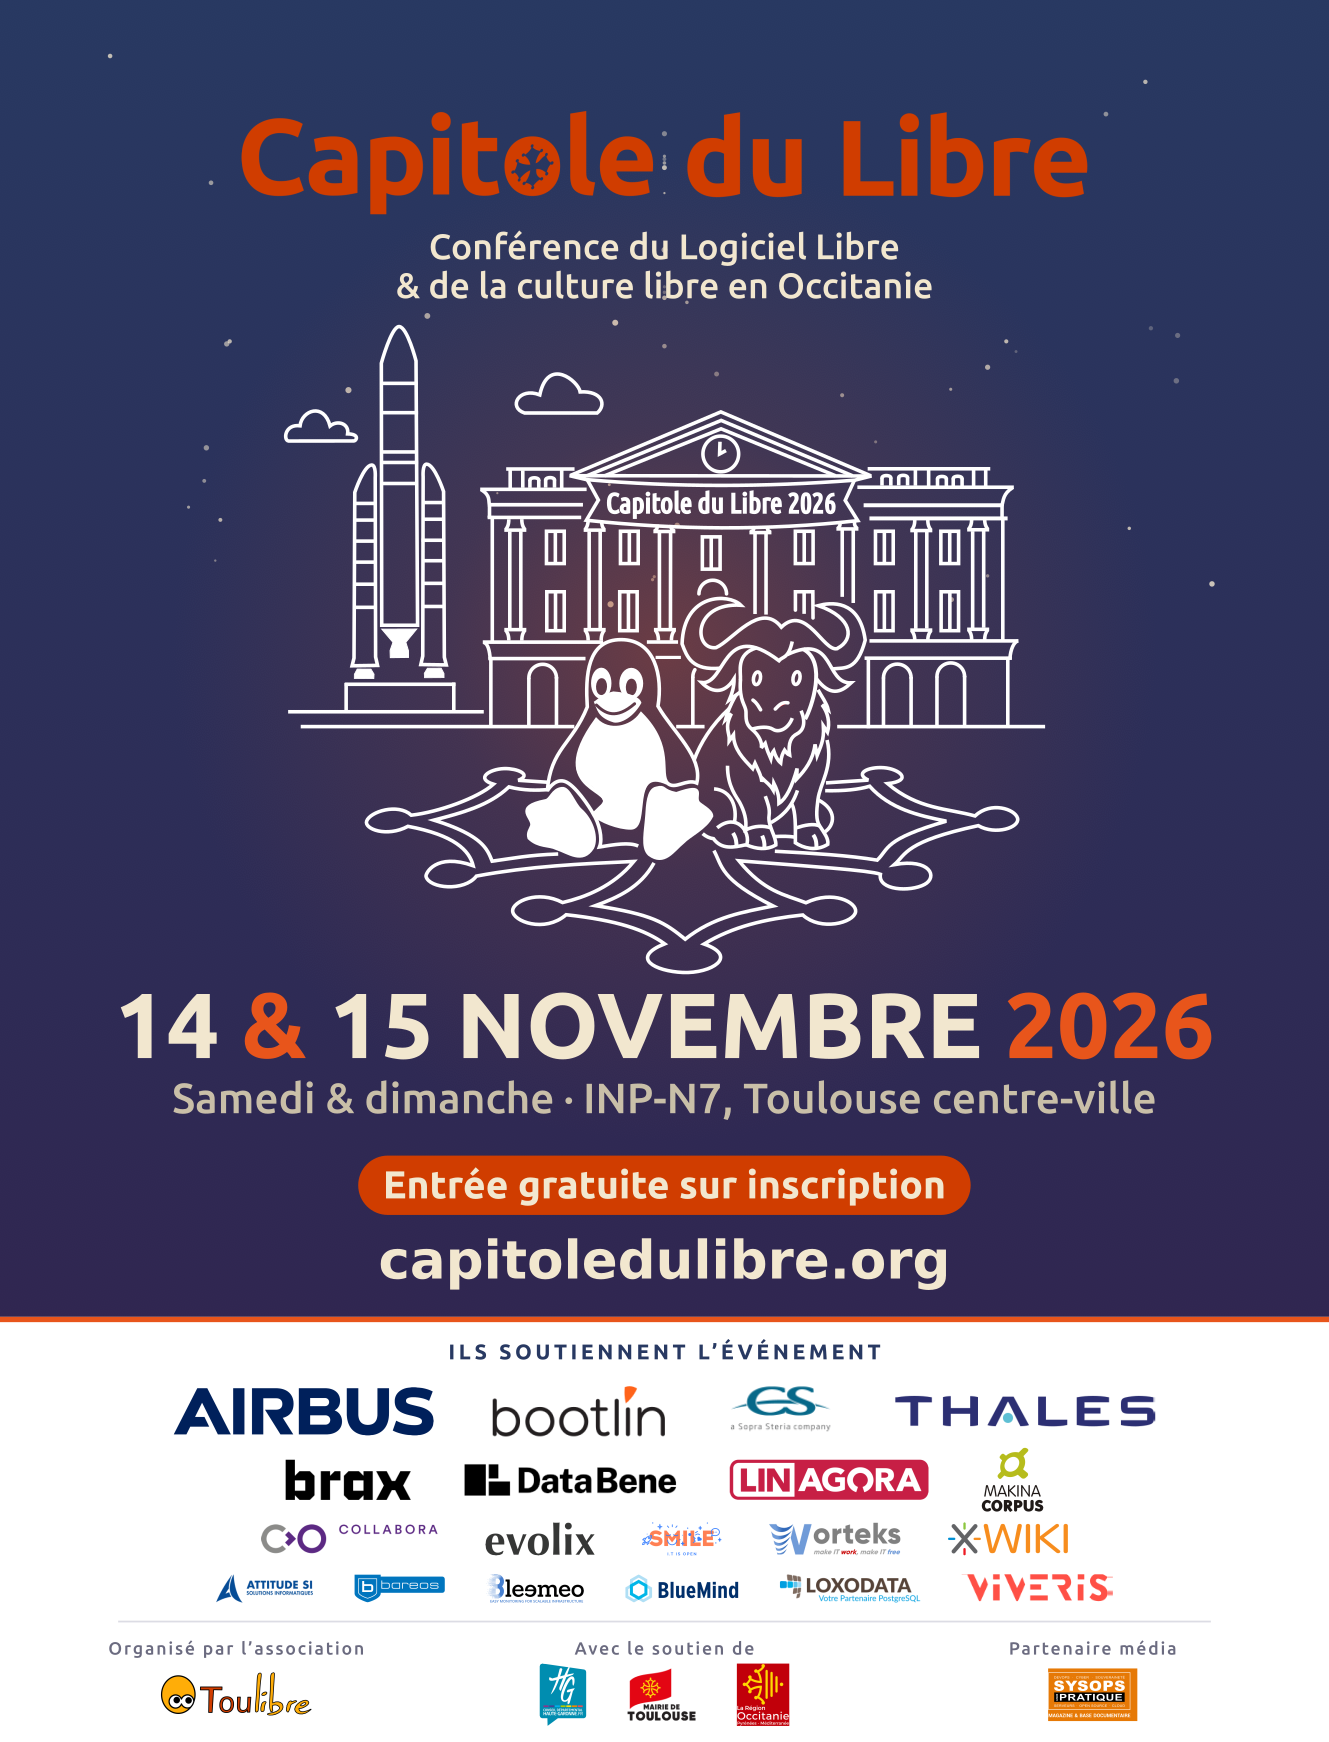
Affiche

En un mot

Avec le Capitole du Libre, plongez dans l’univers du libre sous toutes ses formes : un lieu de découvertes, de rencontres et de partages.
Réservez votre week-end : inscrivez-vous gratuitement et venez vivre le numérique autrement !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  •  

Bilan du groupe Transcriptions : 15 transcriptions publiées en octobre 2026

Quinze transcriptions ont été publiées au mois d'octobre 2026, ce qui correspond à 13 heures et 17 minutes d’enregistrements audio ou de vidéos.

Une fois par mois, les auditrices et auditeurs de Libre à vous ! sont conviés Au café libre. Une équipe, dite de choc, commente des articles récents, de divers médias, concernant l'actualité du logiciel libre et des libertés informatiques.

Lors du Café libre du 20 octobre, Maud Royer avait proposé un article intitulé « Résolution 5 de la 28e Conférence générale des poids et mesures (2026) - Sur les actions techniques requises pour assurer la continuité de l’UTC. »
Maud a donné des explications très complètes concernant le temps UTC et le rôle joué par le Bureau international des poids et mesures, mais elle constate, une peu amèrement que « des décisions qui touchent vraiment plus à l’informatique même, des choses qui ont de l’impact sur l’informatique mais qui, en soi, sont générales, sont de plus en plus le fait non pas des chercheurs de la recherche publique mais de salariés des GAFAM. Les standards sont de plus en plus définis par des gens qui y ont directement intérêt. En fait, il n’y a pas un représentant d’une université française, d’une université chinoise, d’une université américaine, il y a un salarié de Google, un salarié de Facebook et un salarié de..., etc., qui se mettent d’accord sur quel va être le nouveau protocole utilisé par les navigateurs. »

N'hésitez pas à lire, voire relire, la transcription de cette intervention de Maud Royer.

La liste des transcriptions publiées au mois d'octobre 2026 est disponible sur le site Libre à lire !.

Participer aux transcriptions

Rejoindre le groupe Transcriptions de l'April !

Suivre les publications

Pour vous tenir informé, consultez cette page.

  •  

Applis d'alerte piratées - FR-Alert est-il à l'abri ?

Je suis rentré de vacances hier et je pensais me remettre rapidement à écrire mais de l'administratif en retard en a décidé autrement... Mais peu importe, d'autres ont des soucis plus importants, vous allez voir...

En effet, ce 1er novembre, à 22 h 47 précisemment, l'appli ukrainienne Air Alert, utilisée pour alerter les Ukrainiens afin qu'ils se mettent à l'abri, s'est mise à envoyer n'importe quoi !! Alerte aérienne critique sur tout le pays, et pour les habitants de Kiev en cadeau bonus une menace radiologique, une attaque chimique et des combats de rue.

L'un des messages, écrit en russe, annonçait même une alerte nucléaire imminente en ajoutant que c'était l'Oreshnik, un missile russe, qui arrivait... brrrrr les gens ont du tellement flipper. D'après un communiqué ukrainien relayé par la BBC, le signal "radiation" s'est aussi déclenché sur des haut-parleurs de la région de Lviv au nord de l'Ukraine. Heureusement, très rapidement les développeurs ont coupé les notifications push et ont suspendu l'appli.

Les alertes (écrites en russe !!) reçues par les Ukrainiens (source : BBC)

Quelques heures plus tard, tôt ce matin, c'était au tour du ministère russe des Situations d'urgence d'annoncer une "cyberattaque massive" sur sa propre appli. D'après le Kyiv Post , ces fausses alertes parlaient d'ogives nucléaires lancées vers toutes les régions de Russie. Elles sont aussi apparues sur des canaux régionaux du ministère sur Max, la messagerie soutenue par l'État .

Donc voilà, grosse nuit de frayeurs pour tous les civils russes et ukrainiens...

Alors qui se trouve derrière ces hacks ?

Hé bien d'après l' Associated Press , un des faux messages ukrainiens citait un groupe baptisé Hitcore, et Mash, une chaîne Telegram russe liée aux services de sécurité. L'AP a échangé avec l'un de ses représentants, qui a revendiqué l'attaque. Côté russe, la BBC rapporte que le média ukrainien UNN cite Atesh, un groupe de partisans ukrainiens qui serait à l'origine de l'opération mais rien de tout ça n'a pu être vérifié.

Quant au "comment", on n'en sait pas plus...

Les dev d'Air Alert parlent de personnes non autorisées , le ministère russe d'une vulnérabilité de son appli mais chacun assure par contre que l'essentiel a tenu... Heureusement, en Ukraine, l'appli est séparée des systèmes de commandement militaire, et pour le ministère russe, ce n'est qu'un service annexe à côté des sirènes et des SMS.

Du coup, je me suis demandé : Et en France, ça se passe comment ?

Ici, FR-Alert fonctionne depuis juin 2022 et vous n'avez rien à installer. C'est le ministère de l'Intérieur ou une préfecture qui déclenche l'alerte via un système dont le partenaire technologique est Intersec , et ce sont ensuite les antennes des opérateurs qui la diffusent sur un canal radio dédié, avec au besoin des SMS géolocalisés en complément. Le message s'affiche alors en quelques secondes, même sur votre téléphone verrouillé, sauf s'il est éteint ou en mode avion.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Comme ce n'est pas une application, il n'y a donc pas de notifications push à détourner. Mais le système n'est pas infaillible pour autant... le Brésil, qui a un système similaire au notre, s'est fait hacker en juin et une dizaine de fausses alertes sonores sont parties mentionnant entre autre une "invasion extraterrestre"... L'alerte a réveillé plusieurs villes soit environ 30 millions d'habitants, d'après l' Agência Brasil .

Putain, j'imagine pas ma tête à 3h du mat avec une alerte comme ça sur mon téléphone qui me dit que les aliens ont débarqué...

D'après des documents de la Défense civile transmis à la police fédérale et publiés par Metrópoles , les messages sont partis de la plateforme officielle, l'Idap, avec les identifiants de deux agents de la Défense civile du Pará, et avec des indices que la plateforme les a laissés viser des villes hors de leur zone. Ensuite, fin juin, le gouvernement Brésilien a alors coupé l'accès externe à la plateforme et imposé un second facteur d'authentification. Ouf !! J'espère que chez nous, y'a une 2FA en place aussi là dessus... CE SERAIT BIEN, HEIN !

Le canal radio à l'ancienne a aussi sa faiblesse, mais elle reste locale puisqu'en 2019, des chercheurs de l' université du Colorado ont montré en labo qu'une fausse antenne pouvait diffuser une fausse alerte présidentielle américaine. Selon eux, avec des émetteurs du commerce, ça toucherait environ 90 % des téléphones à portée de la surface d'un stade.

Donc voilà... je ne dis pas que ça n'arrivera jamais, ça peut arriver. En plus, comme ces alertes peuvent embarquer un lien, vaut mieux vérifier avant de cliquer.

Source : BBC

  •  

Revue de presse de l’April pour la semaine 44 de l’année 2026

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Next] IA: la Linux Foundation constate l'épuisement croissant des contributeurs

✍ Vincent Hermann, le .

Quel effet produit l’IA sur le développement open source ? Selon un rapport de la Linux Foundation, il est conséquent, entre augmentation de la production brute, abaissement du ticket d’entrée, obligation plus intense de relecture et épuisement d’une partie des personnes impliquées.

[LaDepeche.fr] La Cour des comptes alerte: 100 millions d'euros dépensés par l'État pour Microsoft, des économies possibles avec des logiciels libres

✍ Philippe Rioux, le .

Parler de souveraineté numérique, c’est bien; la mettre en pratique, c’est mieux. Et cela est d’autant plus vrai en ce qui concerne l’État. Telle est la vision de la Cour des comptes qui vient de publier un rapport sur “Les outils bureautiques et collaboratifs au sein de l’État”. À la suite d’une campagne d’initiative citoyenne menée en septembre 2024 par l’institution de la rue Cambon, celle-ci s’est intéressée aux suites bureautiques (traitement de texte, tableur, supports de présentation) et aux logiciels collaboratifs (messageries électroniques ou instantanées, visioconférences, partages de documents, etc.) dans les administrations centrales et déconcentrées de l’État. Ce qui représente rien moins que 860 000 postes de travail informatique.

  •  
❌